
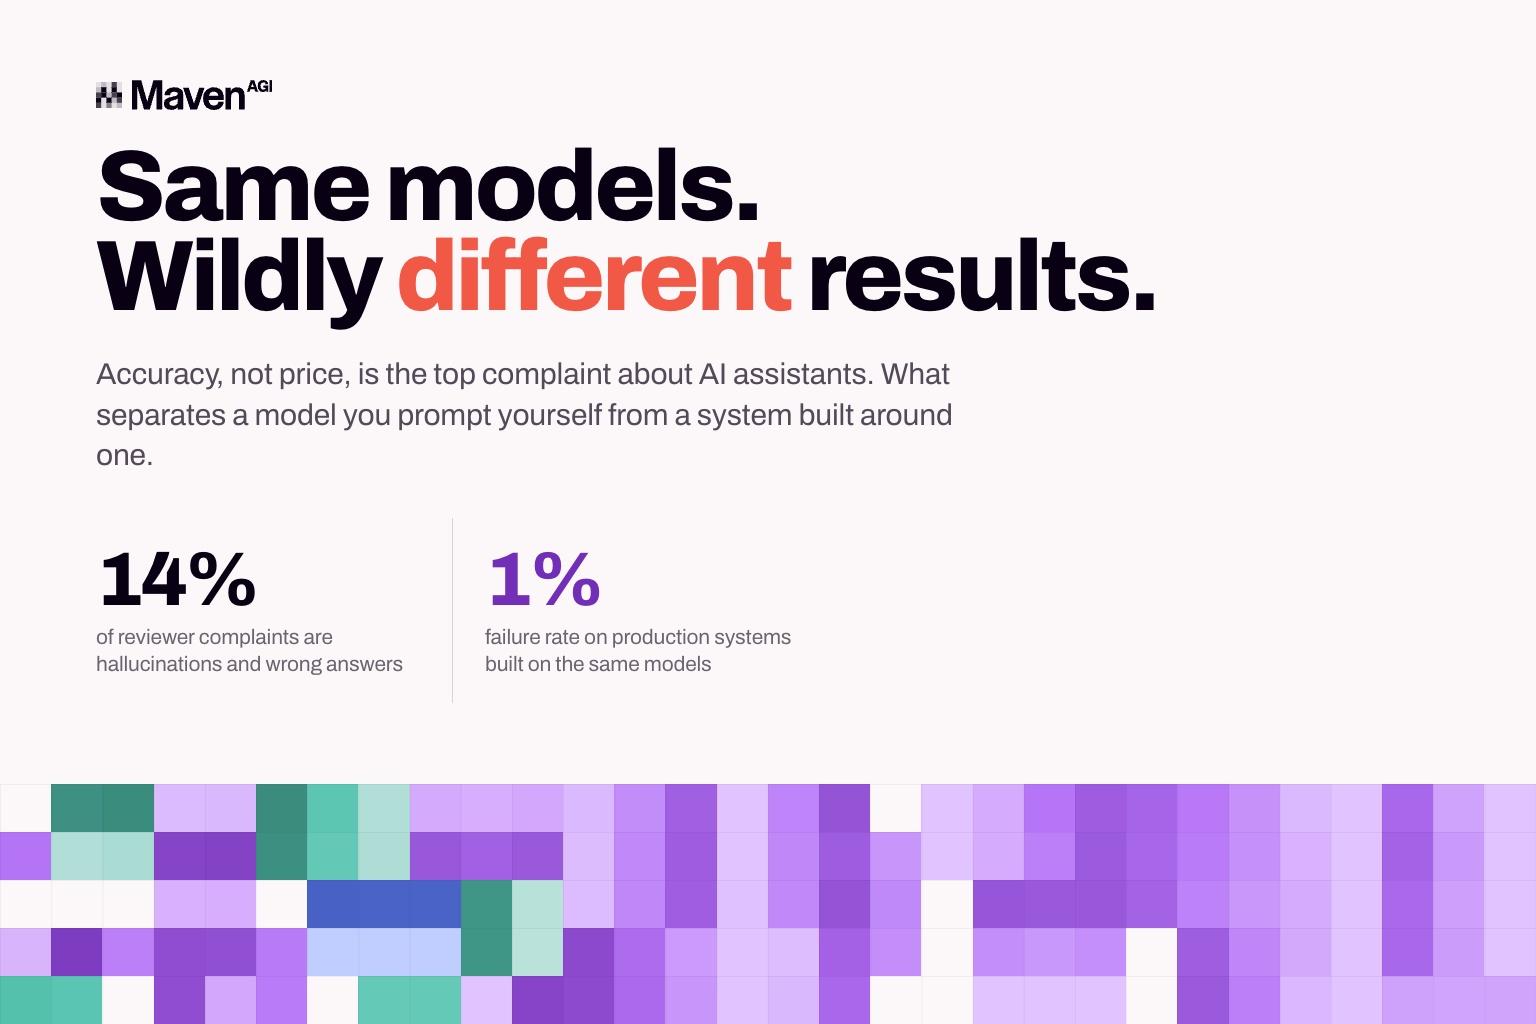
G2は1月から7月中旬にかけて2,950件を超える検証済みレビューを分析し、ユーザーが最も不満に感じている点を調べました。最大の不満は価格ではなく精度でした。ハルシネーションや誤った回答は、レビュアーが挙げた不満全体の14%を占めています。誰もがコストばかりを議論している年に、コストを上回る結果となりました。
この数字の意味を正しく理解するには、レビュアーがどのような人たちなのかを知る必要があります。その多くが語っているのは、誰もがブラウザのタブで開いている汎用アシスタントについてです。本番環境で稼働するサポートエージェントについて語るCXチームではありません。モデルに質問し、自信満々の回答を受け取り、それが正しいかどうかを自分で確かめなければならない人たちです。
次にG2は、同じモデルを基盤に本番システムを構築しているベンダー4社に、実際の失敗率を尋ねました。答えは、低いところで1%でした。
つまり、ここで比較されているのはモデル同士ではありません。自分でプロンプトを入力して使うモデルと、誰かがモデルを中心に構築したシステムとの比較です。基盤となる技術は同じでも、結果は大きく異なります。Mavenは、G2が話を聞いた4社のうちの1社です。
この差を生んでいるもの
4社が語った内容は、どのモデルを選んだかとはまったく関係がありませんでした。各社ともほぼ同じことを述べています。システムは一度の処理で完結させるのではなく、段階的に動作させる。回答は、モデルが学習時にたまたま覚えた内容ではなく、ライブデータから取得する。タスクが実際に完了する割合を評価し、プロンプトやロジックを少なくとも週1回は書き直す。1社は毎日行っています。いずれもモデルそのものではなく、モデルの周辺で行われる作業です。
さらに示唆に富むのは、労力をどこに注ぐかについて4社の意見が一致していたことです。4社とも、難しいのは日常的な質問ではなく、エッジケースや複数ステップのタスクだと述べています。そのため、自らの手に負えない状況を察知し、推測で答えるのではなく人に会話を引き継ぐシステムを構築しています。調査におけるMavenのコメントは、「信頼できるフォールバックロジックのない自律性は、機能ではなくリスクである」というものでした。
差の大部分はここにあります。自分でモデルを使う場合、その出力を確認するのは自分自身です。本番システムは、その役割が決して顧客に回らないように構築されています。G2ははっきりとこう述べています。これらのベンダーは失敗が少ないのではなく、誰かが気づく前に失敗を捕捉しているのだ、と。
エージェントかチャットボットかという議論は、ほとんど言葉の問題
G2は4社に、AIエージェントは、このカテゴリーでいまだにチャットボットと呼ばれているものより信頼性が高いのかを率直に尋ねました。4社の答えはほぼ同じで、この言葉を売りにしている企業にとっては歓迎できない内容です。本番環境では、両者の違いはマーケティングが示唆するほど大きくなく、呼び名を変えるだけでは何も解決しないというのです。
これはベンダーよりも購入者にとって重要な点です。「エージェント」という言葉を基準に製品を探しているなら、機能ではなくラベルを買っていることになります。あるベンダーが製品をエージェントと呼び、別のベンダーが別の名前で呼んでいても、どちらが最新のナレッジを参照するのか、確信がないときにそれを自覚できるのか、ローンチ後に実際の会話に照らして検証されているのかは何もわかりません。これらはカスタマーサービスにおけるエージェンティックAIの特性であり、ラベルと一緒に付いてくるものは1つもありません。
本当に判断材料になるのは、どのように構築されているかに関する質問です。次の5つは、すべて初回の打ち合わせで確認できます。
- 回答はどこから来るのか。ライブのナレッジを参照しているのか、それともモデルが学習で吸収した内容に頼っているのか。
- 確信がないときはどうなるのか。人に引き継ぐのか、それとも正しいときと同じ自信に満ちた口調で推測するのか。
- 実際の会話に照らして回答を確認する頻度はどれくらいか。また、何を測定しているのか。
- 自社チームでエージェントの動作を変更できるのか、それとも調整のたびにベンダーに依頼する必要があるのか。
- 自社のシステム内で実際にアクションを実行できるのか、それとも顧客にやるべきことを伝えるだけなのか。
5つすべてに答えられるベンダーなら、きちんと作り込まれています。最初の質問には完璧に答えても、その後があいまいになるなら、モデルを購入してウィジェットで包んだだけです。このリストの詳細版は、エンタープライズ向けカスタマーサービスのAIエージェントを評価するためのガイドでご覧いただけます。
購入者が見落としがちな部分
4社が語った内容は、Mavenの5層アーキテクチャの基盤となっている構成そのものです。モデルはそのうちの1層にすぎません。信頼性を生み出す要素はすべてその周囲にあります。エージェントが何を知っているか、何を実行できるか、稼働後にその作業をどう確認するか、そして誰がガードレールを管理するかです。購入者は通常モデルを基準に選びます。有名な名前が付いているのがその層だからです。しかし、G2のデータが指し示しているものはすべて残りの4層にあり、それこそが自律解決が単なる良い回答とは異なる理由です。
このカテゴリーの通念とは異なり、導入の速さと信頼性が相反しないのもそのためです。これらの層の構築は本格的なエンジニアリングですが、プラットフォーム内で一度行えばよく、顧客ごとのシステム環境で6か月がかりのプロジェクトになることはありません。
作り込まれたシステムがもたらす成果
Mastermindは6週間で自律解決率93%を達成しました。K1xは最初の1週間で80%に到達しました。Rhoは、人員を増やすことなく月間の問い合わせ数が12%増加する中で、CSAT 95%を維持しました。QuestはMaven上でAskQを構築し、データ移行なしで既存のナレッジベースとケース管理システムに接続しました。評価の基準はディフレクションではなく顧客満足度です。
Maven自身のレビューも同じ傾向を示しています。20件の検証済みレビューで5点満点中4.8点を獲得しており、ユーザーが実際に挙げている点は一読の価値があります。チャット、メール、音声を別々のボットで同期させるのではなく、1つのエンジンで処理できること。最初に見つけた記事をもとに回答するのではなく、古い記事、重複する記事、矛盾する記事を検出するナレッジ検索。SalesforceやZendesk上で数日のうちにセットアップできること。いずれもモデルの周辺にある要素です。
8月25日に発表されたG2の2026年秋レポートで、MavenはCustomer Service Automation部門のMid-Market Grid、AI Customer Support Agents部門のMid-Market Results Index、そしてAI Customer Support Agents部門のImplementation Indexに選出されました。Indexレポートは、企業の規模や知名度ではなく、得られた成果や導入プロセスについての顧客の声に基づいています。G2のより広範なデータが、ほかのあらゆる場所で問題になっていると示している、まさにその点を測定しているのです。
差こそが本質
注目すべき数字は14%と1%の差です。どちらも同じ一握りのモデルの上に成り立っているからです。技術だけでは、これほど大きな差は説明できません。差を生むのは、顧客の目に触れる前に誤った回答を捕捉する仕組みを誰かがきちんと構築したかどうかです。だからこそ、解決率は、その測定方法がわかって初めて意味を持ちます。
ほとんどの購入者は、いまだにモデル名を比較しています。G2が話を聞いた4社は、とうにそれをやめています。
各層について読むだけでなく実際にご覧になりたい方は、デモを予約してください。
自社の会話でお試しください。
無料の個別デモをお申し込みください。


