
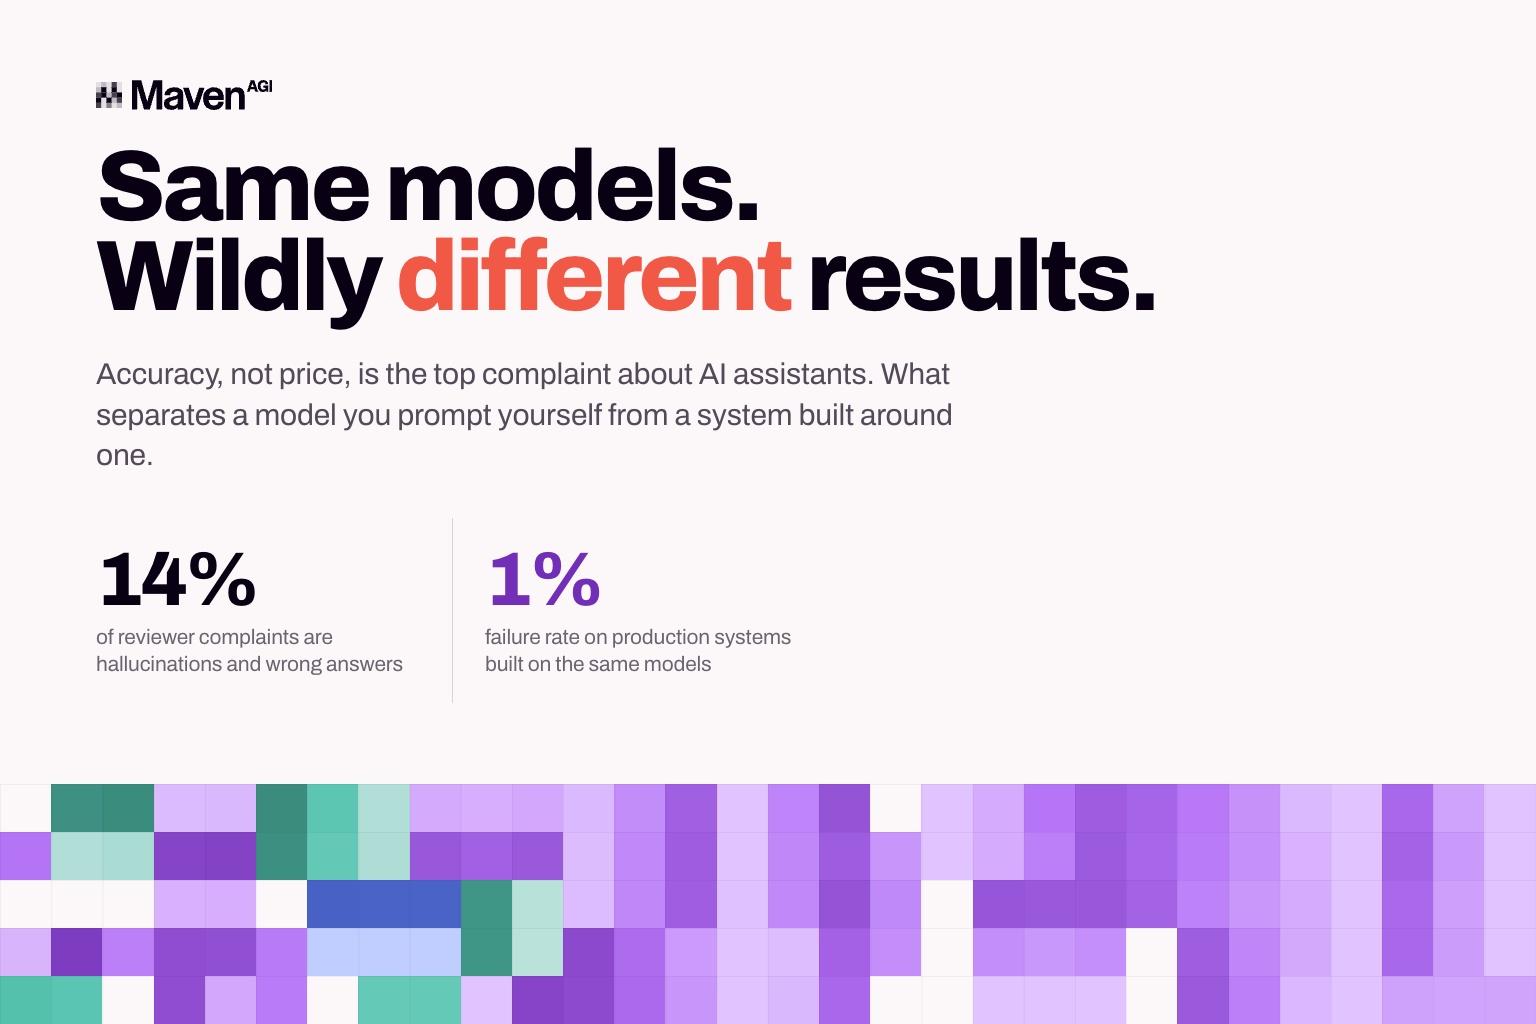
G2 đã đọc hơn 2.950 đánh giá đã xác minh từ tháng 1 đến giữa tháng 7 để tìm hiểu người dùng phàn nàn nhiều nhất về điều gì. Phàn nàn lớn nhất là độ chính xác, không phải giá cả. Hiện tượng ảo giác và câu trả lời sai chiếm 14% tổng số điều người đánh giá không hài lòng, vượt lên trên cả chi phí, trong một năm mà ai cũng chỉ muốn tranh luận về chi phí.
Cần biết những người đánh giá này là ai, vì điều đó thay đổi ý nghĩa của con số. Phần lớn họ nói về các trợ lý đa năng mà ai cũng mở sẵn trên một tab trình duyệt. Họ không phải các đội CX nói về một tác tử hỗ trợ đang vận hành thực tế. Họ là những người hỏi mô hình một câu, nhận về một câu trả lời đầy tự tin, rồi phải tự xác minh xem nó có đúng không.
Sau đó, G2 hỏi 4 nhà cung cấp đang xây dựng hệ thống production trên chính những mô hình đó về tỷ lệ lỗi thực tế của họ. Con số có thể thấp tới 1%.
Vậy thứ thực sự đang được so sánh không phải là mô hình này với mô hình khác. Đó là một mô hình bạn tự prompt so với một hệ thống được xây dựng quanh mô hình: cùng công nghệ bên dưới, kết quả khác nhau một trời một vực. Maven là 1 trong 4 nhà cung cấp được G2 hỏi.
Điều gì tạo nên khoảng cách
Không điều gì trong mô tả của 4 nhà cung cấp đó liên quan đến việc họ chọn mô hình nào. Tất cả đều nói gần như cùng một điều. Hệ thống của họ làm việc theo từng bước thay vì xử lý trong một lượt. Câu trả lời được lấy từ dữ liệu trực tiếp thay vì những gì mô hình tình cờ nhớ được từ quá trình huấn luyện. Họ đo lường tần suất một tác vụ thực sự được hoàn thành, và viết lại prompt cùng logic ít nhất mỗi tuần 1 lần. Một nhà cung cấp còn làm việc này hằng ngày. Tất cả đều là công việc làm quanh mô hình, chứ không phải can thiệp vào mô hình.
Điểm đồng thuận hữu ích hơn là nỗ lực được dồn vào đâu. Cả 4 đều cho rằng phần khó không nằm ở những câu hỏi thường ngày, mà ở các trường hợp ngoại lệ và tác vụ nhiều bước, nên họ xây dựng hệ thống biết nhận ra khi vượt quá khả năng và chuyển cuộc hội thoại cho con người thay vì đoán mò. Quan điểm của Maven trong khảo sát là: “quyền tự chủ mà không có logic dự phòng đáng tin cậy thì không phải là tính năng, mà là rủi ro.”
Đó gần như là toàn bộ khoảng cách. Khi tự prompt một mô hình, bạn là người kiểm tra kết quả của nó. Một hệ thống production được xây dựng để việc đó không bao giờ rơi vào tay khách hàng. G2 nói thẳng: các nhà cung cấp này không gặp ít lỗi hơn, mà họ phát hiện lỗi trước khi bất kỳ ai nhận ra.
Cuộc tranh luận agent hay chatbot phần lớn chỉ là chuyện từ ngữ
G2 hỏi thẳng 4 nhà cung cấp rằng tác tử AI có đáng tin cậy hơn những gì ngành vẫn gọi là chatbot hay không. Tất cả đều trả lời gần giống nhau, và đó không phải tin vui cho những ai bán hàng dựa vào cái tên. Trong môi trường production, hai loại này không khác nhau nhiều như marketing vẫn gợi ý, và việc đổi nhãn này sang nhãn kia tự nó không giải quyết được gì.
Điều này quan trọng với người mua hơn là với nhà cung cấp. Nếu bạn đi tìm từ “agent”, bạn đang mua một cái nhãn chứ không phải một năng lực. Việc một nhà cung cấp gọi sản phẩm là agent, còn nhà cung cấp khác gọi bằng tên khác, không cho bạn biết gì về việc sản phẩm có tra cứu nguồn tri thức hiện hành của bạn, có nhận ra khi không chắc chắn, hay có được đối chiếu với các cuộc hội thoại thực tế sau khi triển khai hay không. Đó là những đặc tính của AI dạng tác tử trong dịch vụ khách hàng, và không đặc tính nào tự đi kèm với cái nhãn.
Những câu hỏi thực sự có giá trị là về cách sản phẩm được xây dựng, và bạn có thể hỏi cả 5 câu ngay trong buổi trao đổi đầu tiên.
- Câu trả lời đến từ đâu? Hệ thống tra cứu nguồn tri thức trực tiếp của bạn, hay dựa vào những gì mô hình đã học khi huấn luyện?
- Điều gì xảy ra khi hệ thống không chắc chắn? Nó chuyển giao cho người, hay đoán với cùng giọng tự tin như khi trả lời đúng?
- Bao lâu thì có người đối chiếu câu trả lời của nó với các cuộc hội thoại thực tế, và họ đo lường điều gì?
- Đội ngũ của bạn có thể thay đổi cách tác tử hoạt động, hay mọi điều chỉnh đều phải thông qua nhà cung cấp?
- Hệ thống có thực sự thao tác được trong các hệ thống của bạn, hay chỉ có thể hướng dẫn khách hàng tự làm?
Nếu nhà cung cấp trả lời được cả 5 câu, nghĩa là họ đã thực sự làm phần việc đó. Nếu họ trả lời trôi chảy câu đầu rồi mơ hồ dần ở các câu sau, họ chỉ mua một mô hình rồi bọc thêm một widget. Danh sách chi tiết hơn có trong hướng dẫn của chúng tôi về đánh giá tác tử AI cho dịch vụ khách hàng doanh nghiệp.
Những phần người mua thường bỏ qua
Những gì 4 nhà cung cấp mô tả chính là nền tảng của kiến trúc 5 lớp của Maven. Mô hình chỉ là 1 lớp. Mọi thứ làm nên độ tin cậy nằm xung quanh nó: tác tử biết gì, được phép làm gì, cách bạn kiểm tra kết quả khi đã vận hành, và ai nắm giữ các cơ chế kiểm soát. Người mua thường chọn theo mô hình, vì đó là lớp gắn với những cái tên nổi tiếng. Mọi điều dữ liệu của G2 chỉ ra đều nằm ở 4 lớp còn lại, và đó là lý do giải quyết tự động khác với một câu trả lời hay.
Đó cũng là lý do triển khai nhanh và độ tin cậy không hề đối lập, bất kể ngành vẫn mặc định thế nào. Xây dựng các lớp đó là công việc kỹ thuật thực sự, nhưng chỉ cần làm 1 lần, bên trong nền tảng, thay vì trở thành dự án 6 tháng trong hệ thống của từng khách hàng.
Kết quả khi phần việc đã được làm đến nơi đến chốn
Mastermind đạt tỷ lệ giải quyết tự động 93% trong 6 tuần. K1x đạt 80% ngay tuần đầu tiên. Rho duy trì CSAT 95% trong khi tiếp nhận thêm 12% lượt liên hệ mỗi tháng mà không cần tuyển thêm người. Quest xây dựng AskQ trên Maven, kết nối với cơ sở tri thức và hệ thống quản lý yêu cầu sẵn có mà không cần di chuyển dữ liệu, và đánh giá hiệu quả dựa trên mức độ hài lòng của khách hàng thay vì tỷ lệ chuyển hướng.
Chính các đánh giá về Maven cũng cho thấy điều tương tự. 4,8/5 từ 20 đánh giá đã xác minh, và những gì người dùng thực sự nhắc đến rất đáng đọc: 1 công cụ duy nhất xử lý chat, email và thoại thay vì nhiều bot riêng lẻ phải đồng bộ với nhau; truy xuất tri thức có gắn cờ các bài viết lỗi thời, trùng lặp và mâu thuẫn thay vì trả lời từ bài nào tìm thấy trước; thời gian thiết lập tính bằng ngày trên nền Salesforce hoặc Zendesk. Tất cả đều là những thứ xung quanh mô hình.
Trong các báo cáo Mùa Thu 2026 của G2, công bố ngày 25 tháng 8, Maven có mặt trong Mid-Market Grid hạng mục Customer Service Automation, Mid-Market Results Index hạng mục AI Customer Support Agents và Implementation Index hạng mục AI Customer Support Agents. Các báo cáo Index dựa trên phản hồi của khách hàng về kết quả đạt được và quá trình triển khai, chứ không dựa trên quy mô hay độ nổi tiếng của công ty. Chúng đo lường chính xác điều mà dữ liệu tổng thể của G2 cho thấy đang trục trặc ở mọi nơi khác.
Khoảng cách mới là câu chuyện chính
Con số đáng chú ý là khoảng cách giữa 14% và 1%, vì cả hai đều dựa trên cùng một nhóm nhỏ các mô hình. Không yếu tố công nghệ nào giải thích được khoảng cách lớn như vậy. Điều giải thích được là liệu có ai chịu xây dựng những phần giúp phát hiện câu trả lời sai trước khi khách hàng nhìn thấy, và đó là lý do tỷ lệ giải quyết chỉ có ý nghĩa khi bạn biết nó được đo như thế nào.
Phần lớn người mua vẫn đang so sánh tên mô hình. 4 nhà cung cấp mà G2 trao đổi đã từ bỏ cách làm đó từ lâu.
Nếu bạn muốn tận mắt thấy các lớp này thay vì chỉ đọc về chúng, hãy đặt lịch demo.
Trải nghiệm trên chính các cuộc hội thoại của bạn.
Yêu cầu demo cá nhân hóa miễn phí.


