
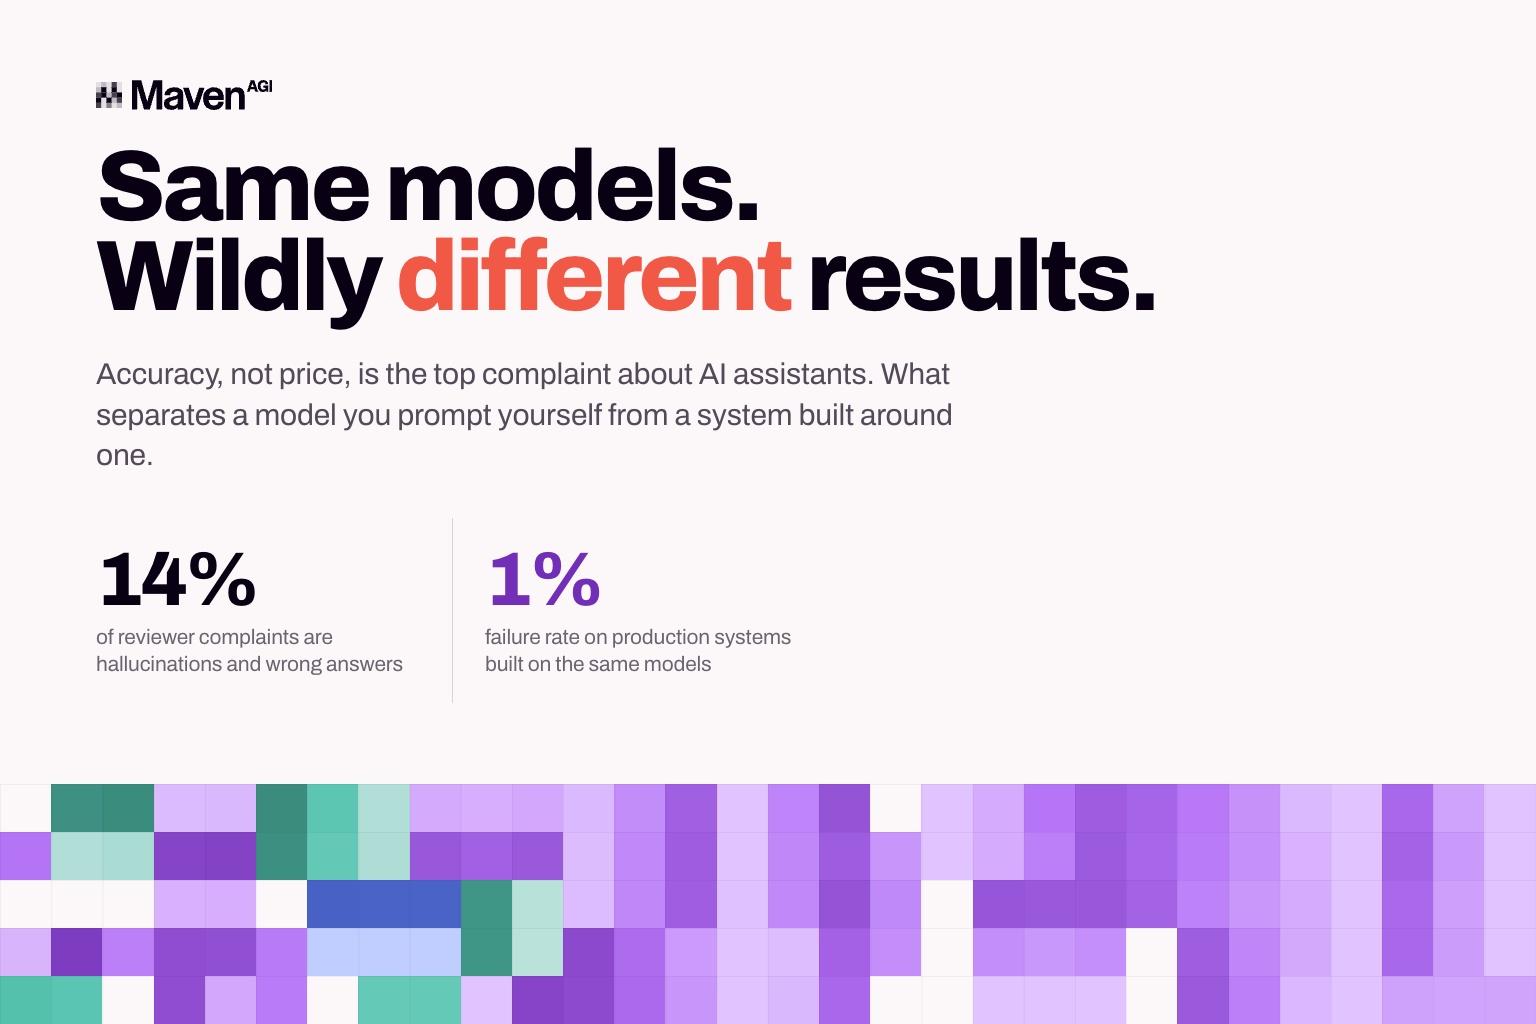
A G2 analisou mais de 2.950 avaliações verificadas, publicadas entre janeiro e meados de julho, para descobrir do que as pessoas mais reclamam. A maior queixa foi a precisão, não o preço. Alucinações e respostas erradas representaram 14% de tudo o que os avaliadores disseram não gostar. Isso coloca o problema à frente do custo, num ano em que o custo é o único assunto que todo mundo quer discutir.
Vale saber quem são esses avaliadores, porque isso muda o que o número significa. A maioria fala dos assistentes de uso geral que todo mundo deixa aberto numa aba do navegador. Não são equipes de CX descrevendo um agente de suporte em produção. São pessoas que perguntam algo a um modelo, recebem uma resposta cheia de confiança e depois precisam descobrir sozinhas se é verdade.
Depois, a G2 procurou 4 fornecedores que constroem sistemas em produção sobre esses mesmos modelos e perguntou como são, de fato, suas taxas de falha. A resposta: chegam a apenas 1%.
Ou seja, a comparação real não é entre um modelo e outro. É entre um modelo que você mesmo instrui e um sistema que alguém construiu em torno de um modelo: a mesma tecnologia por baixo, resultados radicalmente diferentes. A Maven foi um dos 4 fornecedores consultados pela G2.
O que explica a diferença
Nada do que esses 4 fornecedores descreveram tinha a ver com o modelo escolhido. Todos disseram mais ou menos a mesma coisa. Seus sistemas trabalham em etapas, e não de uma só vez. As respostas vêm de dados em tempo real, e não do que o modelo por acaso lembra do treinamento. Eles medem com que frequência uma tarefa é realmente concluída e reescrevem prompts e lógica pelo menos uma vez por semana. Um deles faz isso todo dia. Todo esse trabalho é feito em torno do modelo, não no modelo.
O ponto de acordo mais útil é onde vai o esforço. Os 4 disseram que a parte difícil não é a pergunta do dia a dia, e sim o caso atípico e a tarefa de várias etapas. Por isso, constroem sistemas que percebem quando estão fora da sua alçada e passam a conversa para uma pessoa em vez de chutar. A frase da Maven na pesquisa foi que “autonomia sem uma lógica de fallback confiável não é um recurso; é um risco.”
Aí está a maior parte da diferença. Quando você mesmo instrui um modelo, é você quem confere o trabalho dele. Um sistema em produção é construído para que essa tarefa nunca recaia sobre o cliente. A G2 disse com todas as letras: esses fornecedores não têm menos falhas; eles as identificam antes que alguém perceba.
O debate agente versus chatbot é, em grande parte, uma questão de palavras
A G2 perguntou diretamente aos 4 fornecedores se agentes de IA são mais confiáveis do que aquilo que a categoria ainda chama de chatbots. Todos responderam mais ou menos a mesma coisa, e não é uma boa notícia para quem vende com base no termo. Em produção, os dois não são tão diferentes quanto o marketing sugere, e trocar um rótulo pelo outro não resolve nada por si só.
Isso importa mais para quem compra do que para quem vende. Se você está procurando a palavra “agente”, está comprando um rótulo, não uma capacidade. Um fornecedor chamar seu produto de agente e outro chamá-lo de outra coisa não diz nada sobre se algum deles consulta seu conhecimento atualizado, percebe quando não tem certeza ou é avaliado com conversas reais depois do lançamento. Essas são propriedades da IA agêntica no atendimento ao cliente, e nenhuma delas vem junto com o rótulo.
As perguntas que realmente dizem algo são sobre como a solução é construída, e você pode fazer as 5 já na primeira conversa.
- De onde vêm as respostas? Ele consulta seu conhecimento em tempo real ou se baseia no que o modelo absorveu no treinamento?
- O que acontece quando ele não tem certeza? Ele transfere a conversa ou chuta com o mesmo tom confiante que usa quando acerta?
- Com que frequência alguém verifica as respostas dele com conversas reais, e o que está sendo medido?
- Sua equipe consegue mudar o comportamento do agente ou todo ajuste precisa passar pelo fornecedor?
- Ele consegue realmente executar ações nos seus sistemas ou só consegue dizer ao cliente o que fazer?
Se um fornecedor consegue responder às 5, alguém fez o trabalho. Se ele acerta a primeira e fica vago depois, comprou um modelo e colocou um widget em volta. Há uma versão mais longa desta lista no nosso guia sobre como avaliar agentes de IA para atendimento ao cliente corporativo.
O que os compradores deixam passar
O que esses 4 fornecedores descreveram é a mesma base sobre a qual a arquitetura de 5 camadas da Maven foi construída. O modelo é só uma camada. Tudo o que o torna confiável está ao redor dele: o que o agente sabe, o que ele tem permissão para fazer, como você verifica o trabalho dele depois que entra no ar e quem controla as proteções. Os compradores costumam escolher pelo modelo, porque é a camada com os nomes famosos. Tudo o que os dados da G2 apontam está nas outras 4, e é por isso que a resolução autônoma é algo diferente de uma boa resposta.
É também por isso que implantação rápida e confiabilidade não são opostas, ao contrário do que a categoria supõe. Construir essas camadas é engenharia de verdade, mas isso acontece uma única vez, dentro da plataforma, em vez de virar um projeto de 6 meses na stack de cada cliente.
Como fica quando o trabalho foi bem feito
A Mastermind chegou a 93% de resolução autônoma em 6 semanas. A K1x atingiu 80% já na primeira semana. A Rho manteve 95% de CSAT enquanto absorvia 12% mais contatos por mês, sem contratar ninguém. A Quest construiu o AskQ sobre a Maven, conectou-o a uma base de conhecimento e a um sistema de casos que já existiam, sem migração de dados, e o avalia pela satisfação do cliente, não pela deflexão.
As avaliações da própria Maven apontam na mesma direção: 4,8 de 5 em 20 avaliações verificadas. E vale ler o que as pessoas de fato mencionam: um único mecanismo cuidando de chat, e-mail e voz, em vez de bots separados que precisam ser mantidos em sincronia; recuperação de conhecimento que sinaliza artigos desatualizados, duplicados e conflitantes, em vez de responder com o primeiro que encontrar; configuração medida em dias sobre o Salesforce ou o Zendesk. Tudo isso é o que está ao redor do modelo.
Nos relatórios Fall 2026 da G2, publicados em 25 de agosto, a Maven apareceu no Mid-Market Grid de Customer Service Automation, no Mid-Market Results Index de AI Customer Support Agents e no Implementation Index de AI Customer Support Agents. Os relatórios de índice se baseiam no que os clientes dizem sobre os resultados obtidos e sobre como foi a implantação, não no tamanho ou na fama de uma empresa. Eles medem exatamente aquilo que os dados mais amplos da G2 mostram que está dando errado em todos os outros lugares.
A diferença é a história
O número que merece atenção é a distância entre 14% e 1%, porque os dois se apoiam no mesmo punhado de modelos. Nada na tecnologia explica uma diferença tão grande. O que explica é se alguém se deu ao trabalho de construir as partes que barram uma resposta ruim antes que o cliente a veja. É por isso que uma taxa de resolução só significa algo quando você sabe como ela foi medida.
A maioria dos compradores ainda está comparando nomes de modelos. Os 4 fornecedores com quem a G2 conversou deixaram isso para trás há algum tempo.
Se você quer ver as camadas em vez de ler sobre elas, agende uma demonstração.
Veja nas suas próprias conversas.
Solicite uma demonstração personalizada gratuita.


