
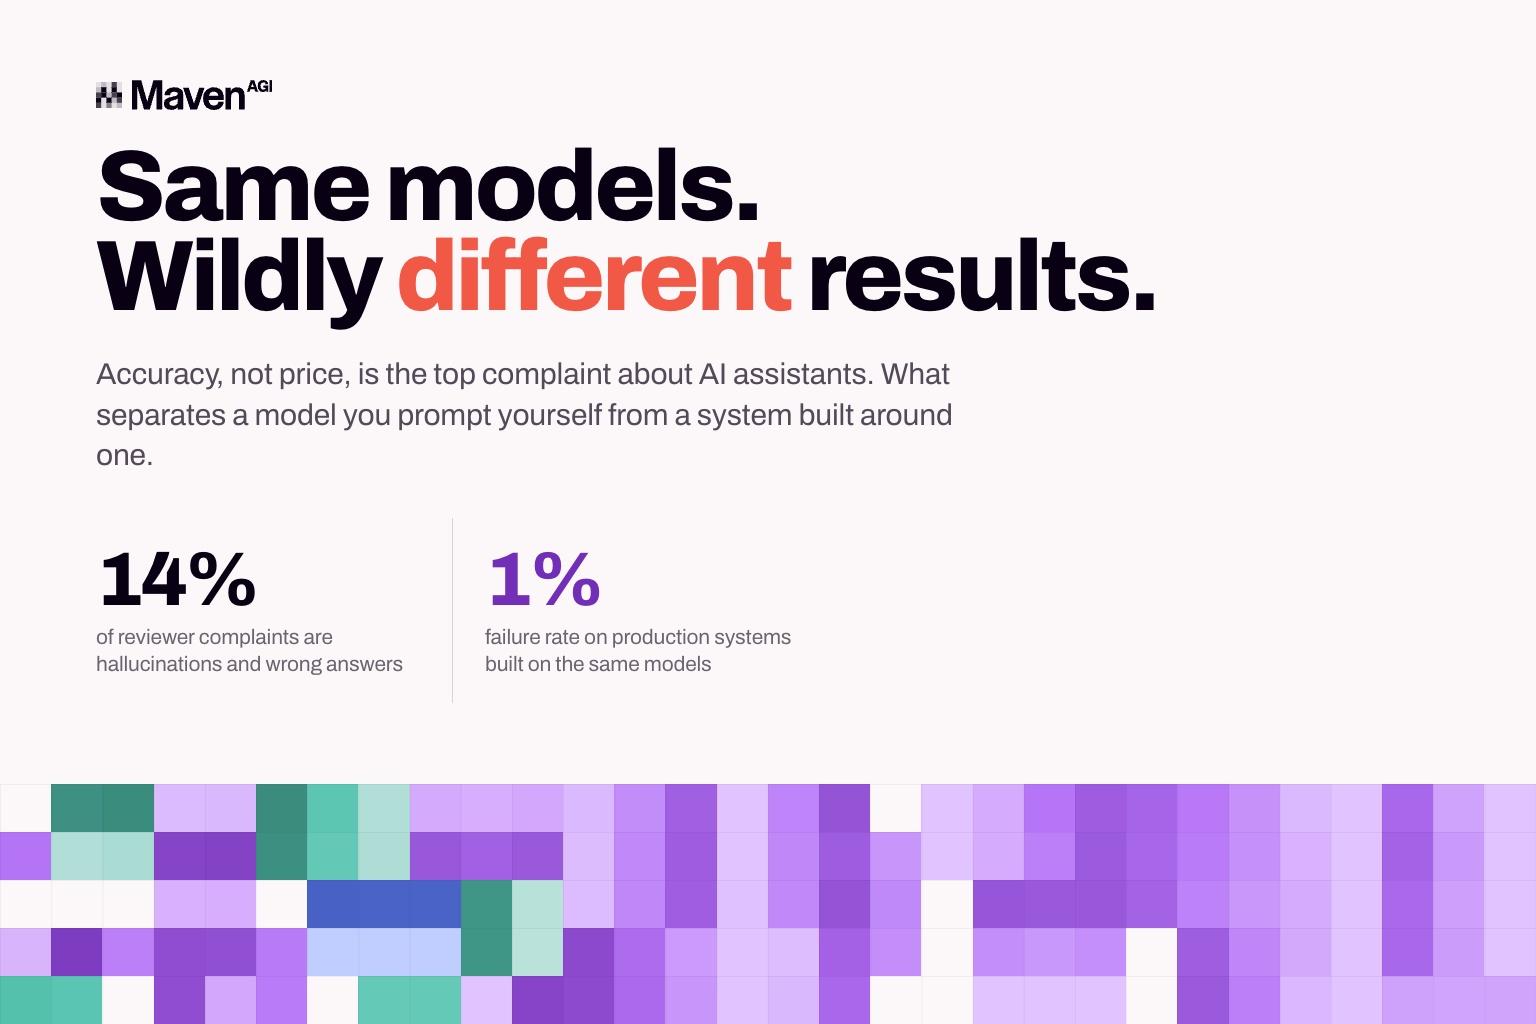
G2 hat mehr als 2.950 verifizierte Bewertungen ausgewertet, die zwischen Januar und Mitte Juli erschienen sind, und gefragt, worüber sich Nutzer am häufigsten beschweren. Der größte Kritikpunkt war nicht der Preis, sondern die Genauigkeit. Halluzinationen und falsche Antworten machten 14 % aller Kritikpunkte aus und lagen damit vor den Kosten – in einem Jahr, in dem alle nur über Kosten streiten wollen.
Es lohnt sich, genauer hinzusehen, wer diese Bewertenden sind, denn das verändert die Aussage der Zahl. Die meisten sprechen über die Allzweck-Assistenten, die jeder in einem Browser-Tab geöffnet hat. Es sind keine CX-Teams, die einen Support-Agenten im Produktivbetrieb beschreiben. Es sind Menschen, die einem Modell eine Frage stellen, eine selbstbewusste Antwort erhalten und dann selbst herausfinden müssen, ob sie stimmt.
Anschließend fragte G2 4 Anbieter, die auf denselben Modellen produktive Systeme bauen, wie hoch ihre Fehlerquoten tatsächlich sind. Teilweise nur 1 %.
Verglichen wird hier also nicht ein Modell mit einem anderen, sondern ein Modell, das man selbst promptet, mit einem System, das jemand um ein Modell herum gebaut hat – dieselbe Technologie darunter, völlig unterschiedliche Ergebnisse. Maven war einer der 4 von G2 befragten Anbieter.
Was hinter der Lücke steckt
Nichts von dem, was die 4 beschrieben, hatte damit zu tun, welches Modell sie gewählt hatten. Alle sagten mehr oder weniger dasselbe. Ihre Systeme arbeiten in Schritten statt in einem einzigen Durchgang. Antworten stammen aus Live-Daten statt aus dem, was sich das Modell zufällig aus dem Training gemerkt hat. Sie messen, wie oft eine Aufgabe tatsächlich abgeschlossen wird, und überarbeiten Prompts und Logik mindestens einmal pro Woche. Einer von ihnen tut das täglich. All das ist Arbeit rund um das Modell, nicht am Modell selbst.
Noch aufschlussreicher ist, worin sie sich beim Aufwand einig waren. Alle 4 sagten, das Schwierige sei nicht die alltägliche Frage, sondern der Sonderfall und die mehrstufige Aufgabe. Deshalb bauen sie Systeme, die erkennen, wann sie an ihre Grenzen stoßen, und das Gespräch dann an einen Menschen übergeben, statt zu raten. Maven formulierte es in der Umfrage so: „Autonomie ohne verlässliche Fallback-Logik ist kein Feature, sondern ein Risiko.“
Das erklärt den Großteil der Lücke. Wenn Sie ein Modell selbst prompten, sind Sie derjenige, der seine Arbeit überprüft. Ein Produktivsystem ist so gebaut, dass diese Aufgabe nie beim Kunden landet. G2 brachte es auf den Punkt: Diese Anbieter haben nicht weniger Fehler – sie fangen sie ab, bevor jemand sie bemerkt.
Die Debatte „Agent oder Chatbot“ dreht sich vor allem um Begriffe
G2 fragte die 4 Anbieter direkt, ob KI-Agenten zuverlässiger sind als das, was die Kategorie noch immer Chatbots nennt. Alle antworteten ungefähr gleich – und das ist keine gute Nachricht für alle, die mit dem Begriff verkaufen. Im Produktivbetrieb unterscheiden sich die beiden längst nicht so stark, wie das Marketing suggeriert, und ein neues Etikett allein löst kein Problem.
Für Käufer ist das wichtiger als für Anbieter. Wer nach dem Wort „Agent“ sucht, kauft ein Etikett statt einer Fähigkeit. Ob ein Anbieter sein Produkt Agent nennt und ein anderer es anders bezeichnet, sagt nichts darüber aus, ob eines davon Informationen in Ihrem aktuellen Wissen nachschlägt, erkennt, wenn es unsicher ist, oder nach dem Launch anhand echter Gespräche überprüft wird. Das sind Eigenschaften von Agentic AI im Kundenservice, und keine davon kommt mit dem Etikett.
Aussagekräftig sind Fragen dazu, wie das System gebaut ist – und alle 5 können Sie schon im ersten Gespräch stellen.
- Woher kommen die Antworten? Schlägt es in Ihrem aktuellen Wissen nach oder verlässt es sich auf das, was das Modell im Training aufgenommen hat?
- Was passiert, wenn es unsicher ist? Übergibt es das Gespräch oder rät es im selben selbstbewussten Ton, den es auch verwendet, wenn es richtig liegt?
- Wie oft prüft jemand die Antworten anhand echter Gespräche, und was wird dabei gemessen?
- Kann Ihr Team das Verhalten des Agenten anpassen, oder muss jede Änderung über den Anbieter laufen?
- Kann es in Ihren Systemen tatsächlich etwas erledigen, oder kann es dem Kunden nur sagen, was er tun soll?
Kann ein Anbieter alle 5 beantworten, hat jemand die Arbeit gemacht. Überzeugt er bei der ersten Frage und wird danach vage, hat er ein Modell eingekauft und ein Widget darum gebaut. Eine ausführlichere Version dieser Liste finden Sie in unserem Leitfaden zur Bewertung von KI-Agenten für den Enterprise-Kundenservice.
Was Käufer übersehen
Was die 4 Anbieter beschrieben, ist derselbe Stack, auf dem Mavens 5-schichtige Architektur aufbaut. Das Modell ist eine Schicht. Alles, was es zuverlässig macht, liegt darum herum: was der Agent weiß, was er tun darf, wie Sie seine Arbeit im Live-Betrieb überprüfen und wer die Guardrails kontrolliert. Käufer entscheiden meist nach dem Modell, weil an dieser Schicht die bekannten Namen hängen. Alles, worauf die Daten von G2 hindeuten, liegt in den anderen 4 – und genau deshalb ist autonome Lösung etwas anderes als eine gute Antwort.
Deshalb schließen sich schnelle Bereitstellung und Zuverlässigkeit auch nicht aus, selbst wenn die Kategorie das annimmt. Diese Schichten zu bauen ist echte Engineering-Arbeit, aber sie geschieht einmal, innerhalb der Plattform, statt im Stack jedes Kunden zu einem 6-monatigen Projekt zu werden.
So sieht es aus, wenn die Arbeit gemacht ist
Mastermind erreichte innerhalb von 6 Wochen 93 % autonome Lösung. K1x kam in der ersten Woche auf 80 %. Rho hielt einen CSAT von 95 % und bewältigte dabei monatlich 12 % mehr Kontakte, ohne zusätzliches Personal einzustellen. Quest baute AskQ auf Maven auf, band es ohne Datenmigration an die bestehende Wissensdatenbank und das vorhandene Case-System an und bewertet es nach Kundenzufriedenheit statt nach Deflection.
Mavens eigene Bewertungen zeigen in dieselbe Richtung. 4,8 von 5 bei 20 verifizierten Bewertungen – und es lohnt sich zu lesen, was Nutzer tatsächlich hervorheben: eine einzige Engine für Chat, E-Mail und Voice statt separater Bots, die synchron gehalten werden müssen; Wissensabruf, der veraltete, doppelte und widersprüchliche Artikel kennzeichnet, statt aus dem erstbesten Artikel zu antworten; eine Einrichtung in wenigen Tagen auf Basis von Salesforce oder Zendesk. All das liegt rund um das Modell.
In den Fall 2026 Reports von G2, erschienen am 25. August, wurde Maven im Mid-Market Grid für Customer Service Automation, im Mid-Market Results Index für AI Customer Support Agents und im Implementation Index für AI Customer Support Agents platziert. Index-Reports basieren darauf, was Kunden über ihre Ergebnisse und den Verlauf der Einführung sagen – nicht darauf, wie groß oder bekannt ein Unternehmen ist. Sie messen genau das, was laut den übergreifenden Daten von G2 überall sonst schiefläuft.
Die Lücke ist die eigentliche Geschichte
Entscheidend ist der Abstand zwischen 14 % und 1 %, denn beide Werte beruhen auf derselben Handvoll Modelle. Die Technologie allein erklärt keine so große Lücke. Entscheidend ist, ob sich jemand die Mühe gemacht hat, die Komponenten zu bauen, die eine falsche Antwort abfangen, bevor ein Kunde sie sieht. Deshalb ist eine Lösungsquote nur aussagekräftig, wenn Sie wissen, wie sie gemessen wurde.
Die meisten Käufer vergleichen noch immer Modellnamen. Die 4 Anbieter, mit denen G2 gesprochen hat, haben das längst hinter sich gelassen.
Wenn Sie die Schichten in Aktion sehen möchten, statt nur darüber zu lesen, buchen Sie eine Demo.
Testen Sie es mit Ihren eigenen Konversationen.
Fordern Sie eine kostenlose, individuelle Demo an.


