
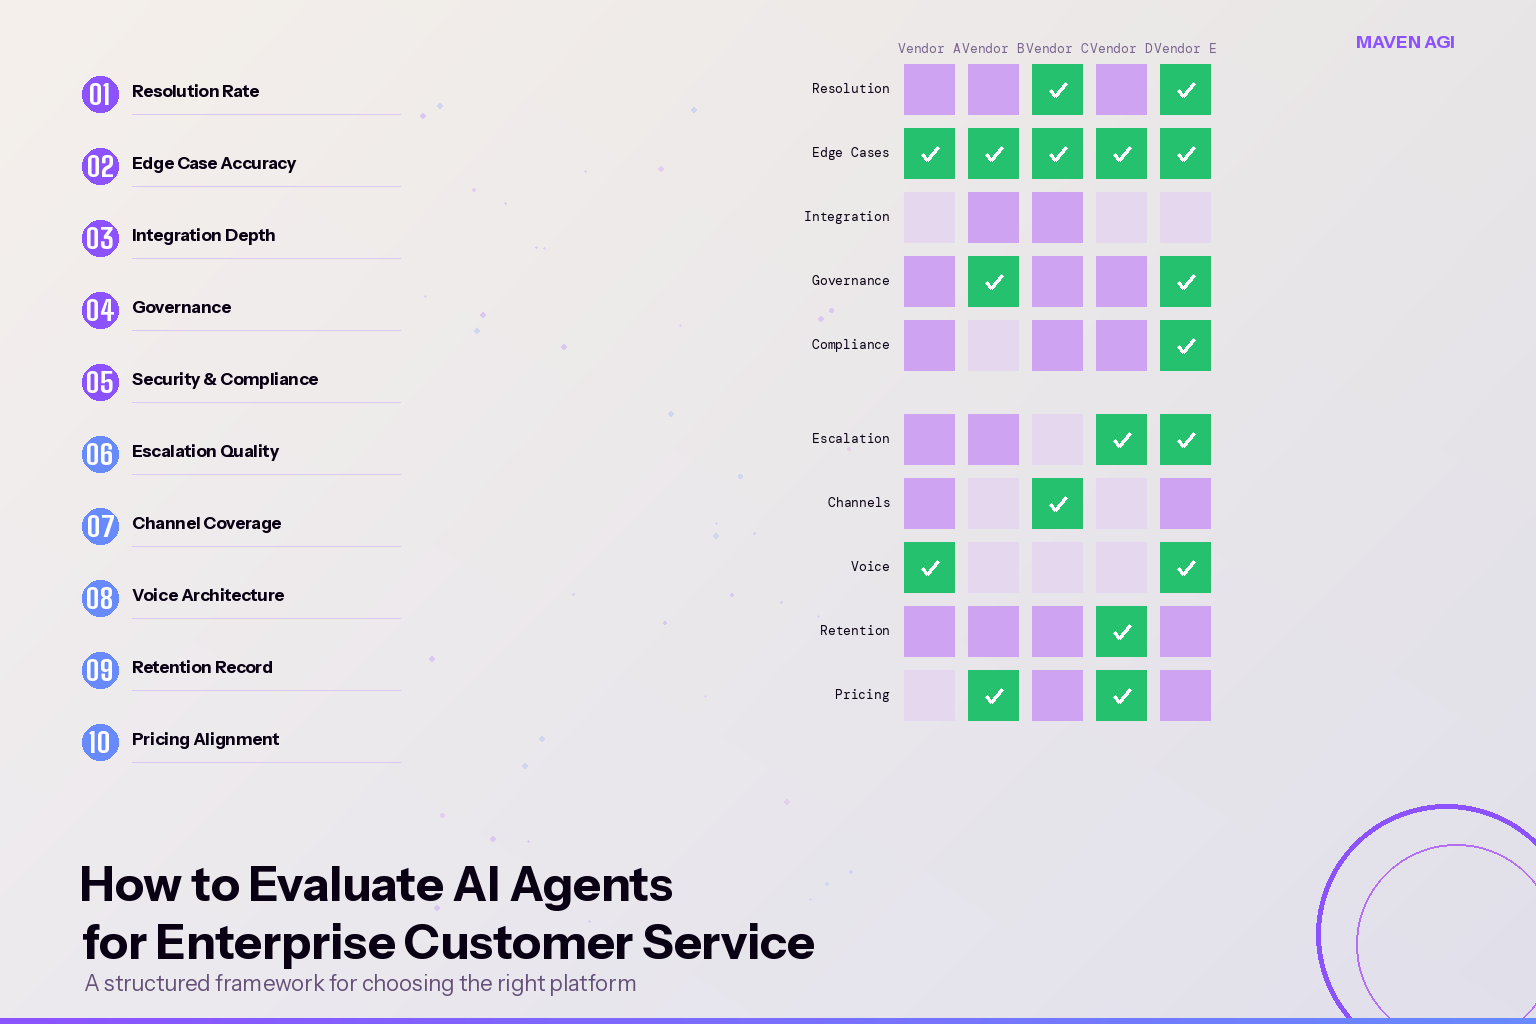
Der Markt für Enterprise-KI-Agenten ist inzwischen so ausgereift, dass es an Anbietern mit beeindruckenden Ergebnissen nicht mangelt. Proof-of-Concept-Umgebungen liefern regelmäßig Spitzenwerte – Automatisierungsraten von 80 % oder 90 % –, doch Implementierungen, die diese Ergebnisse auch im Produktivbetrieb halten, sind deutlich seltener. Diese Lücke ist vorhersehbar, wenn Sie wissen, worauf Sie achten müssen. Bei einer Standardevaluierung bleibt sie dagegen weitgehend unsichtbar.
Was die Teams, die es richtig machen, von allen anderen unterscheidet, ist nicht die Demo. Entscheidend ist, ob sie die Plattform anhand der Faktoren auf die Probe gestellt haben, die über die Leistung im Produktivbetrieb entscheiden. Dieser Leitfaden gibt eine praxisnahe Antwort darauf, wie Sie KI-Plattformen für den Kundenservice evaluieren, ohne sich von einem glänzenden ersten Eindruck täuschen zu lassen – und wie Sie die beste Plattform für eine Enterprise-Implementierung auswählen, die auch unter realem Volumen standhält. Er orientiert sich an den Fragen, die Plattformen für den Produktivbetrieb von Plattformen für gute Demos unterscheiden. Wenn es hilft, orientieren Sie sich zunächst an den Kundenservice-Anwendungsfällen, die Sie tatsächlich abbilden, und leiten Sie daraus die Kriterien ab.
Verstehen Sie zuerst, was Sie eigentlich evaluieren
Die meisten Anbieterevaluierungen beginnen mit einer Demo-Anfrage und enden mit einem Referenzgespräch. Dieser Prozess wurde für Software entwickelt, die genau das tut, wofür sie konfiguriert ist. KI-Agenten sind anders: Ihre Leistung in einer kontrollierten Demo sagt oft nur wenig über ihre Leistung im Produktivbetrieb aus. Die Faktoren, die im Produktivbetrieb am meisten zählen – Verteilung der Anfragen, Häufigkeit von Edge Cases, Zuverlässigkeit der Integrationen und Verhalten unter Last –, sind genau die Faktoren, die Demos gezielt vermeiden.
Bevor Sie eine Evaluierung starten, sollten Sie 3 Punkte klären.
Was bedeutet Lösung für Ihren Anwendungsfall? Nicht Deflection, nicht Containment. Autonome Lösung bedeutet: Das Problem des Kunden wurde gelöst, er hat sich nicht erneut wegen desselben Anliegens gemeldet, und die KI hat die Aktion ausgeführt, ohne dass ein Mensch sie abschließen musste. Wenn Sie das vor Beginn der Evaluierung nicht konkret für Ihr Produkt definieren können, lassen sich die Benchmarks des Anbieters kaum sinnvoll interpretieren.
Wie sieht ein Fehlschlag aus? Ein KI-Agent, der 80 % der Interaktionen gut bewältigt, die übrigen 20 % aber so schlecht handhabt, dass Vertrauen verloren geht, ist kein Erfolg. Wenn Sie Ihre Fehlermuster kennen – falsche Rückerstattungen, fehlerhafte Kontoänderungen, Eskalationen ohne Kontext –, können Sie sie gezielt in die Evaluierung einbauen, statt sie erst nach dem Launch zu entdecken.
Wie sieht Ihre Integrationsrealität aus? Die Leistungslücke zwischen Sandbox und Produktivbetrieb lässt sich fast immer auf die Integration zurückführen. Ein Agent, der mit einem Auszug Ihrer Wissensdatenbank evaluiert wird, verhält sich anders als einer, der mit Ihrem Live-CRM, Ihrem Ticketsystem und Ihrer Abrechnungsplattform verbunden ist. Je früher Sie mit echtem Systemzugriff testen können, desto aussagekräftiger sind die Ergebnisse.
Die Fragen, die echte Produktionsreife sichtbar machen
Standardevaluierungen drehen sich meist um Funktionen und Preise. Die folgenden Fragen zielen auf etwas Konkreteres: ob die Plattform dafür ausgelegt ist, wie Enterprise-Support tatsächlich funktioniert.
Wie definieren Sie autonome Lösung, und wie messen Sie sie? Die Antwort verrät mehr als jeder Benchmark. Anbieter mit echter Produktionserfahrung haben klare Definitionen und konkrete Messmethoden. Sie unterscheiden zwischen Tickets, die von der KI abgeschlossen wurden, Tickets, die in den Self-Service umgeleitet wurden, und Tickets, die bei einem Menschen gelandet sind. Anbieter, die auf Demo-Performance optimieren, werfen diese Kategorien gern zusammen. Lassen Sie sich zeigen, wie ein gelöstes Ticket in ihrem System im Vergleich zu einem umgeleiteten klassifiziert wird.
Wie hoch ist Ihre Re-Contact-Rate innerhalb von 72 Stunden? Diese Kennzahl entlarvt Scheinlösungen. Wenn sich ein erheblicher Teil der Kunden, deren Anliegen als gelöst markiert wurde, innerhalb von 3 Tagen erneut an den Support wendet, liegt die tatsächliche Lösungsrate unter dem ausgewiesenen Wert. Genau das ist der Unterschied zwischen Deflection und Lösung. Anbieter mit Fokus auf den Produktivbetrieb erfassen diese Kennzahl. Wer das nicht tut, misst das Falsche.
Kann der Agent Aktionen in meinen Backend-Systemen ausführen, oder kann er nur Informationen bereitstellen? Lese- versus Schreibzugriff ist die entscheidende architektonische Trennlinie. Ein Agent, der einem Kunden mitteilen kann, dass seine Bestellung verspätet ist, die Lieferung aber nicht neu terminieren kann, löst das Problem nicht – er beantwortet lediglich eine Frage. Für die meisten Enterprise-Support-Anwendungsfälle erfordert echte Lösung Schreibzugriff auf mindestens 2 oder 3 Backend-Systeme. Fragen Sie, welche Integrationen über vorgefertigte Konnektoren verfügbar sind und welche individuelle Entwicklung erfordern.
Wie funktioniert die Eskalation, und was passiert mit dem Kontext? Bei der Eskalation erzeugen die meisten KI-Implementierungen mehr Reibung, statt sie zu beseitigen. Erhält der Mitarbeiter bei der Übergabe eine Zusammenfassung des Gesprächs und die Kontohistorie des Kunden, oder muss der Kunde von vorn beginnen? Testen Sie das während der Evaluierung gezielt. Diese Interaktion führt am häufigsten zu Beschwerden – und wird in Demos am häufigsten übergangen.
Was tut der Agent, wenn er etwas nicht weiß? Ein souveräner Umgang mit Fehlern ist genauso wichtig wie starke Leistung. Beobachten Sie, wie das System mit Anfragen außerhalb seines Trainings, mehrdeutigen Anliegen und gezielten Versuchen umgeht, fehlerhafte Ausgaben zu provozieren. Anbieter, die in diesen Fällen sicher sind, lassen Sie das während der Evaluierung testen. Wer solchen Tests ausweicht, hat meist einen Grund dafür.
Wie lange dauert die Integration? Wenn die ehrliche Antwort Monate lautet, ist das eine wertvolle Information. Enterprise-Implementierungen, die vor dem Go-live umfangreiche Professional Services erfordern, bergen erhebliche Kosten und Risiken. Eine Overlay-Architektur, die sich ohne Datenmigration mit bestehenden Helpdesks verbindet, kann oft innerhalb weniger Wochen live gehen. Fragen Sie nach konkreten Zeitplänen von der Vertragsunterzeichnung bis zu den ersten Live-Interaktionen.
Die Proof-of-Concept-Falle
POCs sind bei Enterprise-KI-Evaluierungen nahezu Standard – und sie liefern fast immer bessere Ergebnisse als der spätere Produktivbetrieb. Das ist kein Zufall. POCs laufen mit sauberen Daten, begrenztem Anfragenspektrum und Unterstützung durch den Anbieter. Sie sind auf die Evaluierung zugeschnitten. Im Produktivbetrieb dagegen trifft der Agent auf die gesamte Bandbreite an Kundenanfragen, ist mit Systemen verbunden, die nie für KI ausgelegt waren, und wird von Teams betreut, die noch andere Aufgaben haben.
Um diese Lücke zu schließen, sollten Sie auf POC-Bedingungen bestehen, die dem Produktivbetrieb tatsächlich ähneln. Führen Sie den POC mit Live-Anfragen aus Ihrem echten Kundenstamm durch, nicht mit einer Stichprobe. Verbinden Sie ihn mit produktionsgleichen Systemen, nicht mit einer Sandbox. Lassen Sie ihn lange genug laufen, bis sich die Leistung stabilisiert – nicht nur im anfänglich optimierten Zeitfenster. Fragen Sie, welcher Anteil der Anfragen während des POC innerhalb des vorkonfigurierten Umfangs lag und welcher außerhalb. Die meisten Pilotprojekte, die in der Demo überzeugen, erreichen nie den Produktivbetrieb – und die Gründe sind so konsistent, dass Sie sie einplanen können. Was beides voneinander trennt, zeigt unsere Analyse der Lücke zwischen Pilot und Produktivbetrieb.
Anbieter, die bereit sind, einen POC unter diesen Bedingungen durchzuführen, bauen für den Produktivbetrieb. Wer darauf besteht, die Bedingungen streng zu kontrollieren, optimiert auf den POC selbst.
So sieht eine gründliche Evaluierung in der Praxis aus
Die besten Evaluierungen stammen von Teams, die die Anbieterauswahl als technische Entscheidung behandeln und nicht als Beschaffungsformalität. Als Clio, die Legal-Tech-Plattform, einen veralteten skriptbasierten Bot ersetzen wollte, evaluierte das Team 32 Anbieter und ließ anschließend mehr als 10 davon in einem direkten Vergleich gegeneinander antreten, bevor es sich für Maven entschied. Getestet wurde anhand der echten Anforderungen: präzise Antworten auf In-App-Chat-Anfragen, tiefe Integration in den bestehenden Stack einschließlich Salesforce und Leistung bei den Edge Cases, an denen skriptbasierte Systeme scheitern.
Das Ergebnis hielt im Produktivbetrieb stand, nicht nur in der Demo: 80 % autonome Lösung und ein 4-mal schnellerer Live-Support für die technischen Fragen, die weiterhin bei einem Menschen landen. Diese Kombination – hohe autonome Lösungsrate bei gleichzeitig schnellerer Bearbeitung der Ausnahmen – ist das Kennzeichen einer Evaluierung, die auf den Produktivbetrieb statt auf einen glänzenden ersten Eindruck ausgelegt ist. Und sie ist das, was die stärksten CX-Teams gemeinsam haben: Sie gestalten die Evaluierung so, dass Schwachstellen vor der Vertragsunterzeichnung auffallen, nicht danach.
Compliance ist kein Add-on
Bei den meisten Enterprise-Implementierungen führt der Weg vom POC in den Produktivbetrieb über Ihr Security Review. Genau hier geraten viele Evaluierungen von KI-Agenten ins Stocken oder scheitern ganz. Die Compliance-Anforderungen an einen KI-Agenten, der autonom Kundendaten verarbeitet, Transaktionen abwickelt und Aktionen in Produktivsystemen ausführt, sind erheblich – und die meisten Unternehmen sind weniger gut vorbereitet, als sie glauben. In einer Umfrage von Grant Thornton aus dem Jahr 2026 gaben 78 % der Führungskräfte an, nicht darauf zu vertrauen, ein KI-Audit innerhalb von 90 Tagen bestehen zu können.
Prüfen Sie die Compliance frühzeitig und nicht erst als letzten Schritt. Konkret: Verfügt der Anbieter über SOC 2 Type II, ist ein HIPAA BAA verfügbar, gibt es GDPR-Auftragsverarbeitungsverträge und PCI-DSS-Compliance für alle zahlungsnahen Workflows? Sind Audit-Trails für jede Aktion des Agenten verfügbar und abfragbar? Wurden die Subunternehmer des Anbieters geprüft und offengelegt? Kann die Plattform Ihre Anforderungen an die Datenresidenz erfüllen?
Anbieter mit echter Enterprise-Compliance-Infrastruktur beantworten diese Fragen mit Dokumentation, nicht mit Zusicherungen. Wer Compliance als Häkchen in letzter Minute behandelt, scheitert am ehesten im Security Review – nachdem Sie bereits in die Evaluierung investiert haben.
Das Referenzgespräch, nach dem Sie fragen sollten
Die meisten Referenzgespräche sind darauf ausgelegt, positive Erfahrungen zu bestätigen. Bitten Sie stattdessen um ein Gespräch mit einem Kunden, dessen Implementierung schwierig war – eine, die erhebliches Troubleshooting erforderte, bevor sie gut lief. Wie der Anbieter mit dieser Implementierung umgegangen ist, sagt mehr aus als 3 reibungslose.
Fragen Sie die Referenz gezielt, was schiefgelaufen ist, wie lange die Behebung gedauert hat und ob sie die nötige Unterstützung erhalten hat. Die Antworten zeigen, ob Sie mit diesem Anbieter auch 18 Monate nach dem Go-live noch zusammenarbeiten möchten.
Evaluieren Sie so, dass der Produktivbetrieb vorhersehbar wird
Jeder Anbieter besteht eine Demo. Deutlich weniger bestehen eine Evaluierung, die offenlegt, was bei realem Volumen, mit echten Systemen und unter einem echten Security Review passiert. Nutzen Sie diese Fragen als Scorecard, führen Sie den POC mit Ihren schwierigsten Anfragen durch und gewichten Sie Referenzen aus dem Produktivbetrieb stärker als Analysten-Auszeichnungen. Teams, die das konsequent tun, haben Implementierungen, die auch ein Jahr später noch überzeugen.
Prüfen Sie, wie sich das Framework an Ihrem eigenen Ticketvolumen bewährt. Demo buchen – und bringen Sie die Anfragen mit, an denen es Ihrer Meinung nach scheitern wird.
Testen Sie es mit Ihren eigenen Konversationen.
Fordern Sie eine kostenlose, individuelle Demo an.


