
Die meisten KI-Supportprojekte in Unternehmen scheitern nicht an der Idee. Sie scheitern irgendwo zwischen einem erfolgreichen Proof of Concept und dem Moment, in dem das System echtes Volumen, echte Daten und echte Konsequenzen bewältigen muss.
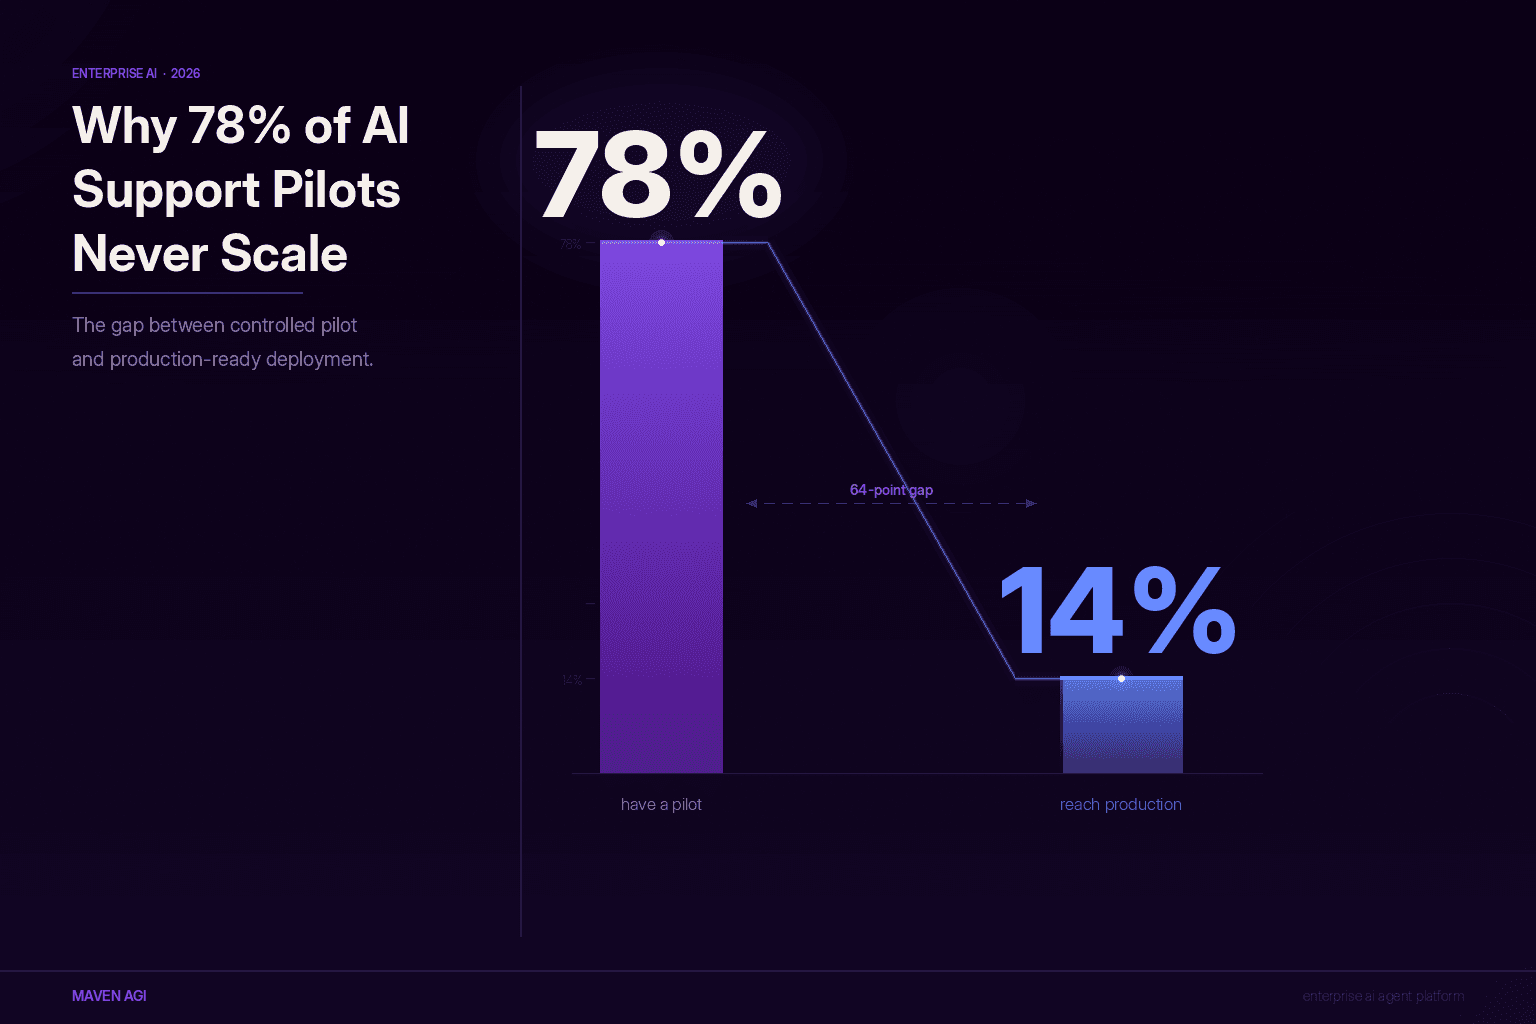
Eine Umfrage unter 650 Technologieverantwortlichen in Unternehmen aus dem März 2026 beziffert die Lücke: 78 % der Unternehmen betreiben mindestens einen KI-Agenten-Pilot in einer kontrollierten Umgebung. Nur 14 % haben einen Agenten erfolgreich für den unternehmensweiten operativen Einsatz skaliert. In dieser Lücke von 64 Prozentpunkten zwischen „Wir haben einen Pilot“ und „Wir haben ein Deployment“ verschwinden die meisten KI-Budgets – ganz leise.
Der Grund dafür liegt meist nicht in der KI selbst. Die Modelle sind ausgereift, die Tools besser geworden. Die Lücke ist organisatorischer und operativer Natur: Die meisten Unternehmen bauen ihre Piloten nicht für den Produktivbetrieb. Sie bauen sie für die Demo.
Was eine Demo testet – und was der Produktivbetrieb verlangt
Ein Pilot läuft unter kontrollierten Bedingungen. Die Daten sind sauber, das Volumen ist überschaubar, Grenzfälle sind noch nicht aufgetaucht. Jemand im Team beobachtet jede Interaktion. Wenn etwas schiefgeht, wird es behoben, bevor ein Muster daraus wird.
Im Produktivbetrieb sieht es anders aus. Er läuft mit hohem Volumen, auf oft unsauberen und unvollständigen Daten, ohne Sicherheitsnetz für einzelne Interaktionen. Grenzfälle, die im Pilot nie auftraten, tauchen plötzlich ständig auf. Laut einer Gartner-Analyse, über die das CTO Magazine berichtete, werden voraussichtlich mehr als 40 % der Projekte mit agentischer KI bis Ende 2027 eingestellt – nicht, weil die Technologie nicht funktioniert, sondern wegen „unklarem Geschäftswert, steigenden Kosten und unzureichenden Risikokontrollen“. Das sind keine technologischen Fehlschläge. Es sind Fehler in der Deployment-Architektur.
Unternehmen, die erfolgreich skalieren, teilen eine einheitliche Implementierungsarchitektur – auch wenn sich ihre Use Cases unterscheiden. Sie entdecken diese Architektur nicht erst im Pilot. Sie bauen sie auf, bevor das Deployment beginnt.
Die 5 Lücken hinter den meisten Skalierungsfehlern
Die Umfrage vom März 2026 identifizierte 5 Grundursachen, die zusammen für 89 % der Skalierungsfehler bei KI-Agenten-Deployments in Unternehmen verantwortlich sind:
- Komplexe Integration mit Legacy-Systemen. Ein KI-Agent, der eine statische Wissensdatenbank abfragt, schlägt sich in der Demo recht gut. Ein Agent, der in Echtzeit über CRM, Helpdesk, Auftragsmanagement und Abrechnungsplattform hinweg schlussfolgern und nach einer Lösung in diese Systeme zurückschreiben muss, ist eine ganz andere Aufgabe. Die meisten Piloten testen Ersteres. Die meisten Produktivanforderungen verlangen Letzteres.
- Schwankende Ausgabequalität bei hohem Volumen. Die Qualität im Pilot wird oft durch Überwachung aufrechterhalten. Wenn ein Mensch jede Interaktion prüft, werden Probleme früh erkannt. Im großen Maßstab fällt diese Überwachung weg. Wurde der Agent nicht systematisch an der gesamten Bandbreite der Eingaben evaluiert, die ihm im Produktivbetrieb begegnen – einschließlich der ungewöhnlichen –, sinkt die Qualität auf eine Weise, die unsichtbar bleibt, bis sich Kunden beschweren.
- Fehlendes Monitoring. Was Sie nicht sehen, können Sie nicht verbessern. Deployments, die die Agentenleistung nicht vom ersten Tag an messen, stagnieren meist. Die Feedbackschleife zwischen Agentenausgabe und Workflow-Design unterscheidet Deployments, deren Wert stetig wächst, von solchen, die auf der Stelle treten.
- Unklare organisatorische Zuständigkeit. Jemand muss für die Leistung jedes agentischen Workflows verantwortlich sein – nicht nur für den technischen Betrieb, sondern für die geschäftlichen Ergebnisse. Ohne klare Zuständigkeit verwässert die Verantwortung. Probleme, die in Tagen gelöst sein sollten, dauern Wochen. Offensichtliche Verbesserungen werden nie umgesetzt.
- Unzureichende domänenspezifische Trainingsdaten. Unternehmensdaten sind nie eine einzige, saubere Quelle. Sie sind über Systeme verteilt, uneinheitlich strukturiert und ändern sich ständig. Sobald Sie vom kontrollierten Pilot in den Produktivbetrieb wechseln, verschärft sich diese Fragmentierung. Agenten, die auf einem kuratierten Datensatz zuverlässig geschlussfolgert haben, stoßen plötzlich auf widersprüchliche Dokumente, doppelte Datensätze und veraltete Richtlinien.
Was „produktionsreif“ im CX wirklich bedeutet
Speziell für den Kundensupport ergab der Infor Enterprise AI Adoption Impact Index, für den Anfang 2026 1.000 Entscheidungsträger in den USA, Großbritannien, Deutschland und Frankreich befragt wurden, dass mehr als die Hälfte der Unternehmen Schwierigkeiten hat, KI über erste Deployments hinaus zu skalieren. Die genannten Hürden sind keine Fähigkeitslücken. Es sind Umsetzungslücken.
Produktionsreif heißt: Die Plattform bewältigt echtes Ticketvolumen ohne Qualitätsverlust. Eskalationen übergeben den vollständigen Kontext an menschliche Agenten, statt den Gesprächsverlauf bei der Übergabe zu verlieren. Die Governance-Infrastruktur – Audit-Trails, Berechtigungsstufen, Exception-Routing – wurde von Anfang an mitgedacht, statt unter dem Druck eines Enterprise-Security-Reviews nachgerüstet zu werden. Und die Integrationsschicht ist bidirektional mit den Systemen verbunden, in denen die Supportarbeit tatsächlich stattfindet: Helpdesk, CRM, Abrechnungssystem, Wissensdatenbank.
Das sollten Sie verstehen, wenn Sie am Anfang einer Evaluierung von KI-Kundensupport stehen. Die Frage ist nicht nur, ob die Plattform das Supportvolumen bewältigt. Die eigentliche Frage ist, ob sie für den Produktivbetrieb entwickelt wurde – oder dafür, einen Beschaffungsprozess zu gewinnen. Das sind unterschiedliche Designphilosophien, und sie führen zu unterschiedlichen Systemen.
Die Kennzahlen, die zeigen, ob Sie auf Kurs sind
Bevor ein Pilot in ein breiteres Deployment übergeht, gibt es 3 Kennzahlen, die Teams auf dem Weg in den Produktivbetrieb von Teams unterscheiden, die einen dauerhaften Proof of Concept bauen.
Die erste ist die autonome Lösungsrate, nicht die Deflection-Rate. Deflection zählt Kontakte, die die KI an einen Menschen weitergeleitet hat. Resolution zählt Kontakte, die die KI abgeschlossen hat. Eine Plattform kann starke Deflection-Zahlen vorweisen, während die tatsächliche Lösungsrate so niedrig ist, dass sich die Investition wirtschaftlich nicht rechnet.
Die zweite ist die Wiedereröffnungsrate. Ein Kontakt, den die KI „gelöst“ hat und der innerhalb von 24 Stunden als Ticket für einen Menschen wieder aufgeht, wurde nicht gelöst, sondern nur aufgeschoben. Die meisten Plattformen zeigen diese Kennzahl nicht standardmäßig an – deshalb entdecken Teams das Problem oft erst, wenn es sich in den Kundenzufriedenheitswerten niederschlägt.
Die dritte ist die Leistung beim 90. Perzentil der Anfragekomplexität, nicht beim Median. Piloten werden meist anhand der Durchschnittsleistung bewertet. Im Produktivbetrieb entscheiden die Grenzfälle über Erfolg oder Misserfolg. Wer eine Plattform nur anhand der Anfragen bewertet, die sie gut bewältigt, landet bei einem Deployment, das für 60 % der Kontakte funktioniert und bei den anderen 40 % regelmäßig scheitert – meist bei denen, die am wichtigsten sind.
Ein umfassenderes Bewertungsraster finden Sie im Beitrag So evaluieren Sie KI-Agenten für den Enterprise-Kundenservice. Er beschreibt die konkreten Kriterien, die produktionsfähige Plattformen von demo-optimierten unterscheiden.
Was die 14 % unterscheidet, die skalieren
Unternehmen, die erfolgreich vom Pilot in den Produktivbetrieb wechseln, folgen einigen gemeinsamen Praktiken. Sie kümmern sich vor dem Agenten-Deployment um die Datenbasis: Sie prüfen die Quellen, auf die sich der Agent stützen wird, schaffen saubere Integrationsschichten und stellen sicher, dass die Informationen, auf die der Agent zugreift, aktuell und vollständig genug für verlässliches Schlussfolgern sind.
Sie bauen Audit-Trails und Berechtigungsinfrastruktur auf, bevor sie die Autonomie der Agenten ausweiten – nicht danach. Beschaffungsgremien und Rechtsabteilungen in Unternehmen verlangen abfragbare Aufzeichnungen über jede Agentenaktion. Deployments, die diese Dokumentation nicht liefern können, bleiben beim breiteren Rollout stecken. Sie von Anfang an einzubauen, ist wesentlich einfacher, als sie nachzurüsten.
Und sie wählen den ersten Workflow nach Volumen und Messbarkeit aus, nicht danach, was sich in der Demo am besten macht. Ein klar definierter Support-Workflow mit hohem Volumen – Passwort-Resets, Bestellstatus, Kontoänderungen – liefert dem Agenten genug Eingaben, um Qualitätsprobleme schnell sichtbar zu machen, und genug Daten für systematische Verbesserung. Wer mit einem komplexen Workflow mit geringem Volumen startet, erhält ein Deployment, das uneinheitlich funktioniert und schwer zu bewerten ist.
Bei der Frage nach der Enterprise-Plattform für KI-Agenten geht es nicht darum, ob KI-Agenten bereit für den Enterprise-Support sind. 2026 sind die Fähigkeiten vorhanden. Es geht darum, ob die Deployment-Architektur – Integrationstiefe, Governance-Infrastruktur, Monitoring, organisatorische Zuständigkeit – nach demselben Standard aufgebaut wurde wie das Modell selbst.
Die meisten Piloten kommen nicht so weit. Diejenigen, die es schaffen, werden meist zu den Produktiv-Deployments, die Vertragsverlängerungen einbringen.
Testen Sie es mit Ihren eigenen Konversationen.
Fordern Sie eine kostenlose, individuelle Demo an.


