
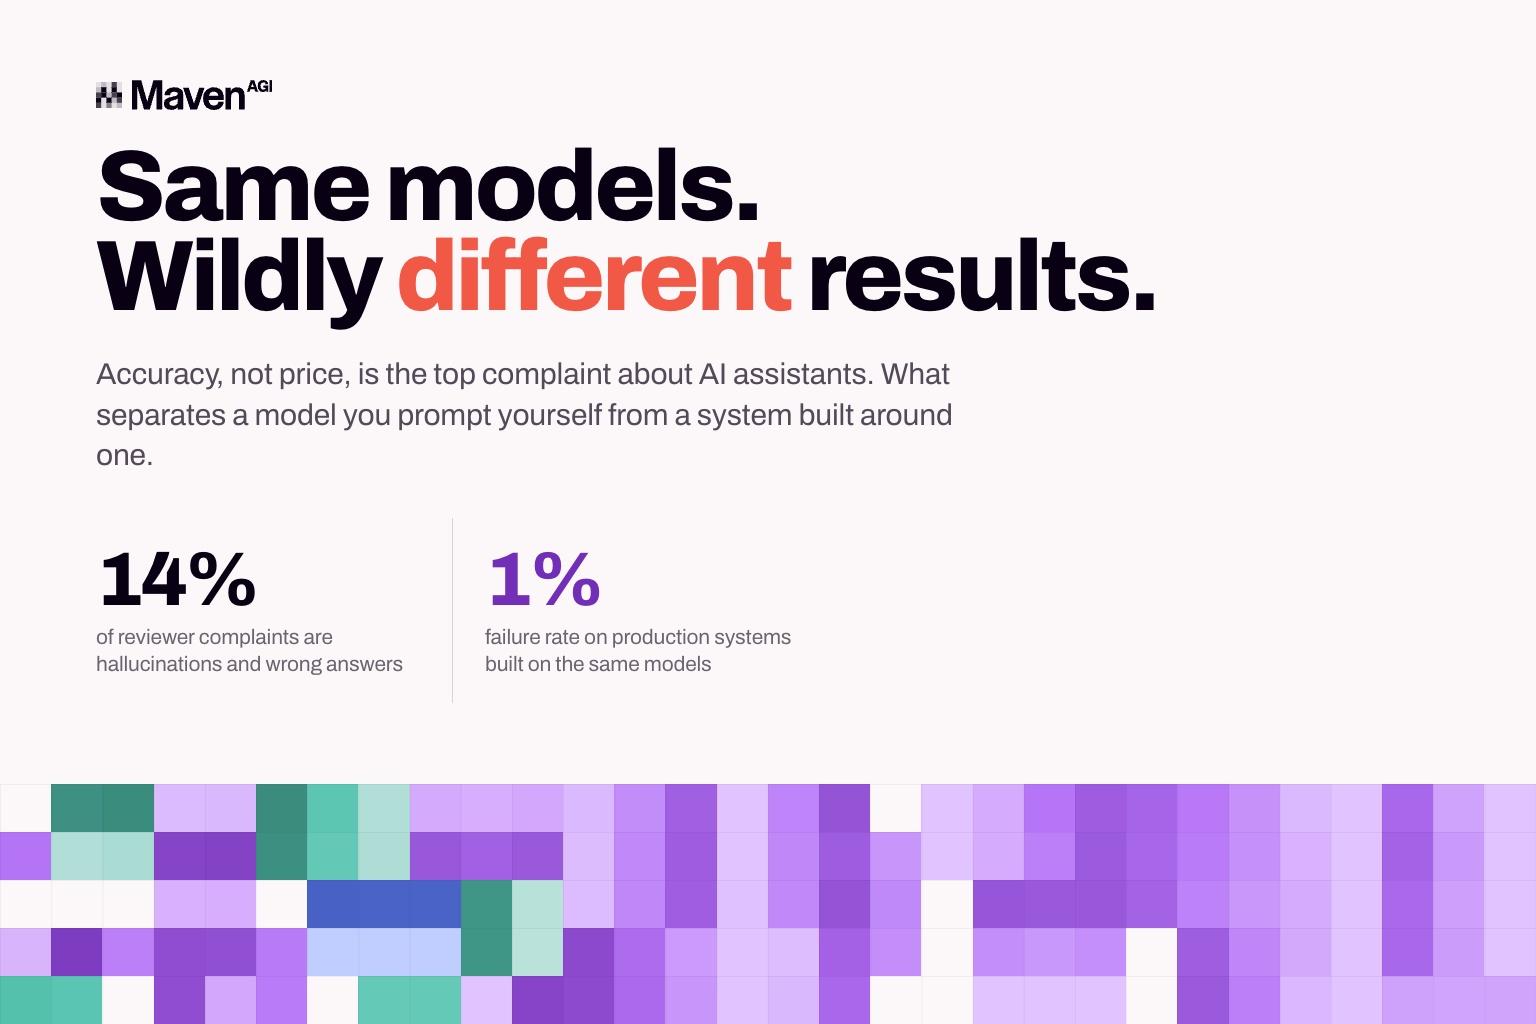
G2 อ่านรีวิวที่ผ่านการยืนยันแล้วกว่า 2,950 รายการ ตั้งแต่เดือนมกราคมถึงกลางเดือนกรกฎาคม แล้วดูว่าผู้ใช้บ่นเรื่องอะไรมากที่สุด คำตอบคือความแม่นยำ ไม่ใช่ราคา ปัญหา hallucination และคำตอบที่ผิดคิดเป็น 14% ของทุกสิ่งที่ผู้รีวิวบอกว่าไม่ชอบ แซงหน้าเรื่องต้นทุน ในปีที่ใครๆ ก็อยากถกเถียงกันแต่เรื่องต้นทุน
ควรรู้ด้วยว่าผู้รีวิวเหล่านั้นคือใคร เพราะมันเปลี่ยนความหมายของตัวเลขนี้ ส่วนใหญ่พูดถึงผู้ช่วย AI แบบใช้งานทั่วไปที่ทุกคนเปิดค้างไว้ในแท็บเบราว์เซอร์ พวกเขาไม่ใช่ทีม CX ที่พูดถึงเอเจนต์ซัพพอร์ตที่ใช้งานจริงใน production แต่เป็นคนที่ถามโมเดล ได้คำตอบที่ฟังดูมั่นใจกลับมา แล้วต้องมาตรวจสอบเองว่าจริงหรือไม่
จากนั้น G2 ไปถามผู้ให้บริการ 4 รายที่สร้างระบบ production บนโมเดลชุดเดียวกันนี้ว่าอัตราความผิดพลาดจริงๆ เป็นอย่างไร คำตอบคือต่ำสุดเพียง 1%
ดังนั้นสิ่งที่กำลังเปรียบเทียบกันจริงๆ ไม่ใช่โมเดลหนึ่งกับอีกโมเดลหนึ่ง แต่เป็นโมเดลที่คุณ prompt เองกับระบบที่มีคนสร้างขึ้นรอบโมเดล เทคโนโลยีเบื้องหลังเหมือนกัน แต่ผลลัพธ์ต่างกันลิบลับ Maven เป็นหนึ่งในผู้ให้บริการ 4 รายที่ G2 สอบถาม
อะไรอยู่เบื้องหลังช่องว่างนี้
สิ่งที่ผู้ให้บริการทั้ง 4 รายอธิบายไม่เกี่ยวกับว่าเลือกใช้โมเดลไหนเลย ทุกรายพูดไปในทางเดียวกัน ระบบของพวกเขาทำงานเป็นขั้นตอน ไม่ใช่ตอบครั้งเดียวจบ คำตอบดึงมาจากข้อมูลแบบ live ไม่ใช่จากสิ่งที่โมเดลบังเอิญจำได้จากการเทรน พวกเขาวัดว่างานเสร็จสมบูรณ์จริงบ่อยแค่ไหน และปรับ prompt กับ logic ใหม่อย่างน้อยสัปดาห์ละ 1 ครั้ง บางรายทำทุกวัน ทั้งหมดนี้เป็นงานที่ทำรอบๆ โมเดล ไม่ใช่ทำกับตัวโมเดล
สิ่งที่มีประโยชน์กว่าที่ทุกรายเห็นตรงกันคือ ความพยายามควรทุ่มไปที่ไหน ทั้ง 4 รายบอกว่าส่วนที่ยากไม่ใช่คำถามทั่วไปในแต่ละวัน แต่เป็น edge case และงานที่มีหลายขั้นตอน พวกเขาจึงสร้างระบบที่รู้ตัวเมื่อเจอเรื่องที่เกินความสามารถ และส่งต่อบทสนทนาให้คนแทนที่จะเดา คำตอบของ Maven ในแบบสำรวจคือ “ความเป็นอิสระที่ไม่มี fallback logic ที่ไว้ใจได้ ไม่ใช่ฟีเจอร์ แต่เป็นความเสี่ยง”
นั่นคือช่องว่างส่วนใหญ่ เมื่อคุณ prompt โมเดลเอง คุณคือคนที่ต้องตรวจงานของมัน ส่วนระบบ production ถูกสร้างมาเพื่อไม่ให้หน้าที่นั้นตกไปอยู่กับลูกค้า G2 สรุปไว้ชัดเจนว่า ผู้ให้บริการเหล่านี้ไม่ได้เจอความผิดพลาดน้อยกว่า แต่จับได้ก่อนที่ใครจะสังเกตเห็น
การถกเถียงเรื่องเอเจนต์กับแชทบอต ส่วนใหญ่เป็นแค่เรื่องของคำเรียก
G2 ถามผู้ให้บริการทั้ง 4 รายตรงๆ ว่าเอเจนต์ AI น่าเชื่อถือกว่าสิ่งที่วงการยังเรียกว่าแชทบอตหรือไม่ ทุกรายตอบคล้ายกัน และไม่ใช่ข่าวดีสำหรับใครที่ขายด้วยคำนี้ ใน production ทั้งสองอย่างไม่ได้ต่างกันมากอย่างที่การตลาดบอก และการเปลี่ยนชื่อเรียกจากอย่างหนึ่งเป็นอีกอย่างก็ไม่ได้แก้ปัญหาอะไรด้วยตัวมันเอง
เรื่องนี้สำคัญกับผู้ซื้อมากกว่าผู้ขาย ถ้าคุณเลือกซื้อเพราะคำว่า “เอเจนต์” คุณกำลังซื้อป้ายชื่อ ไม่ใช่ความสามารถ การที่ผู้ให้บริการรายหนึ่งเรียกผลิตภัณฑ์ว่าเอเจนต์ และอีกรายเรียกอย่างอื่น ไม่ได้บอกอะไรเลยว่าระบบไหนค้นหาข้อมูลจากองค์ความรู้ปัจจุบันของคุณ รู้ตัวเมื่อไม่แน่ใจ หรือได้รับการตรวจสอบกับบทสนทนาจริงหลังเปิดใช้งาน สิ่งเหล่านี้คือคุณสมบัติของ agentic AI ในงานบริการลูกค้า และไม่มีข้อไหนเลยที่มาพร้อมกับป้ายชื่อ
คำถามที่บอกอะไรได้จริงคือคำถามเกี่ยวกับวิธีสร้างระบบ และคุณถามได้ครบทั้ง 5 ข้อตั้งแต่การคุยครั้งแรก
- คำตอบมาจากไหน? ระบบค้นหาข้อมูลจากองค์ความรู้แบบ live ของคุณ หรืออาศัยสิ่งที่โมเดลเรียนรู้มาตอนเทรน?
- เกิดอะไรขึ้นเมื่อระบบไม่แน่ใจ? ส่งต่อให้คน หรือเดาด้วยน้ำเสียงมั่นใจแบบเดียวกับตอนที่ตอบถูก?
- มีคนตรวจคำตอบกับบทสนทนาจริงบ่อยแค่ไหน และวัดอะไรบ้าง?
- ทีมของคุณปรับพฤติกรรมของเอเจนต์ได้เอง หรือทุกการปรับแต่งต้องย้อนกลับไปผ่านผู้ให้บริการ?
- ระบบลงมือทำงานในระบบของคุณได้จริง หรือทำได้แค่บอกลูกค้าว่าต้องทำอะไร?
ถ้าผู้ให้บริการตอบได้ครบทั้ง 5 ข้อ แปลว่ามีคนลงมือทำงานส่วนนั้นแล้ว ถ้าตอบข้อแรกได้ดีแต่หลังจากนั้นเริ่มคลุมเครือ แปลว่าเขาแค่ซื้อโมเดลมาแล้วครอบด้วยวิดเจ็ต รายการฉบับเต็มอยู่ในคู่มือการประเมินเอเจนต์ AI สำหรับงานบริการลูกค้าระดับองค์กรของเรา
ส่วนที่ผู้ซื้อมักมองข้าม
สิ่งที่ผู้ให้บริการทั้ง 4 รายอธิบายคือ stack เดียวกับที่สถาปัตยกรรม 5 เลเยอร์ของ Mavenใช้เป็นรากฐาน โมเดลเป็นเพียง 1 เลเยอร์ ทุกอย่างที่ทำให้ระบบเชื่อถือได้อยู่รอบๆ มัน ได้แก่ สิ่งที่เอเจนต์รู้ สิ่งที่เอเจนต์ได้รับอนุญาตให้ทำ วิธีตรวจงานเมื่อเปิดใช้งานจริง และใครเป็นผู้ดูแล guardrails ผู้ซื้อมักเลือกจากโมเดล เพราะเป็นเลเยอร์ที่มีชื่อดังติดอยู่ แต่ทุกสิ่งที่ข้อมูลของ G2 ชี้ไปอยู่ในอีก 4 เลเยอร์ และนั่นคือเหตุผลที่การแก้ปัญหาแบบอัตโนมัติต่างจากการให้คำตอบที่ดี
นี่ยังเป็นเหตุผลที่การ deploy ได้เร็วกับความน่าเชื่อถือไม่ได้เป็นขั้วตรงข้ามกัน ไม่ว่าวงการจะเชื่ออย่างไร การสร้างเลเยอร์เหล่านี้เป็นงานวิศวกรรมจริงจัง แต่ทำเพียงครั้งเดียวภายในแพลตฟอร์ม แทนที่จะกลายเป็นโปรเจกต์ 6 เดือนใน stack ของลูกค้าทุกราย
เมื่องานส่วนนั้นถูกทำไว้แล้ว ผลลัพธ์เป็นอย่างไร
Mastermind ทำอัตราการแก้ปัญหาแบบอัตโนมัติได้ 93% ภายใน 6 สัปดาห์ K1x ทำได้ 80% ในสัปดาห์แรก Rho รักษา CSAT ไว้ที่ 95% ขณะรับ contact เพิ่มขึ้น 12% ต่อเดือนโดยไม่ต้องจ้างคนเพิ่ม Quest สร้าง AskQ บน Maven เชื่อมเข้ากับฐานความรู้และระบบเคสที่มีอยู่แล้วโดยไม่ต้องย้ายข้อมูล และวัดผลจากความพึงพอใจของลูกค้าแทน deflection
รีวิวของ Maven เองก็ชี้ไปทางเดียวกัน 4.8 จาก 5 จากรีวิวที่ยืนยันแล้ว 20 รายการ และควรอ่านว่าผู้ใช้พูดถึงอะไรจริงๆ: เอนจินเดียวที่รองรับทั้งแชท อีเมล และเสียง แทนบอตแยกกันหลายตัวที่ต้องคอยซิงก์ให้ตรงกัน; การดึงความรู้ที่แจ้งเตือนบทความที่ล้าสมัย ซ้ำซ้อน และขัดแย้งกัน แทนการตอบจากบทความแรกที่เจอ; การติดตั้งที่ใช้เวลาเพียงไม่กี่วันบน Salesforce หรือ Zendesk ทั้งหมดนี้คือสิ่งที่อยู่รอบๆ โมเดล
ในรายงาน Fall 2026 ของ G2 ที่ออกเมื่อวันที่ 25 สิงหาคม Maven ติดอยู่ใน Mid-Market Grid for Customer Service Automation, Mid-Market Results Index for AI Customer Support Agents และ Implementation Index for AI Customer Support Agents รายงานประเภท Index มาจากสิ่งที่ลูกค้าพูดถึงผลลัพธ์ที่ได้รับและการ rollout ไม่ใช่จากขนาดหรือชื่อเสียงของบริษัท รายงานเหล่านี้วัดสิ่งเดียวกับที่ข้อมูลภาพรวมของ G2 บอกว่ากำลังผิดพลาดในที่อื่นๆ
ช่องว่างคือประเด็นสำคัญ
ตัวเลขที่ควรให้ความสนใจคือระยะห่างระหว่าง 14% กับ 1% เพราะทั้งคู่อยู่บนโมเดลกลุ่มเดียวกัน ตัวเทคโนโลยีอธิบายช่องว่างที่กว้างขนาดนี้ไม่ได้ สิ่งที่อธิบายได้คือมีใครลงแรงสร้างส่วนที่จับคำตอบที่ผิดได้ก่อนลูกค้าจะเห็นหรือไม่ และนั่นคือเหตุผลที่อัตราการแก้ปัญหาจะมีความหมายก็ต่อเมื่อคุณรู้ว่ามันถูกวัดอย่างไร
ผู้ซื้อส่วนใหญ่ยังคงเปรียบเทียบชื่อโมเดล ส่วนผู้ให้บริการ 4 รายที่ G2 คุยด้วยเลิกทำแบบนั้นไปนานแล้ว
ถ้าคุณอยากเห็นเลเยอร์เหล่านี้ด้วยตาตัวเองแทนการอ่าน จองเดโม
ทดลองกับบทสนทนาของคุณเอง
ขอรับเดโมเฉพาะสำหรับคุณฟรี


