
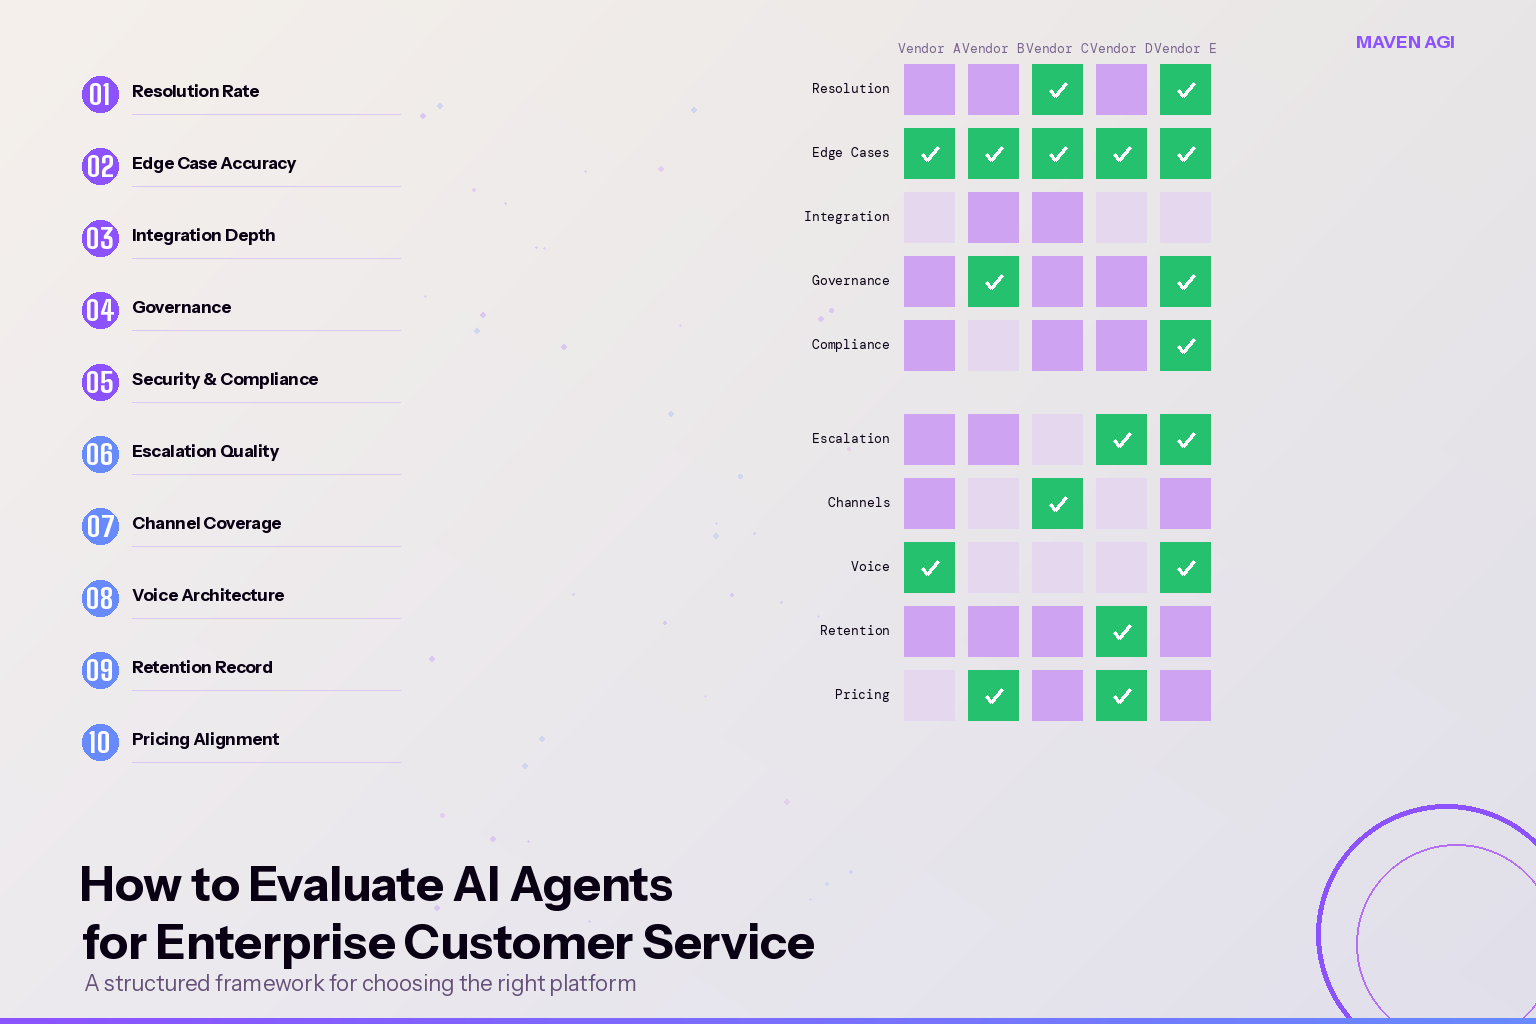
ตลาดเอเจนต์ AI สำหรับองค์กรเติบโตจนถึงจุดที่ไม่ขาดแคลนผู้ให้บริการที่อ้างว่าได้ผลลัพธ์ยอดเยี่ยม สภาพแวดล้อม Proof-of-Concept มักให้ตัวเลขที่น่าประทับใจ เช่น อัตราการทำงานอัตโนมัติ 80% หรือ 90% แต่การใช้งานที่รักษาผลลัพธ์ระดับนั้นไว้ได้จริงใน production กลับพบได้น้อยกว่ามาก ช่องว่างนี้คาดการณ์ได้หากรู้ว่าต้องดูอะไร แต่แทบมองไม่เห็นเลยหากประเมินด้วยวิธีมาตรฐาน
สิ่งที่แยกทีมที่ทำได้ถูกต้องออกจากทีมอื่นไม่ใช่เดโม แต่คือการทดสอบแพลตฟอร์มอย่างเข้มข้นกับตัวแปรที่ชี้ขาดประสิทธิภาพใน production คู่มือนี้คือคำตอบเชิงปฏิบัติว่าจะประเมินแพลตฟอร์มบริการลูกค้าด้วย AI อย่างไรโดยไม่หลงไปกับความประทับใจแรกที่ขัดเกลามาอย่างดี และจะเลือกแพลตฟอร์มบริการลูกค้าด้วย AI ที่ดีที่สุดสำหรับการใช้งานระดับองค์กรซึ่งต้องรับมือกับปริมาณงานจริงได้อย่างไร โดยอิงจากคำถามที่แยกแพลตฟอร์มที่สร้างมาเพื่อ production ออกจากแพลตฟอร์มที่สร้างมาเพื่อให้เดโมดูดี หากต้องการยึดโยงกับกรณีใช้งานบริการลูกค้าที่คุณมีอยู่จริง ให้เริ่มจากตรงนั้นแล้วย้อนกลับมากำหนดเกณฑ์
เริ่มจากเข้าใจว่าคุณกำลังประเมินอะไรอยู่จริงๆ
การประเมินผู้ให้บริการส่วนใหญ่เริ่มต้นด้วยการขอเดโมและจบลงด้วยการโทรคุยกับลูกค้าอ้างอิง กระบวนการนี้ออกแบบมาสำหรับซอฟต์แวร์ที่ทำงานตามที่ตั้งค่าไว้ แต่เอเจนต์ AI ต่างออกไป ประสิทธิภาพในการสาธิตภายใต้การควบคุมมักบอกอะไรได้น้อยเกี่ยวกับประสิทธิภาพใน production ตัวแปรที่สำคัญที่สุดใน production ได้แก่ การกระจายตัวของคำถาม ความถี่ของ edge case ความเสถียรของการผสานระบบ และพฤติกรรมเมื่อรับโหลดสูง ล้วนเป็นตัวแปรที่เดโมถูกจัดเตรียมมาเพื่อหลีกเลี่ยง
ก่อนเริ่มการประเมินใดๆ ควรทำความชัดเจนใน 3 เรื่องต่อไปนี้
การแก้ไขปัญหาหมายถึงอะไรสำหรับกรณีใช้งานของคุณ ไม่ใช่ deflection และไม่ใช่ containment การแก้ไขปัญหาแบบอัตโนมัติ หมายถึงปัญหาของลูกค้าได้รับการแก้ไข ลูกค้าไม่กลับมาติดต่อเรื่องเดิมอีก และ AI ดำเนินการได้เองโดยไม่ต้องให้คนมาทำต่อจนเสร็จ หากคุณไม่สามารถนิยามเรื่องนี้ให้ชัดเจนสำหรับผลิตภัณฑ์ของคุณก่อนเริ่มประเมิน ตัวเลขเปรียบเทียบใดๆ ที่ผู้ให้บริการนำเสนอก็จะตีความได้ยาก
ความล้มเหลวมีลักษณะอย่างไร เอเจนต์ AI ที่จัดการ 80% ของการโต้ตอบได้ดี แต่จัดการอีก 20% ผิดพลาดจนทำลายความเชื่อมั่น ไม่ถือเป็นความสำเร็จของการใช้งาน การรู้รูปแบบความล้มเหลวของคุณ เช่น การคืนเงินผิดพลาด การเปลี่ยนแปลงบัญชีที่ไม่ถูกต้อง หรือการส่งต่อเรื่องที่บริบทสูญหาย จะช่วยให้คุณนำเรื่องเหล่านี้มาใส่ในการประเมินได้ แทนที่จะมาพบหลังเปิดใช้งาน
สภาพการผสานระบบที่แท้จริงของคุณเป็นอย่างไร ช่องว่างด้านประสิทธิภาพระหว่าง sandbox กับ production แทบทุกครั้งมีต้นเหตุมาจากการผสานระบบ เอเจนต์ที่ถูกประเมินด้วยตัวอย่างฐานความรู้บางส่วนจะทำงานต่างจากเอเจนต์ที่เชื่อมต่อกับ CRM ระบบทิกเก็ต และแพลตฟอร์มเรียกเก็บเงินที่ใช้งานจริง ยิ่งทดสอบด้วยการเข้าถึงระบบจริงได้เร็วเท่าไร ผลลัพธ์ก็ยิ่งคาดการณ์ได้แม่นยำมากขึ้นเท่านั้น
คำถามที่เผยให้เห็นความสามารถใน production
การประเมินผู้ให้บริการแบบมาตรฐานมักวนอยู่กับฟีเจอร์และราคา คำถามเหล่านี้ออกแบบมาเพื่อเผยสิ่งที่เจาะจงกว่านั้น นั่นคือแพลตฟอร์มถูกออกแบบมาให้สอดคล้องกับการทำงานจริงของงานซัพพอร์ตระดับองค์กรหรือไม่
คุณนิยามการแก้ไขปัญหาแบบอัตโนมัติอย่างไร และวัดผลอย่างไร คำตอบจะบอกคุณได้มากกว่าตัวเลขเปรียบเทียบใดๆ ผู้ให้บริการที่มีประสบการณ์ใน production จริงจะมีนิยามและวิธีการวัดผลที่ชัดเจน พวกเขาแยกแยะระหว่างทิกเก็ตที่ AI ปิดได้ ทิกเก็ตที่ถูกเบี่ยงไปยัง self-service และทิกเก็ตที่ไปถึงมือเจ้าหน้าที่ ส่วนผู้ให้บริการที่มุ่งเน้นผลลัพธ์ในเดโมมักนำสิ่งเหล่านี้มารวมกัน ลองขอให้พวกเขาอธิบายว่าในระบบของพวกเขา ทิกเก็ตที่แก้ไขแล้วถูกจัดประเภทต่างจากทิกเก็ตที่ถูกเบี่ยงอย่างไร
อัตราการติดต่อกลับภายใน 72 ชั่วโมงของคุณเป็นเท่าไร นี่คือตัวชี้วัดที่เปิดโปงการแก้ไขปัญหาที่ไม่จริง หากการโต้ตอบจำนวนมากที่ถูกระบุว่าแก้ไขแล้วกลับทำให้ลูกค้ารายเดิมติดต่อซัพพอร์ตอีกครั้งภายใน 3 วัน อัตราการแก้ไขปัญหาที่แท้จริงก็ต่ำกว่าตัวเลขที่ประกาศ นี่คือความแตกต่างเดียวกับที่แยกdeflection ออกจาก resolution ผู้ให้บริการที่มุ่งเน้น production จะติดตามตัวชี้วัดนี้ ส่วนผู้ที่ไม่ติดตามกำลังวัดผิดสิ่ง
เอเจนต์สามารถดำเนินการในระบบหลังบ้านของเราได้ หรือทำได้แค่แสดงข้อมูล การผสานระบบแบบอ่านอย่างเดียวกับแบบอ่านและเขียนได้คือเส้นแบ่งด้านสถาปัตยกรรม เอเจนต์ที่บอกลูกค้าได้ว่าคำสั่งซื้อล่าช้าแต่เลื่อนกำหนดจัดส่งใหม่ไม่ได้ ไม่ได้กำลังแก้ไขปัญหา แค่ตอบคำถามเท่านั้น สำหรับกรณีใช้งานซัพพอร์ตระดับองค์กรส่วนใหญ่ การแก้ไขปัญหาอย่างแท้จริงต้องมีสิทธิ์เขียนข้อมูลในระบบหลังบ้านอย่างน้อย 2 หรือ 3 ระบบ ลองถามว่าการผสานระบบใดมีให้ใช้ผ่านตัวเชื่อมต่อสำเร็จรูป และใดต้องพัฒนาเพิ่มเอง
การส่งต่อเรื่องทำงานอย่างไร และบริบทจะเป็นอย่างไร จังหวะการส่งต่อเรื่องคือจุดที่การใช้งาน AI ส่วนใหญ่สร้างความติดขัดแทนที่จะขจัดมัน เมื่อเอเจนต์ส่งต่อให้เจ้าหน้าที่ เจ้าหน้าที่ได้รับสรุปบทสนทนาและประวัติบัญชีของลูกค้าหรือไม่ หรือลูกค้าต้องเริ่มต้นใหม่ทั้งหมด ทดสอบเรื่องนี้โดยเฉพาะระหว่างการประเมิน เพราะนี่คือการโต้ตอบที่มีแนวโน้มก่อให้เกิดข้อร้องเรียนมากที่สุด และมักถูกมองข้ามในเดโมมากที่สุด
เอเจนต์ทำอย่างไรเมื่อไม่รู้คำตอบ การล้มเหลวอย่างเหมาะสมสำคัญพอๆ กับการทำงานได้ดี สังเกตว่าระบบจัดการกับคำถามที่อยู่นอกเหนือการฝึก คำขอที่คลุมเครือ และความพยายามจงใจให้ระบบสร้างผลลัพธ์ที่ไม่ดีอย่างไร ผู้ให้บริการที่มั่นใจในการรับมือกรณีเหล่านี้จะยอมให้คุณทดสอบระหว่างการประเมิน ส่วนผู้ที่พยายามหลีกเลี่ยงการทดสอบเหล่านี้มักมีเหตุผลบางอย่าง
การผสานระบบใช้เวลานานเท่าไร หากคำตอบตามจริงคือหลายเดือน นั่นก็เป็นข้อมูลที่มีประโยชน์ การใช้งานระดับองค์กรที่ต้องอาศัยบริการผู้เชี่ยวชาญเป็นเวลานานก่อนเปิดใช้งานจะมีต้นทุนและความเสี่ยงสูง สถาปัตยกรรมแบบ overlay ที่เชื่อมต่อกับเฮลป์เดสก์เดิมโดยไม่ต้องย้ายข้อมูลมักเปิดใช้งานได้ภายในไม่กี่สัปดาห์ ขอกรอบเวลาที่ชัดเจนตั้งแต่ลงนามสัญญาจนถึงการโต้ตอบจริงครั้งแรก
กับดักของ Proof-of-Concept
POC แทบเป็นส่วนหนึ่งของการประเมิน AI ระดับองค์กรทุกครั้ง และเกือบทุกครั้งให้ผลลัพธ์ดีกว่าการใช้งานจริงใน production ซึ่งไม่ใช่เรื่องบังเอิญ POC ทำงานบนข้อมูลที่สะอาด ขอบเขตคำถามที่จำกัด และได้รับการสนับสนุนจากฝั่งผู้ให้บริการ โดยถูกปรับแต่งมาเพื่อการประเมิน ขณะที่การใช้งานใน production ต้องรับคำถามลูกค้าทุกรูปแบบ เชื่อมต่อกับระบบที่ไม่เคยถูกออกแบบมาให้ทำงานร่วมกับ AI และดูแลโดยทีมที่มีงานอื่นต้องทำด้วย
เพื่อปิดช่องว่างนี้ ให้ผลักดันเงื่อนไขของ POC ให้ใกล้เคียงกับ production จริง ใช้คำถามจริงจากฐานลูกค้าของคุณ ไม่ใช่แค่ตัวอย่าง เชื่อมต่อกับระบบที่เทียบเท่า production ไม่ใช่ sandbox ทดสอบนานพอที่จะเห็นประสิทธิภาพเข้าสู่สภาวะคงที่ ไม่ใช่แค่ช่วงแรกที่ถูกปรับแต่งมา และถามว่าคำถามระหว่าง POC กี่เปอร์เซ็นต์อยู่ในขอบเขตที่ตั้งค่าไว้ล่วงหน้าเทียบกับที่อยู่นอกขอบเขต โครงการนำร่องส่วนใหญ่ที่ดูดีในเดโมไม่เคยไปถึง production และเหตุผลก็ซ้ำกันมากพอที่จะวางแผนรับมือได้ บทวิเคราะห์ช่องว่างระหว่างโครงการนำร่องกับ production อธิบายสิ่งที่แยกทั้งสองออกจากกัน
ผู้ให้บริการที่ยินดีทำ POC ภายใต้เงื่อนไขเหล่านี้คือผู้ที่สร้างระบบเพื่อ production ส่วนผู้ที่ยืนกรานจะควบคุมเงื่อนไขอย่างใกล้ชิดกำลังมุ่งเน้นแค่ตัว POC เอง
การประเมินที่เข้มงวดในทางปฏิบัติเป็นอย่างไร
การประเมินที่แข็งแกร่งที่สุดมาจากทีมที่มองการเลือกผู้ให้บริการเป็นการตัดสินใจเชิงวิศวกรรม ไม่ใช่แค่พิธีการจัดซื้อ เมื่อ Clio แพลตฟอร์มเทคโนโลยีด้านกฎหมาย ตั้งเป้าแทนที่บอทแบบสคริปต์รุ่นเก่า ทีมงานได้ประเมินผู้ให้บริการ 32 ราย จากนั้นทดสอบเปรียบเทียบแบบตัวต่อตัวกับผู้ให้บริการมากกว่า 10 รายก่อนเลือก Maven พวกเขาทดสอบตามความต้องการจริง ได้แก่ การตอบคำถามในแชทภายในแอปอย่างแม่นยำ การผสานระบบเชิงลึกกับ stack ที่มีอยู่ รวมถึง Salesforce และประสิทธิภาพกับ edge case ที่ทำให้ระบบแบบสคริปต์ล้มเหลว
ผลลัพธ์ยืนหยัดได้ใน production ไม่ใช่แค่ในเดโม ได้แก่ การแก้ไขปัญหาแบบอัตโนมัติ 80% และการซัพพอร์ตโดยเจ้าหน้าที่เร็วขึ้น 4x สำหรับคำถามเชิงเทคนิคที่ยังต้องส่งถึงมือคน การผสานกันระหว่างอัตราการแก้ไขปัญหาอัตโนมัติที่สูงกับการจัดการกรณียกเว้นที่รวดเร็วขึ้น คือเครื่องหมายของการประเมินที่ทดสอบเพื่อ production ไม่ใช่เพื่อความประทับใจแรก และยังเป็นสิ่งที่ทีม CX ชั้นนำมีเหมือนกัน นั่นคือการออกแบบการประเมินให้พบจุดล้มเหลวก่อนลงนาม ไม่ใช่หลังจากนั้น
Compliance ไม่ใช่ส่วนเสริม
สำหรับการใช้งานระดับองค์กรส่วนใหญ่ เส้นทางจาก POC สู่ production ต้องผ่านการตรวจสอบด้านความปลอดภัย ซึ่งเป็นจุดที่การประเมินเอเจนต์ AI จำนวนมากหยุดชะงักหรือล้มเหลวไปเลย ข้อกำหนดด้าน compliance สำหรับเอเจนต์ AI ที่จัดการข้อมูลลูกค้า ประมวลผลธุรกรรม และดำเนินการในระบบ production ได้เองนั้นมีมาก และองค์กรส่วนใหญ่ยังไม่พร้อมอย่างที่คิด จากผลสำรวจของ Grant Thornton ในปี 2026 ผู้บริหาร 78% ระบุว่าไม่มั่นใจว่าจะผ่านการตรวจสอบ AI ได้ภายใน 90 วัน
ประเมินความพร้อมด้าน compliance ตั้งแต่เนิ่นๆ ไม่ใช่เป็นด่านสุดท้าย โดยเฉพาะ: ผู้ให้บริการได้รับ SOC 2 Type II หรือไม่ มี HIPAA BAA ให้หรือไม่ มีข้อตกลงการประมวลผลข้อมูลตาม GDPR หรือไม่ และสอดคล้องกับ PCI-DSS สำหรับเวิร์กโฟลว์ที่เกี่ยวข้องกับการชำระเงินหรือไม่ มี audit trail ที่เรียกดูและสืบค้นได้สำหรับทุกการดำเนินการของเอเจนต์หรือไม่ ผู้ประมวลผลข้อมูลช่วงของผู้ให้บริการผ่านการประเมินและเปิดเผยข้อมูลแล้วหรือไม่ และแพลตฟอร์มทำงานภายใต้ข้อกำหนดด้านถิ่นที่อยู่ของข้อมูลของคุณได้หรือไม่
ผู้ให้บริการที่มีโครงสร้างพื้นฐานด้าน compliance ระดับองค์กรอย่างแท้จริงจะตอบคำถามเหล่านี้ด้วยเอกสาร ไม่ใช่แค่คำรับรอง ส่วนผู้ที่มอง compliance เป็นเพียงช่องให้ติ๊กในช่วงท้าย คือผู้ที่มีแนวโน้มจะไม่ผ่านการตรวจสอบความปลอดภัยมากที่สุด หลังจากที่คุณลงทุนกับการประเมินไปแล้ว
การโทรคุยกับลูกค้าอ้างอิงที่คุณควรขอ
การโทรคุยกับลูกค้าอ้างอิงส่วนใหญ่ถูกจัดขึ้นเพื่อยืนยันประสบการณ์เชิงบวก ให้ขอคุยกับลูกค้าที่มีการใช้งานที่ยากลำบากแทน คือรายที่ต้องแก้ไขปัญหาอย่างมากก่อนระบบจะทำงานได้ดี วิธีที่ผู้ให้บริการจัดการการใช้งานนั้นบอกคุณได้มากกว่าการใช้งานที่ราบรื่น 3 ราย
ถามลูกค้าอ้างอิงโดยเฉพาะว่าเกิดปัญหาอะไรขึ้น ใช้เวลาแก้ไขนานเท่าไร และได้รับการสนับสนุนที่ต้องการหรือไม่ คำตอบจะชี้ว่าคุณอยากทำงานกับผู้ให้บริการรายนี้ต่อไปหรือไม่เมื่อการใช้งานใน production ผ่านไป 18 เดือน
ประเมินแบบที่คาดการณ์ผลลัพธ์ใน production ได้
ผู้ให้บริการทุกรายผ่านเดโมได้ แต่มีน้อยกว่ามากที่ผ่านการประเมินซึ่งออกแบบมาเพื่อเผยให้เห็นสิ่งที่เกิดขึ้นกับปริมาณงานจริง บนระบบจริง และภายใต้การตรวจสอบความปลอดภัยจริง ใช้คำถามเหล่านี้เป็นแบบประเมิน ทำ POC ด้วยคำถามที่ยากที่สุดของคุณ และให้น้ำหนักกับลูกค้าอ้างอิงที่ใช้งานใน production มากกว่ารางวัลจากนักวิเคราะห์ ทีมที่ทำเช่นนี้อย่างสม่ำเสมอคือทีมที่ระบบยังคงทำงานได้ดีแม้ผ่านไปแล้ว 1 ปี
ดูว่ากรอบการประเมินนี้รับมือกับปริมาณทิกเก็ตของคุณได้อย่างไร จองเดโม แล้วนำคำถามที่คุณคิดว่าจะทำให้ระบบล้มเหลวมาทดสอบ
ทดลองกับบทสนทนาของคุณเอง
ขอรับเดโมเฉพาะสำหรับคุณฟรี


