
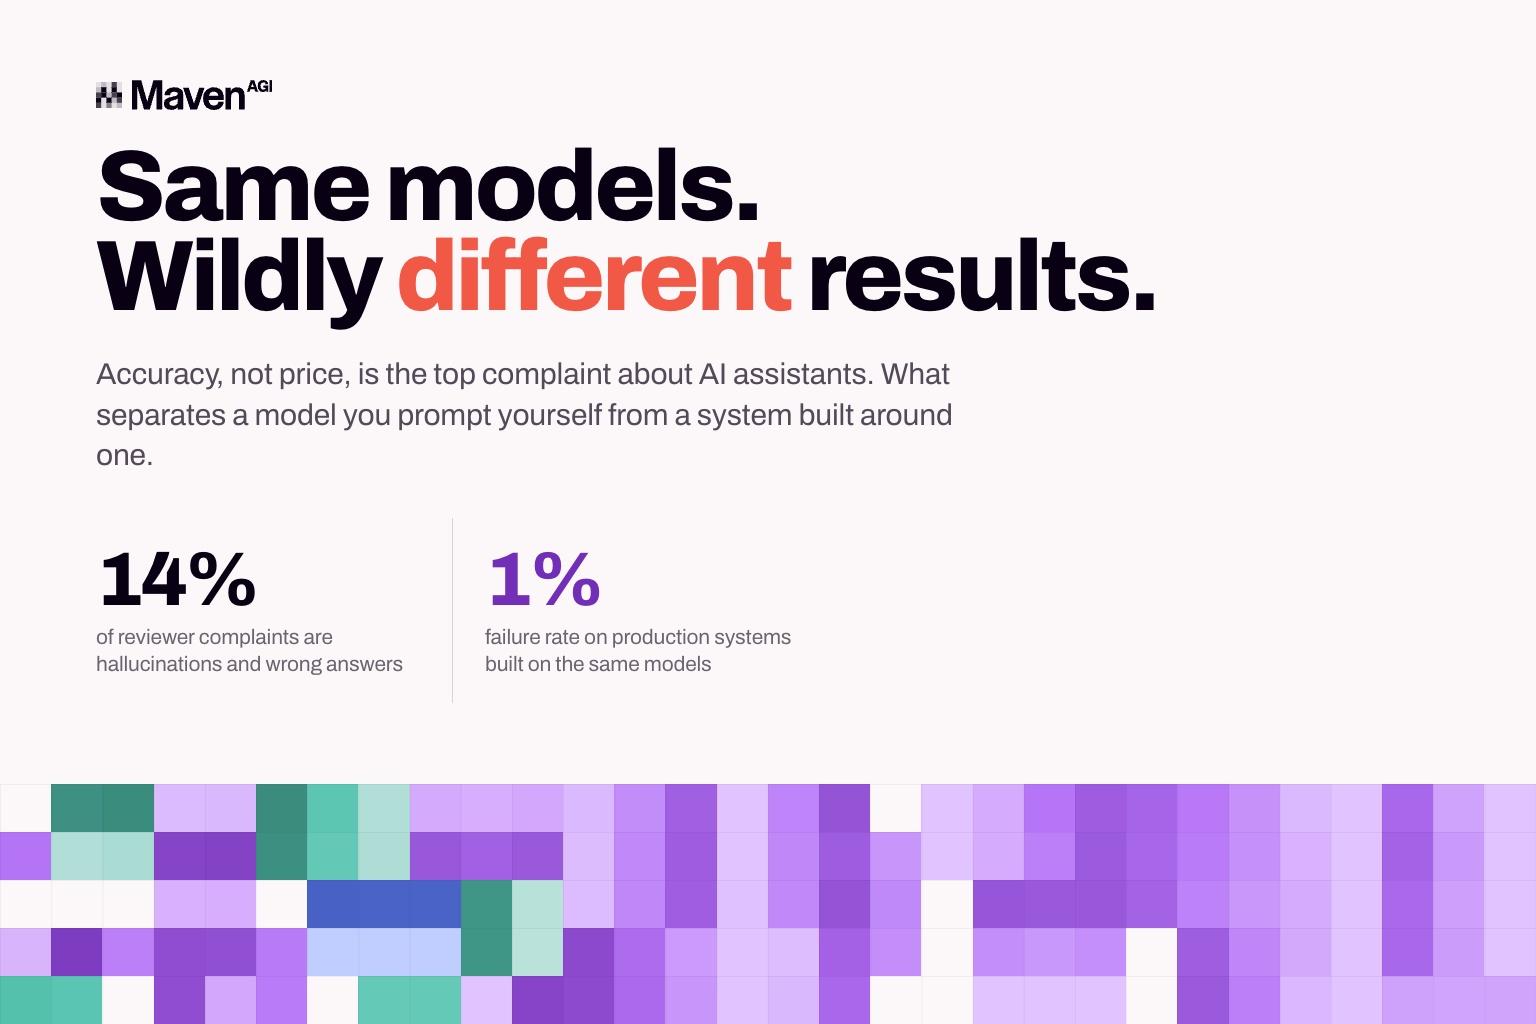
A G2 analisou mais de 2 950 avaliações verificadas publicadas entre janeiro e meados de julho e procurou perceber do que as pessoas mais se queixam. A maior queixa não foi o preço, mas sim a precisão. As alucinações e as respostas erradas representaram 14 % de tudo aquilo de que os avaliadores disseram não gostar, o que as colocou à frente do custo, num ano em que o custo é o único tema que todos querem discutir.
Vale a pena saber quem são esses avaliadores, porque isso muda o significado do número. A maioria refere-se aos assistentes de uso geral que toda a gente tem abertos num separador do browser. Não são equipas de CX a descrever um agente de apoio em produção. São pessoas que fazem uma pergunta a um modelo, recebem uma resposta dada com toda a confiança e depois têm de descobrir sozinhas se é verdadeira.
Depois, a G2 foi falar com 4 fornecedores que constroem sistemas de produção sobre esses mesmos modelos e perguntou-lhes quais são, na realidade, as suas taxas de falha. Apenas 1 %, nalguns casos.
Portanto, o que está realmente em comparação não é um modelo contra outro. É um modelo a que o próprio utilizador dá instruções contra um sistema que alguém construiu em torno de um modelo: a mesma tecnologia por baixo, resultados radicalmente diferentes. A Maven foi um dos 4 fornecedores consultados pela G2.
O que explica a diferença
Nada do que esses 4 fornecedores descreveram tinha a ver com o modelo escolhido. Todos disseram mais ou menos o mesmo. Os seus sistemas funcionam por etapas e não de uma só vez. As respostas são obtidas a partir de dados em tempo real, e não daquilo que o modelo por acaso se lembra do treino. Medem com que frequência uma tarefa é efetivamente concluída e reescrevem prompts e lógica pelo menos semanalmente. Um deles fá-lo diariamente. É tudo trabalho feito em torno do modelo, não no próprio modelo.
O ponto mais útil em que concordaram é onde o esforço é aplicado. Os 4 afirmaram que a parte difícil não é a pergunta do dia a dia, mas sim os casos excecionais e as tarefas com várias etapas. Por isso, constroem sistemas que reconhecem quando estão fora do seu alcance e passam a conversa a uma pessoa em vez de arriscarem um palpite. A frase da Maven no inquérito foi que «autonomia sem uma lógica de recurso fiável não é uma funcionalidade; é um risco».
Aí está a maior parte da diferença. Quando é o próprio utilizador a dar instruções a um modelo, é ele quem tem de verificar o trabalho. Um sistema de produção é construído para que essa tarefa nunca recaia sobre o cliente. A G2 disse-o claramente: estes fornecedores não têm menos falhas, detetam-nas antes que alguém dê por elas.
O debate entre agente e chatbot é sobretudo uma questão de palavras
A G2 perguntou diretamente aos 4 fornecedores se os agentes de IA são mais fiáveis do que aquilo a que a categoria ainda chama chatbots. Todos responderam mais ou menos o mesmo, e não é uma boa notícia para quem vende com base na palavra. Em produção, os dois não são tão diferentes como o marketing sugere, e trocar um rótulo pelo outro não resolve nada por si só.
Isto importa mais para os compradores do que para os fornecedores. Quem procura a palavra «agente» está a comprar um rótulo, não uma capacidade. Um fornecedor chamar agente ao seu produto e outro chamar-lhe outra coisa não diz nada sobre se algum deles consulta o seu conhecimento atual, reconhece quando não tem certeza ou é verificado com base em conversas reais após o lançamento. Estas são propriedades da IA agêntica no serviço ao cliente, e nenhuma delas vem incluída no rótulo.
As perguntas que realmente esclarecem dizem respeito à forma como a solução é construída, e é possível fazer as 5 numa primeira reunião.
- De onde vêm as respostas? A solução consulta o seu conhecimento em tempo real ou baseia-se no que o modelo absorveu durante o treino?
- O que acontece quando não tem certeza? Encaminha para uma pessoa ou arrisca um palpite com o mesmo tom confiante que usa quando está certa?
- Com que frequência alguém verifica as respostas com base em conversas reais, e o que está a ser medido?
- A sua equipa consegue alterar o comportamento do agente ou cada ajuste tem de passar pelo fornecedor?
- Consegue efetivamente executar ações nos seus sistemas ou apenas diz ao cliente o que fazer?
Se um fornecedor conseguir responder às 5, alguém fez o trabalho. Se responder bem à primeira e ficar vago a partir daí, comprou um modelo e colocou-lhe um widget à volta. Existe uma versão mais longa desta lista no nosso guia para avaliar agentes de IA para o serviço ao cliente empresarial.
As partes que os compradores ignoram
O que esses 4 fornecedores descreveram é a mesma estrutura em que assenta a arquitetura de 5 camadas da Maven. O modelo é uma das camadas. Tudo o que o torna fiável está à sua volta: o que o agente sabe, o que lhe é permitido fazer, como se verifica o seu trabalho depois de entrar em produção e quem controla as salvaguardas. Os compradores costumam escolher pelo modelo, porque é a camada associada aos nomes famosos. Tudo aquilo para que os dados da G2 apontam está nas outras 4, e é por isso que a resolução autónoma é algo diferente de uma boa resposta.
É também por isso que rapidez de implementação e fiabilidade não são opostas, ao contrário do que a categoria pressupõe. Construir essas camadas é verdadeira engenharia, mas é feita uma única vez, dentro da plataforma, em vez de se transformar num projeto de 6 meses na infraestrutura de cada cliente.
Como é quando o trabalho já foi feito
A Mastermind atingiu 93 % de resolução autónoma em 6 semanas. A K1x chegou aos 80 % na primeira semana. A Rho manteve um CSAT de 95 % enquanto absorvia mais 12 % de contactos por mês, sem contratar ninguém. A Quest construiu o AskQ na Maven, ligou-o a uma base de conhecimento e a um sistema de casos já existentes, sem qualquer migração de dados, e avalia-o pela satisfação do cliente e não pela deflexão.
As avaliações da própria Maven apontam no mesmo sentido. 4,8 em 5 em 20 avaliações verificadas, e vale a pena ler o que as pessoas realmente destacam: um único motor para chat, email e voz, em vez de bots separados que é preciso manter sincronizados; uma recuperação de conhecimento que assinala artigos desatualizados, duplicados e contraditórios, em vez de responder com base no primeiro que encontra; uma configuração medida em dias sobre o Salesforce ou o Zendesk. Tudo isso é o que está em torno do modelo.
Nos relatórios Fall 2026 da G2, publicados a 25 de agosto, a Maven figurou na Mid-Market Grid for Customer Service Automation, no Mid-Market Results Index for AI Customer Support Agents e no Implementation Index for AI Customer Support Agents. Os relatórios Index baseiam-se no que os clientes dizem sobre os resultados obtidos e sobre a forma como decorreu a implementação, e não na dimensão ou notoriedade de uma empresa. Medem exatamente aquilo que, segundo os dados mais amplos da G2, está a correr mal em todo o lado.
A diferença é o que importa
O número a que vale a pena prestar atenção é a distância entre 14 % e 1 %, porque ambos assentam no mesmo pequeno conjunto de modelos. Nada na tecnologia explica uma diferença tão grande. O que a explica é se alguém se deu ao trabalho de construir as partes que detetam uma má resposta antes de o cliente a ver, e é por isso que uma taxa de resolução só tem significado quando se sabe como foi medida.
A maioria dos compradores continua a comparar nomes de modelos. Os 4 fornecedores com quem a G2 falou deixaram de o fazer há algum tempo.
Se preferir ver as camadas em vez de ler sobre elas, marque uma demonstração.
Veja-o nas suas próprias conversas.
Peça uma demonstração personalizada gratuita.


