

Hoje lançamos os Intelligent Fields, a resposta da Maven AGI para captar e organizar os dados gerados em cada interação com o cliente que podem orientar decisões de negócio, oportunidades de upsell, atualizações de produto e outras áreas estratégicas críticas da sua organização.
O seu agente de IA já lê todas as conversas. Resolve pedidos, responde a perguntas e gere o volume. Mas, quando a conversa termina, tudo o que aprendeu desaparece. Nenhum registo do motivo da frustração do cliente. Nenhum alerta de que mencionou sair. Nenhum sinal de que o mesmo problema surgiu 11 vezes esta semana.
A transcrição existe. Os dados não.
A solução habitual é a etiquetagem manual: campos personalizados no service desk, preenchidos pelos agentes. Funciona até o volume disparar, entrarem novos agentes ou a taxonomia se desviar. Depois, o cumprimento cai e os dados deixam de ser fiáveis.
Eis porque a etiquetagem manual, a resposta por defeito a que a maioria das equipas chega, não resolve realmente o problema.
A armadilha da etiquetagem manual
A etiquetagem manual tem uma falha fatal: depende de pessoas a fazê-la de forma consistente e em escala. Isso não acontece. O volume dispara, entram novos agentes, os casos excecionais ficam por tratar. O cumprimento cai e os dados tornam-se discretamente pouco fiáveis, muitas vezes sem que ninguém repare até os relatórios parecerem errados.
Mas mesmo uma etiquetagem perfeita tem limites. As listas pendentes captam categorias. Não captam contexto. A diferença entre um cliente frustrado e um cliente prestes a sair não é uma etiqueta. São 4 frases perdidas a meio de uma transcrição.
O que é realmente necessário
Os dados estruturados das conversas têm de ser extraídos automaticamente, a partir da transcrição completa, com algo que compreenda a linguagem, e não por correspondência de palavras-chave.
É isso que os Intelligent Fields fazem.
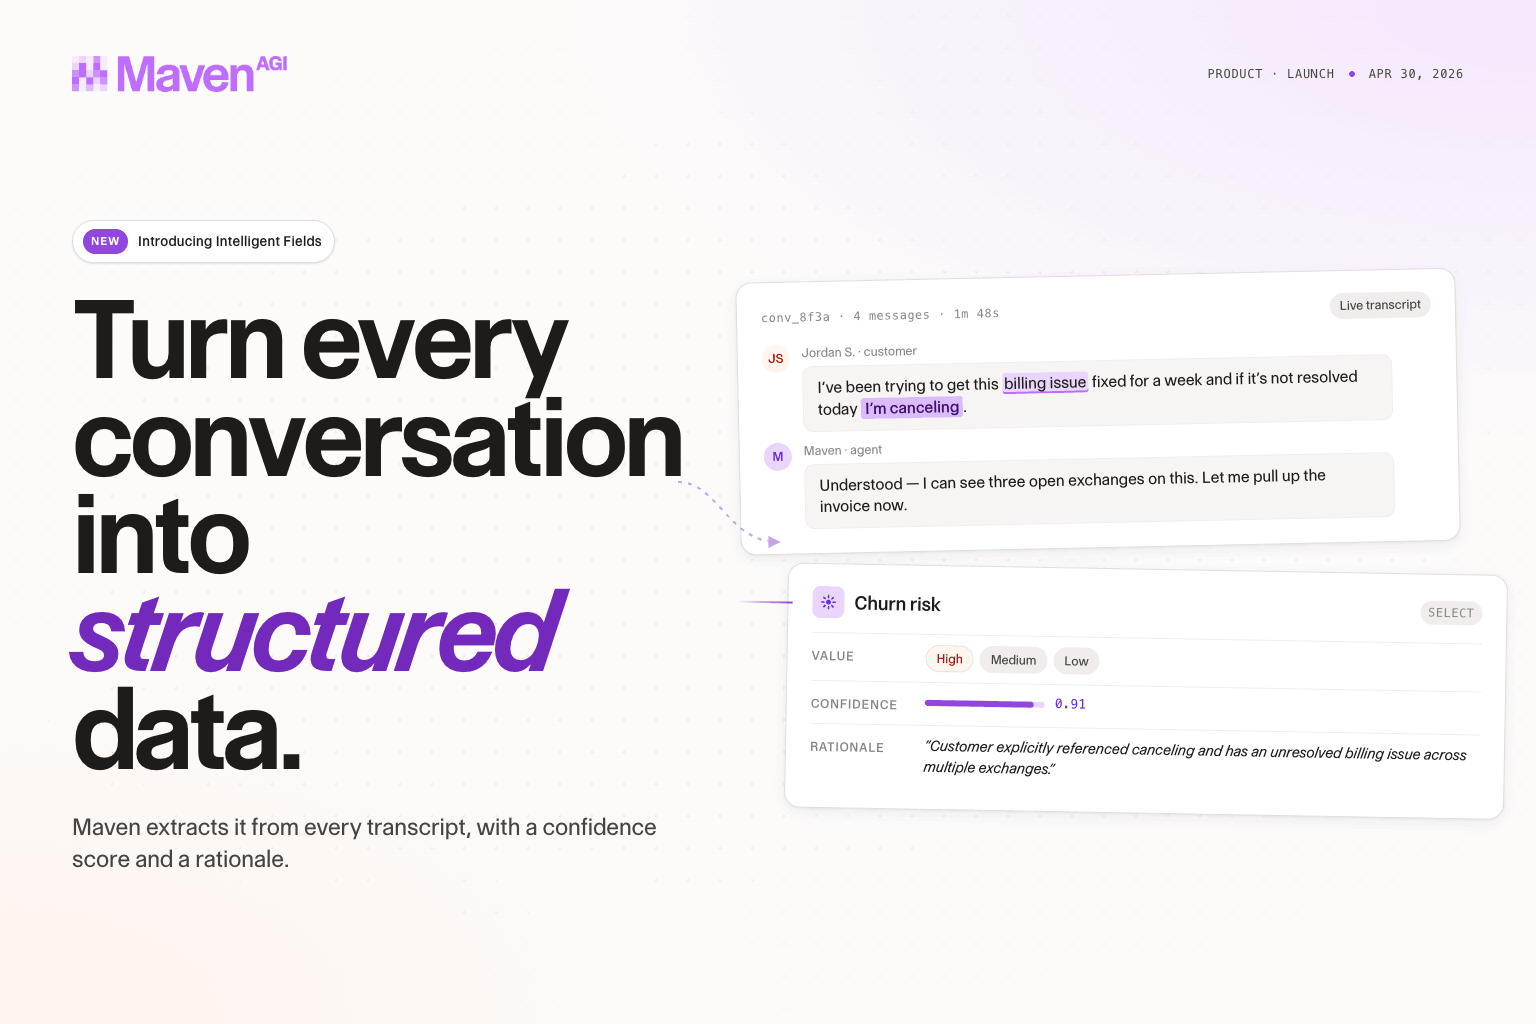
Define um campo: um nome, um tipo (texto, sim/não, seleção, número ou seleção múltipla) e instruções em linguagem simples que descrevem o que o campo deve captar. O agente Maven avalia-o automaticamente em cada conversa. O resultado fica guardado, pesquisável e associado à conversa, com uma pontuação de confiança e uma justificação que explica a classificação.
Um exemplo concreto: risco de abandono
Na prática, funciona assim. Cria um campo Risco de abandono, do tipo Seleção, com 3 opções: Alto, Médio, Baixo. As instruções são em linguagem simples: atribuir Alto se o cliente mencionar o cancelamento, manifestar frustração com a faturação ou tiver um problema por resolver ao longo de várias trocas de mensagens.
É toda a configuração necessária. Depois de publicado, o agente avalia-o em cada conversa.
Para um cliente que escreveu "Ando há uma semana a tentar resolver isto e, se não ficar resolvido hoje, vou cancelar", o campo devolve Alto, com confiança de 0,91, e a justificação: "O cliente referiu explicitamente o cancelamento e tem um problema de faturação por resolver ao longo de várias trocas de mensagens."
Esse registo pode agora ser consultado. Todas as conversas com Risco de abandono = Alto nos últimos 30 dias. Encaminhe-as em tempo real para um especialista em retenção. Envie-as para o seu CRM.
A configuração demora minutos, não sprints
Tudo está no Agent Designer. Defina um campo em linguagem simples, escolha o tipo e publique. Sem código. Está disponível uma API REST completa para as equipas que pretendam uma gestão programática.
O que isto torna possível
As equipas de suporte que tiram mais partido dos seus agentes de IA não os usam apenas para resolver pedidos mais depressa. Usam-nos para perceber o que está a acontecer em todas as conversas, numa escala que nenhum processo de revisão humana conseguiria igualar.
Os Intelligent Fields tornam isso possível. Cada conversa tratada pelo seu agente passa a ser um registo de dados estruturado. Cada registo é pesquisável. Cada tendência fica visível.
Veja-o nas suas próprias conversas.
Peça uma demonstração personalizada gratuita.


