
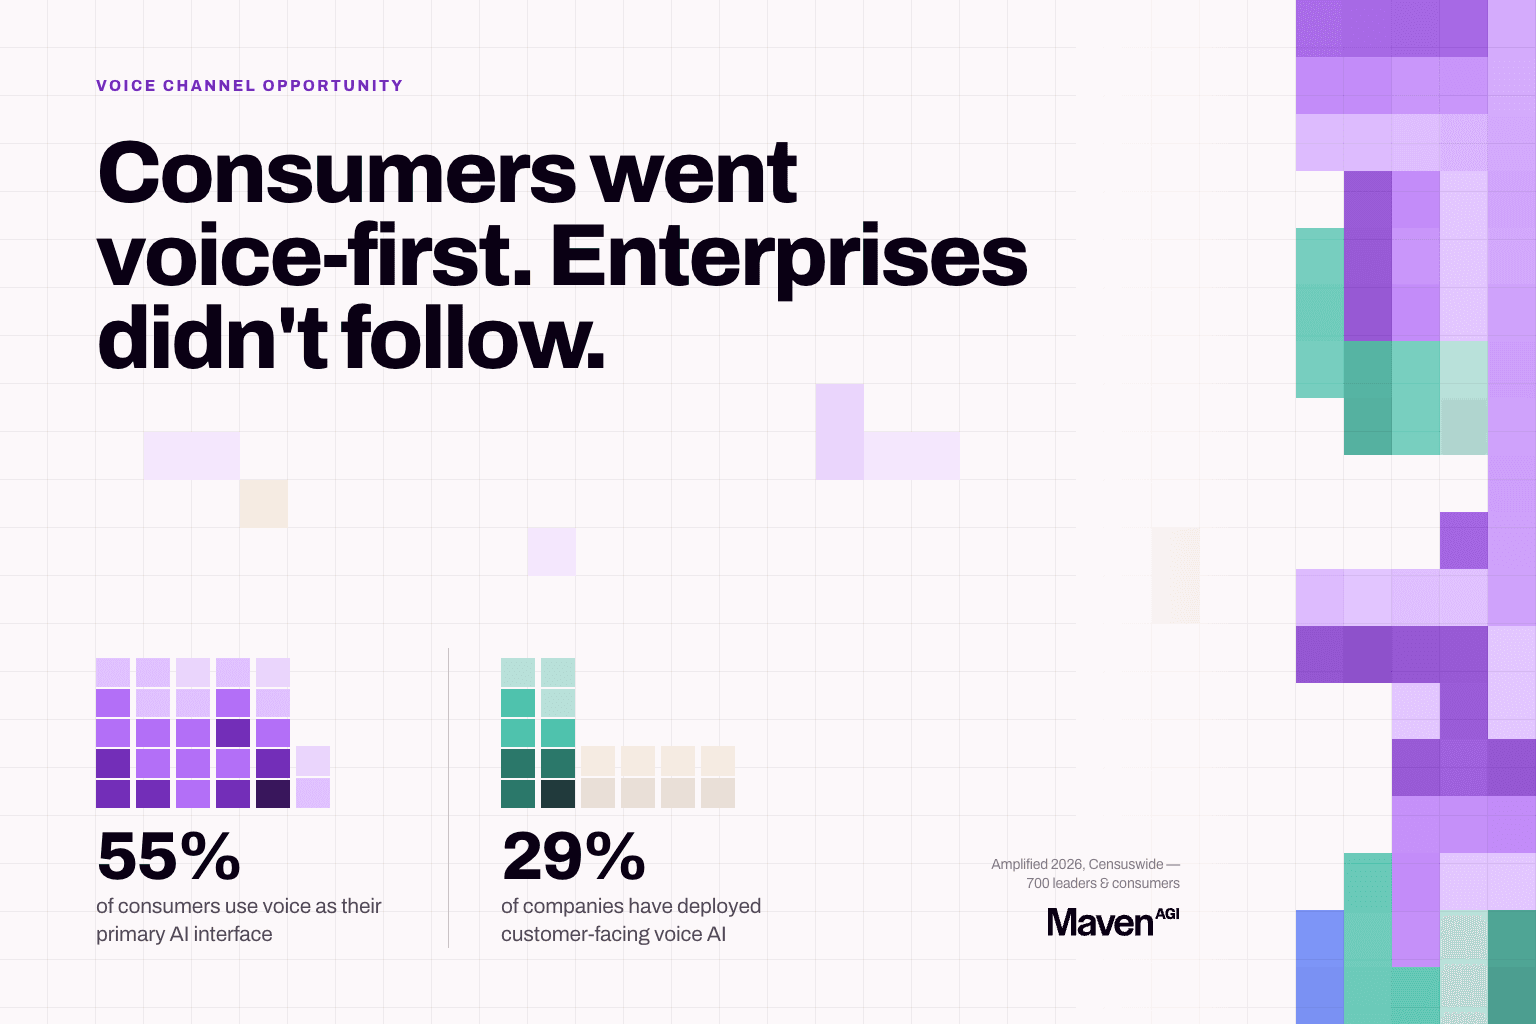
音声をめぐる消費者の行動は、エンタープライズの準備よりも速く変化しました。Censuswideがビジネスリーダーと消費者700人を対象に実施した調査Amplified 2026によると、消費者の55%がAIとのやり取りの主なインターフェースとして音声を使用している一方、顧客向けの音声AIを導入している企業はわずか29%にとどまっています。
音声は、カスタマーサービスにおいて最もボリュームが大きく、最もコストが高く、技術的に最も難易度の高いチャネルであると同時に、AI導入が最も遅れているチャネルでもあります。この組み合わせは珍しいものです。削減できるコストが最も大きいチャネルほど、優位性をめぐる競争が最も少ないのです。
音声を難しくしていた障壁は3つあり、いずれも現実の課題でした。レイテンシー、精度、コンプライアンスです。変わったのは、これらが未解決の研究課題から、答えのあるエンジニアリングの課題になったことです。
レイテンシーが難題だった理由
音声エージェントを構築する標準的な方法では、3つのシステムを連結します。音声をテキストに書き起こし、言語モデルがテキストを読んで返答を作成し、3つ目のシステムがそれを読み上げます。各段階は単体ではうまく機能します。問題は、段階の間に積み重なるものです。
各段階を経るたびに遅延が加わり、顧客が体感するのはその合計です。会話として自然に感じられる応答時間の目安はおおよそ300ms未満で、約1秒以上の沈黙が続くと人は再び話し始めます。最初の発話をまだ処理中のパイプラインには2つの入力が重なって届き、それらをきれいに整合させる方法がありません。
連結型の構成で失われるのは時間だけではありません。書き起こしによってテキストが生成されるため、口調、ためらい、声の大きさ、苛立ちが募っている声の様子は、最初の段階で失われます。モデルが読むのは平板な文章だけで、その発言者が今にも電話を切ろうとしていることを示す手がかりはありません。リカバリーも脆弱です。顧客が話を遮ったり、2人が同時に話したりすると、パイプラインはある段階で問題を検出し、その情報を受け取るように設計されていない前の段階へと伝えなければならないからです。
多くの音声導入がデモではうまく機能するのに、平日の午後には苦戦するのはこのためです。デモは静かで、台本どおりに進み、遮られることもありません。
単一モデルのvoice-to-voiceがもたらす変化
別のアーキテクチャを採用すれば、こうした段階をなくすことができます。1つのモデルが音声を受け取り、音声を生成します。途中でテキストに書き起こして再び音声に戻す処理はありません。
モデルが書き起こしではなく音声そのものを扱うため、パイプラインで失われていた情報が保持されます。話の遮りは遮りとしてそのまま伝わります。重なった発話、背景の雑音、聞き慣れないアクセントは、引き継ぎを破綻させる障害ではなく、モデルが対処する条件になります。中間段階がないため応答の間隔が十分に縮まり、顧客がシステムの発話にかぶせて話すこともなくなります。
これが、レイテンシーと精度は本番環境ですでに解決されているという主張の根拠です。Mavenは、voice-to-voiceエージェントを完全な本番環境で提供した初のエンタープライズAIプラットフォームであり、このことはIbexによって検証されています。voice-to-voiceでは57言語、チャットでは54言語に対応しています。Mavenが測定した導入事例では、適切に構築された音声エージェントは、同等のインテントにおいてチャットと同水準の解決率を達成しています。
技術スタックを正確に説明すると、リアルタイム音声はOpenAI Realtime APIとCartesiaの音声モデルの組み合わせで動作し、音声エージェントはチャットやメールと同じエンジンを使用します。そのため、メールを送った後に電話をかけてきた顧客が、一から説明し直す必要はありません。
タイムラインを左右する3つの判断
技術的な障壁が解消された今、導入スピードはいくつかの選択によって決まります。そしてどの選択でも、より速い選択肢のほうが、より安全でもある傾向があります。
- テレフォニー。キャリアを移行するのではなく、既存のキャリアとスタックに統合します。最初に移行を行う価値があることはまれであり、voice-to-voiceはTwilio、Vonage、Cisco、Zendesk Talk、Genesysなど、すでに運用しているシステムに接続できます。
- IVR。既存のIVRを撤去して置き換えるのではなく、オーバーレイして機能を拡張します。置き換えは到達点が高い一方、そこに至るまでの道のりがはるかに長くなります。
- エスカレーション。すべてのコンテキストをオペレーターに引き継ぐウォームハンドオフを採用します。コンテキストのないコールドハンドオフは、自動化しない場合よりも悪い結果を招きます。顧客がすべてを2度説明することになるからです。
音声がすぐに突きつけるコンプライアンスの問題
通話中、顧客は保存してはならない情報を口にします。カード番号、健康に関する情報、アカウントの認証情報などが、助けを求める中で声に出して伝えられます。
音声のコンプライアンスはテキストよりも厳格であり、後から対応させるのではなく、それを前提に構築されたプラットフォームによって解決されます。重要なのはタイミングです。通話中のリアルタイムな個人情報(PII)の秘匿化と、通話後の後処理では、情報が露出する時間帯が異なり、機密情報をパイプラインに入れずに済むのは前者だけです。どちらを導入しようとしているのかは、セキュリティレビューの最中ではなく、その前に確認してください。
音声では多言語対応が難しくなる
テキストの翻訳は十分に解決されており、ほとんどのエンタープライズはもはや心配していません。音声は同じではありません。話し言葉には、アクセントの違い、地域特有の言い回し、文の途中での言語の切り替え、話す速さの違いがあり、書き起こしではそれらが失われてしまいます。連結型のパイプラインではこの問題がさらに深刻になります。モデルが何かを受け取る前に、書き起こしの段階で言語を推測しなければならず、推測を誤るとその後のすべての段階に影響が及ぶからです。
対応言語数については、詳しく確認する価値があります。どのベンダーに対しても有効なのは、記載されている言語が本番環境でテストされているのか、それとも単にモデルカードに記載されているだけなのかを尋ねることです。
大規模なボリュームでの実証
規制市場で事業を展開するFortune 500のゲーム企業は、月間330,000件以上のやり取りで80%の解決率を達成しており、ピークとなったイベント当日には1日で13,000件のやり取りを解決しました。
ピーク日こそが本当の試金石です。ボリュームが急増する日は、キューがあふれ、システムが持ちこたえるか目に見えて性能が落ちるかが明らかになり、電話で問い合わせることが有効かどうかについて顧客が長く残る印象を形成する日です。
デモに惑わされずに音声を評価する方法
録画されたデモは証拠になりません。ライブ通話を依頼し、その通話中に、実際の顧客と同じように振る舞ってください。
- 文の途中で話を遮り、エージェントが話すのを止めるか、話し続けるかを確認する
- リクエストの途中で考えを変える
- 背景に雑音を加える
- ベンダーが想定していないアクセントで話す
- 何かを教えてもらうだけでなく、何かを実行するよう依頼する
最後の項目が最も重要です。質問に答えることと取引を完了することは異なる能力であり、自律解決には後者が必要です。
3つの判断を簡潔にまとめたものが 音声AIの意思決定ツリー です。音声を最初に自動化するチャネルとして検討しているチームには、 90日間パイロットのスコープ と併せてご活用いただけます。いずれも State of AI in CX 2026レポート の「Voice Channel Opportunity」の章をもとにしています。
自社の会話でお試しください。
無料の個別デモをお申し込みください。


