
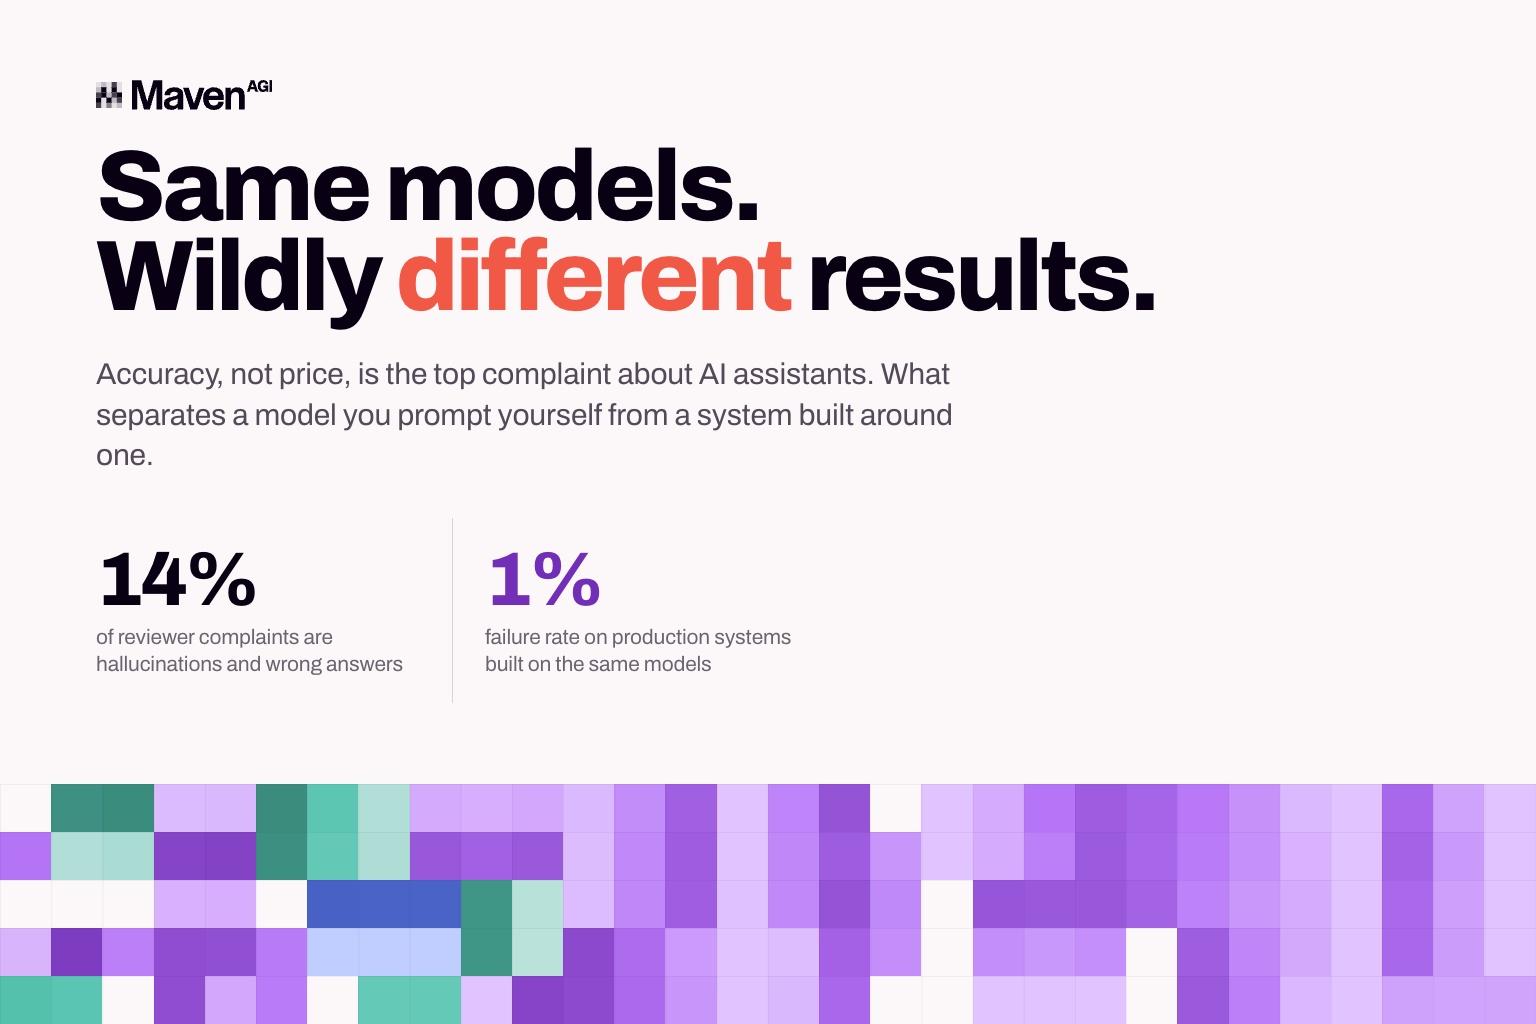
G2, Ocak ile Temmuz ortası arasında 2.950'den fazla doğrulanmış yorumu inceledi ve kullanıcıların en çok neden şikâyet ettiğine baktı. En büyük şikâyet fiyat değil, doğruluktu. Halüsinasyonlar ve yanlış yanıtlar, yorumcuların beğenmediklerini söyledikleri her şeyin %14'ünü oluşturdu. Yani herkesin yalnızca maliyeti tartışmak istediği bir yılda doğruluk, maliyetin önüne geçti.
Bu yorumcuların kim olduğunu bilmekte fayda var, çünkü rakamın anlamını değiştiriyor. Çoğu, herkesin tarayıcı sekmesinde açık tuttuğu genel amaçlı asistanlardan bahsediyor. Bunlar canlı ortamdaki bir destek ajanını anlatan CX ekipleri değil. Bir modele soru soran, kendinden emin bir yanıt alan ve ardından bu yanıtın doğru olup olmadığını kendi başına çözmek zorunda kalan kişiler.
Ardından G2, aynı modeller üzerine canlı ortam sistemleri geliştiren 4 sağlayıcıya başvurdu ve hata oranlarının gerçekte ne olduğunu sordu. Yanıt: %1'e kadar düşük.
Yani aslında karşılaştırılan şey bir model ile başka bir model değil. Kendi prompt'larınızla kullandığınız bir model ile birinin bir modelin etrafına inşa ettiği bir sistem karşılaştırılıyor: Altta aynı teknoloji, sonuçlar ise birbirinden çok farklı. Maven, G2'nin görüştüğü 4 sağlayıcıdan biriydi.
Farkın ardında ne var
Bu 4 sağlayıcının anlattıklarının hiçbiri hangi modeli seçtikleriyle ilgili değildi. Hepsi aşağı yukarı aynı şeyi söyledi. Sistemleri tek seferde değil, adım adım çalışıyor. Yanıtlar, modelin eğitimden aklında kalanlardan değil, canlı verilerden çekiliyor. Bir görevin gerçekten ne sıklıkla tamamlandığını ölçüyorlar ve prompt'ları ve mantığı en az haftalık olarak yeniden yazıyorlar. İçlerinden biri bunu her gün yapıyor. Bunların tamamı modelin kendisine değil, etrafına yapılan çalışmalar.
Üzerinde uzlaştıkları daha faydalı nokta ise emeğin nereye harcandığı. Hepsi zor olanın gündelik sorular değil, uç durumlar ve çok adımlı görevler olduğunu söyledi. Bu yüzden tahmin yürütmek yerine yetkinliğinin dışına çıktığını fark edip konuşmayı bir insana devreden sistemler kuruyorlar. Maven'ın ankette dile getirdiği görüş şuydu: “Güvenilir bir devretme mantığı olmayan otonomi bir özellik değil, bir risktir.”
Farkın büyük kısmı tam olarak burada. Bir modeli kendiniz prompt'ladığınızda, onun işini kontrol eden sizsiniz. Canlı ortamdaki bir sistem ise bu işin hiçbir zaman müşteriye kalmayacağı şekilde kurulur. G2 bunu açıkça ifade etti: Bu sağlayıcılar daha az hatayla karşılaşmıyor; hataları kimse fark etmeden yakalıyorlar.
Ajan mı, chatbot mu tartışması çoğunlukla kelimelerden ibaret
G2, 4 sağlayıcıya yapay zekâ ajanlarının, kategorinin hâlâ chatbot dediği çözümlerden daha güvenilir olup olmadığını doğrudan sordu. Hepsi kabaca aynı yanıtı verdi ve bu, bu kelime üzerinden satış yapan kimse için iyi bir haber değil. Canlı ortamda ikisi arasındaki fark, pazarlamanın gösterdiği kadar büyük değil ve bir etiketi diğeriyle değiştirmek tek başına hiçbir şeyi çözmüyor.
Bu durum sağlayıcılardan çok alıcılar için önemli. “Ajan” kelimesinin peşindeyseniz, bir yetkinlik değil bir etiket satın alıyorsunuz. Bir sağlayıcının ürününe ajan, diğerinin başka bir ad vermesi; ikisinden herhangi birinin güncel bilgi tabanınıza başvurup başvurmadığı, emin olmadığında bunu fark edip etmediği ya da lansmandan sonra gerçek konuşmalarla test edilip edilmediği hakkında size hiçbir şey söylemez. Bunlar müşteri hizmetlerinde agentic AI'ın özellikleridir ve hiçbiri etiketle birlikte gelmez.
Size gerçekten bir şey söyleyen sorular, çözümün nasıl inşa edildiğiyle ilgilidir ve bu 5 sorunun tamamını ilk görüşmede sorabilirsiniz.
- Yanıtlar nereden geliyor? Canlı bilgi kaynaklarınıza mı başvuruyor, yoksa modelin eğitimde öğrendiklerine mi dayanıyor?
- Emin olmadığında ne oluyor? Konuşmayı devrediyor mu, yoksa haklı olduğunda kullandığı aynı kendinden emin tonla tahmin mi yürütüyor?
- Yanıtları gerçek konuşmalarla ne sıklıkla biri kontrol ediyor ve neyi ölçüyorlar?
- Ekibiniz ajanın davranışını değiştirebiliyor mu, yoksa her küçük ayar sağlayıcıya mı geri gidiyor?
- Sistemlerinizde gerçekten bir işlem yapabiliyor mu, yoksa yalnızca müşteriye ne yapması gerektiğini mi söyleyebiliyor?
Bir sağlayıcı 5 sorunun hepsine yanıt verebiliyorsa, birisi gerçekten emek vermiş demektir. İlk soruyu kusursuz yanıtlayıp sonrasında belirsizleşiyorsa, bir model satın alıp etrafına bir widget sarmışlardır. Bu listenin daha kapsamlı bir versiyonunu kurumsal müşteri hizmetleri için yapay zekâ ajanlarını değerlendirme rehberimizde bulabilirsiniz.
Alıcıların atladığı kısımlar
Bu 4 sağlayıcının anlattığı yapı, Maven'ın 5 katmanlı mimarisinin üzerine kurulduğu yapının ta kendisi. Model yalnızca bir katman. Onu güvenilir kılan her şey etrafında yer alıyor: Ajanın ne bildiği, ne yapmasına izin verildiği, canlıya geçtikten sonra işini nasıl kontrol ettiğiniz ve guardrail'lerin kimin elinde olduğu. Alıcılar genellikle modele odaklanır, çünkü ünlü isimlerin bulunduğu katman odur. Oysa G2 verilerinin işaret ettiği her şey diğer 4 katmanda ve otonom çözümün iyi bir yanıttan farklı bir şey olmasının nedeni de bu.
Kategori aksini varsaysa da hızlı devreye alma ile güvenilirliğin birbirinin zıttı olmamasının nedeni de budur. Bu katmanları inşa etmek gerçek bir mühendislik işidir; ancak her müşterinin altyapısında 6 aylık bir projeye dönüşmek yerine, platformun içinde tek seferde yapılır.
İş yapıldığında sonuç nasıl görünür
Mastermind 6 haftada %93 otonom çözüm oranına ulaştı. K1x ilk haftasında %80'e ulaştı. Rho, aylık temas hacmi %12 artarken hiç yeni işe alım yapmadan %95 CSAT'ı korudu. Quest, AskQ'yu Maven üzerinde geliştirdi, hiçbir veri taşıma yapmadan mevcut bilgi tabanına ve vaka sistemine bağladı ve başarısını deflection'a göre değil, müşteri memnuniyetine göre ölçüyor.
Maven'ın kendi yorumları da aynı yöne işaret ediyor. 20 doğrulanmış yorumda 5 üzerinden 4,8 puan; kullanıcıların gerçekte neleri öne çıkardığına bakmakta fayda var: Senkronize tutulması gereken ayrı botlar yerine chat, e-posta ve sesi tek bir motorun yönetmesi; ilk bulduğu makaleden yanıt vermek yerine güncelliğini yitirmiş, yinelenen ve çelişen makaleleri işaretleyen bilgi erişimi; Salesforce veya Zendesk üzerinde günlerle ölçülen kurulum. Bunların hepsi modelin etrafındaki unsurlar.
25 Ağustos'ta yayımlanan G2 2026 Sonbahar raporlarında Maven; Customer Service Automation kategorisinde Mid-Market Grid'e, AI Customer Support Agents kategorisinde Mid-Market Results Index'e ve yine AI Customer Support Agents kategorisinde Implementation Index'e girdi. Index raporları, bir şirketin büyüklüğüne veya bilinirliğine değil, müşterilerin elde ettikleri sonuçlar ve devreye alma süreci hakkında söylediklerine dayanır. Yani G2'nin daha geniş verilerinin başka her yerde ters gittiğini gösterdiği şeyi tam olarak ölçer.
Asıl hikâye bu fark
Dikkat edilmesi gereken rakam, %14 ile %1 arasındaki mesafe; çünkü ikisi de aynı birkaç modelin üzerinde çalışıyor. Teknolojideki hiçbir şey bu kadar büyük bir farkı açıklamıyor. Farkı açıklayan şey, birinin kötü bir yanıtı müşteri görmeden yakalayan parçaları inşa etmeye zahmet edip etmediği. Bir çözüm oranının ancak nasıl ölçüldüğünü bildiğinizde anlam ifade etmesinin nedeni de bu.
Çoğu alıcı hâlâ model adlarını karşılaştırıyor. G2'nin görüştüğü 4 sağlayıcı ise bunu bir süre önce bıraktı.
Katmanlar hakkında okumak yerine onları görmek isterseniz demo planlayın.
Kendi konuşmalarınız üzerinde görün.
Size özel ücretsiz demo talep edin.


