
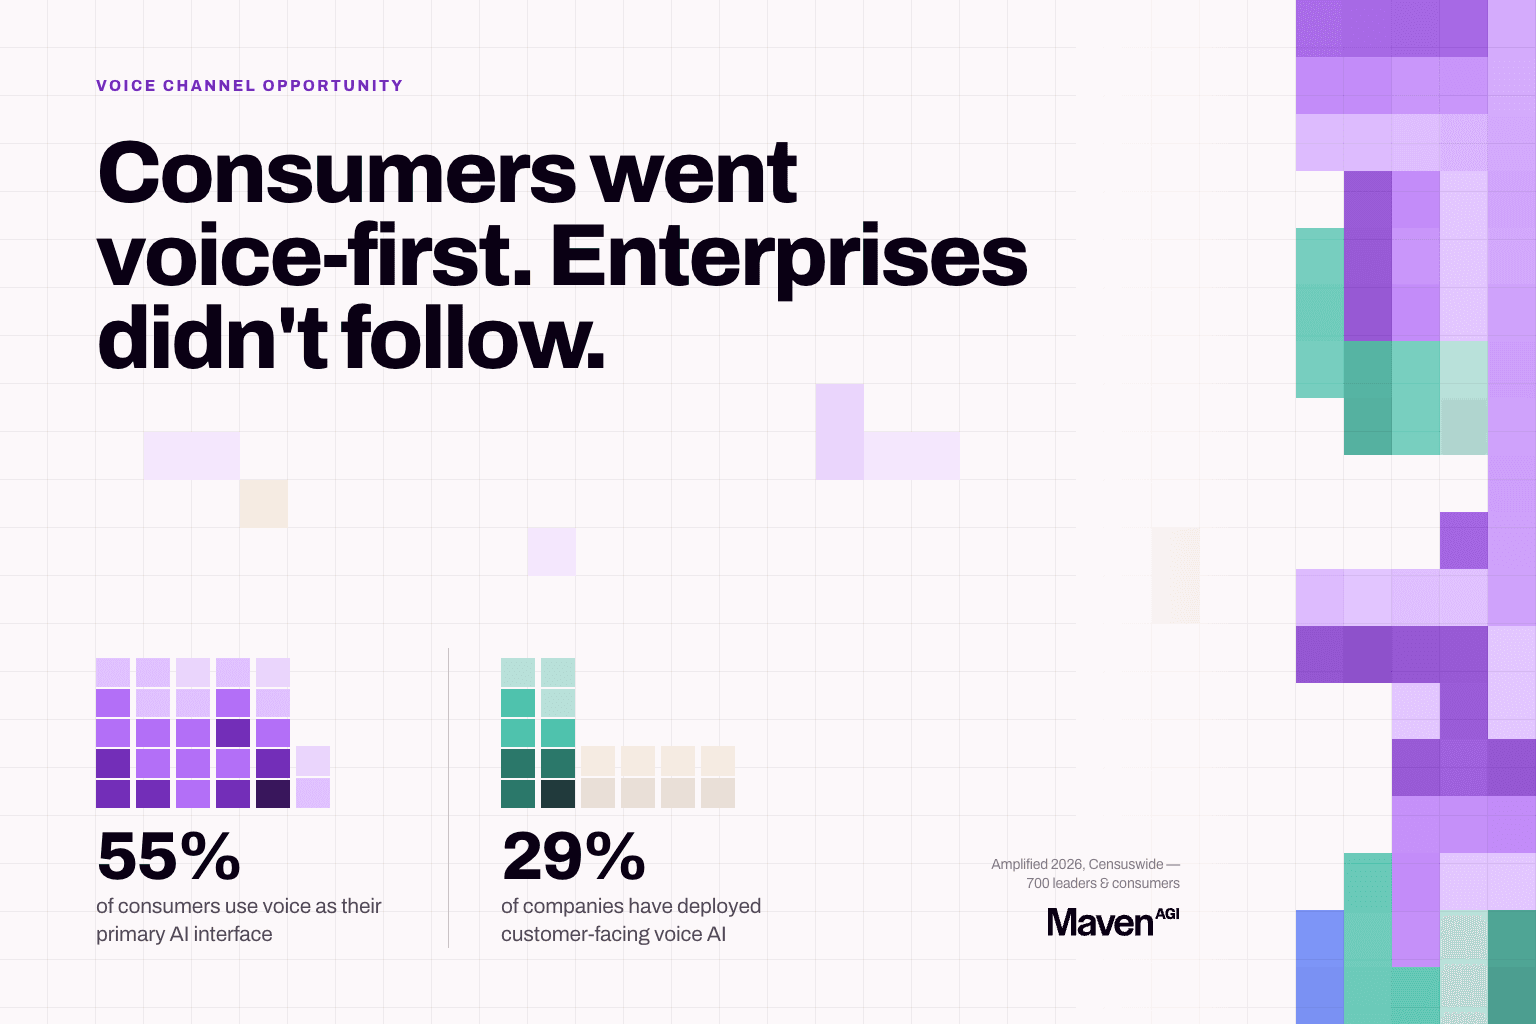
O comportamento do consumidor em relação à voz avançou mais rápido do que a preparação das empresas. O Amplified 2026, uma pesquisa da Censuswide com 700 líderes empresariais e consumidores, revelou que 55% dos consumidores já usam a voz como principal interface para interagir com IA, enquanto apenas 29% das empresas implantaram IA de voz voltada ao cliente.
A voz é, ao mesmo tempo, o canal de maior volume, maior custo e maior exigência técnica no atendimento ao cliente, e aquele em que a adoção de IA está mais atrasada. Essa combinação é incomum. O canal com mais custo a eliminar é o que tem menos concorrência pela vantagem.
Três barreiras tornavam a voz difícil, e todas eram reais: latência, precisão e compliance. O que mudou é que elas se tornaram problemas de engenharia com solução, e não mais questões de pesquisa em aberto.
Por que a latência era a mais difícil
O jeito tradicional de criar um agente de voz encadeia 3 sistemas. A fala é transcrita em texto, um modelo de linguagem lê o texto e escreve uma resposta, e um terceiro sistema a converte em fala. Cada etapa funciona bem isoladamente. O problema é o que se acumula entre elas.
Cada etapa adiciona atraso, e o que o cliente sente é o total. Respostas abaixo de 300 ms são, aproximadamente, o limite para uma chamada parecer uma conversa natural, e depois de cerca de 1 segundo de silêncio as pessoas começam a falar de novo. Um pipeline que ainda está processando a primeira fala passa então a ter 2 entradas sobrepostas e nenhuma forma limpa de conciliá-las.
A cadeia perde mais do que tempo. A transcrição gera texto, então tom, hesitação, volume e o som audível de alguém perdendo a paciência não sobrevivem à primeira etapa. O modelo lê uma frase neutra, sem nenhum sinal de que a pessoa que a disse está prestes a desligar. A recuperação também é frágil: quando um cliente interrompe ou 2 pessoas falam ao mesmo tempo, o pipeline precisa detectar o problema em uma etapa e repassar essa informação para trás, por etapas que nunca foram projetadas para recebê-la.
É por isso que tantas implantações de voz funcionam bem na demonstração e sofrem numa terça-feira à tarde. Demonstrações são silenciosas, roteirizadas e sem interrupções.
O que muda com o voice-to-voice de modelo único
Uma arquitetura diferente elimina essas etapas. Um único modelo recebe áudio e produz áudio, sem transcrever para texto e voltar no meio do caminho.
Como o modelo trabalha com som, e não com uma transcrição, aquilo que o pipeline descartava continua disponível. Interrupções chegam como interrupções. Falas sobrepostas, ruído de fundo e sotaques desconhecidos passam a ser condições que o modelo trata, e não falhas que quebram a passagem entre etapas. Sem etapas intermediárias, o tempo de resposta diminui o suficiente para que os clientes parem de falar por cima do sistema.
Esse é o mecanismo por trás da afirmação de que latência e precisão já estão resolvidas em produção. A Maven é a primeira plataforma de IA corporativa a colocar agentes voice-to-voice em produção plena, uma distinção validada pela Ibex, e opera 57 idiomas em voice-to-voice e 54 no chat. Nas implantações que a Maven mediu, agentes de voz bem construídos alcançam taxas de resolução na mesma faixa do chat para intenções comparáveis.
Para ser preciso sobre a stack: a voz em tempo real roda na OpenAI Realtime API com modelos de voz da Cartesia, e o agente de voz usa o mesmo mecanismo do chat e do e-mail, então um cliente que liga depois de enviar um e-mail não precisa começar do zero.
As 3 decisões que agora definem seu prazo
Com as barreiras técnicas superadas, a velocidade de implantação depende de um conjunto pequeno de escolhas, e em cada uma delas o caminho mais rápido tende a ser também o mais seguro.
- Telefonia. Integre com sua operadora e sua stack atuais em vez de migrar de operadora. Raramente vale a pena começar pela migração, e o voice-to-voice se conecta ao que você já usa, incluindo Twilio, Vonage, Cisco, Zendesk Talk e Genesys.
- URA. Sobreponha e amplie a URA existente em vez de substituí-la por completo. A substituição tem um teto mais alto, mas um caminho muito mais longo.
- Escalonamento. Use uma transferência assistida que leve todo o contexto ao atendente. Uma transferência sem contexto é pior do que não ter automação nenhuma, porque o cliente precisa explicar tudo duas vezes.
A questão de compliance que a voz levanta de imediato
Em uma ligação, os clientes dizem coisas que você não pode armazenar. Números de cartão, informações de saúde, credenciais de conta, tudo dito em voz alta enquanto pedem ajuda.
O compliance em voz é mais rigoroso do que em texto, e ele é resolvido quando a plataforma é construída para isso, e não adaptada depois. A questão decisiva é o momento. A anonimização de dados pessoais em tempo real durante a ligação e o pós-processamento depois dela criam janelas de exposição diferentes, e só a primeira mantém a informação sensível fora do pipeline. Pergunte qual das 2 você está contratando antes da revisão de segurança, e não durante.
Multilíngue fica mais difícil em voz
A tradução de texto está resolvida o bastante para que a maioria das empresas tenha deixado de se preocupar com ela. Voz é outra história. A língua falada traz variações de sotaque, expressões regionais, troca de idioma no meio da frase e diferenças de velocidade que uma transcrição apaga. Um pipeline encadeado agrava isso, porque a transcrição precisa adivinhar o idioma antes de o modelo ver qualquer coisa, e um palpite errado se propaga por todas as etapas seguintes.
Vale questionar os números de cobertura. A pergunta útil para qualquer fornecedor é se os idiomas listados foram testados em produção ou se apenas aparecem em um model card.
Comprovação em volume
Uma empresa de games da Fortune 500, que atua em um mercado regulado, opera com 80% de resolução em mais de 330.000 interações mensais, incluindo 13.000 interações resolvidas em um único dia de pico de evento.
Os dias de pico são o teste honesto. Picos de volume são quando as filas explodem, quando um sistema se sustenta ou se degrada de forma visível, e quando os clientes formam uma opinião duradoura sobre se vale a pena ligar para você.
Como avaliar voz sem cair na demonstração
Demonstrações gravadas não são evidência. Peça uma ligação ao vivo e, durante ela, aja como seus clientes agem.
- Interrompa no meio da frase e veja se o agente para ou continua falando
- Mude de ideia no meio de uma solicitação
- Introduza ruído de fundo
- Fale com um sotaque que o fornecedor não previu
- Peça para ele fazer algo, não apenas para dizer algo
O último item é o que mais pesa. Responder a uma pergunta e concluir uma transação são capacidades diferentes, e a resolução autônoma exige a segunda.
As 3 decisões estão resumidas na Árvore de Decisão de IA de Voz , que complementa o Escopo do Piloto de 90 Dias para equipes que consideram a voz como seu primeiro canal automatizado. Ambos se baseiam no capítulo Voice Channel Opportunity do relatório State of AI in CX 2026 .
Veja nas suas próprias conversas.
Solicite uma demonstração personalizada gratuita.


