
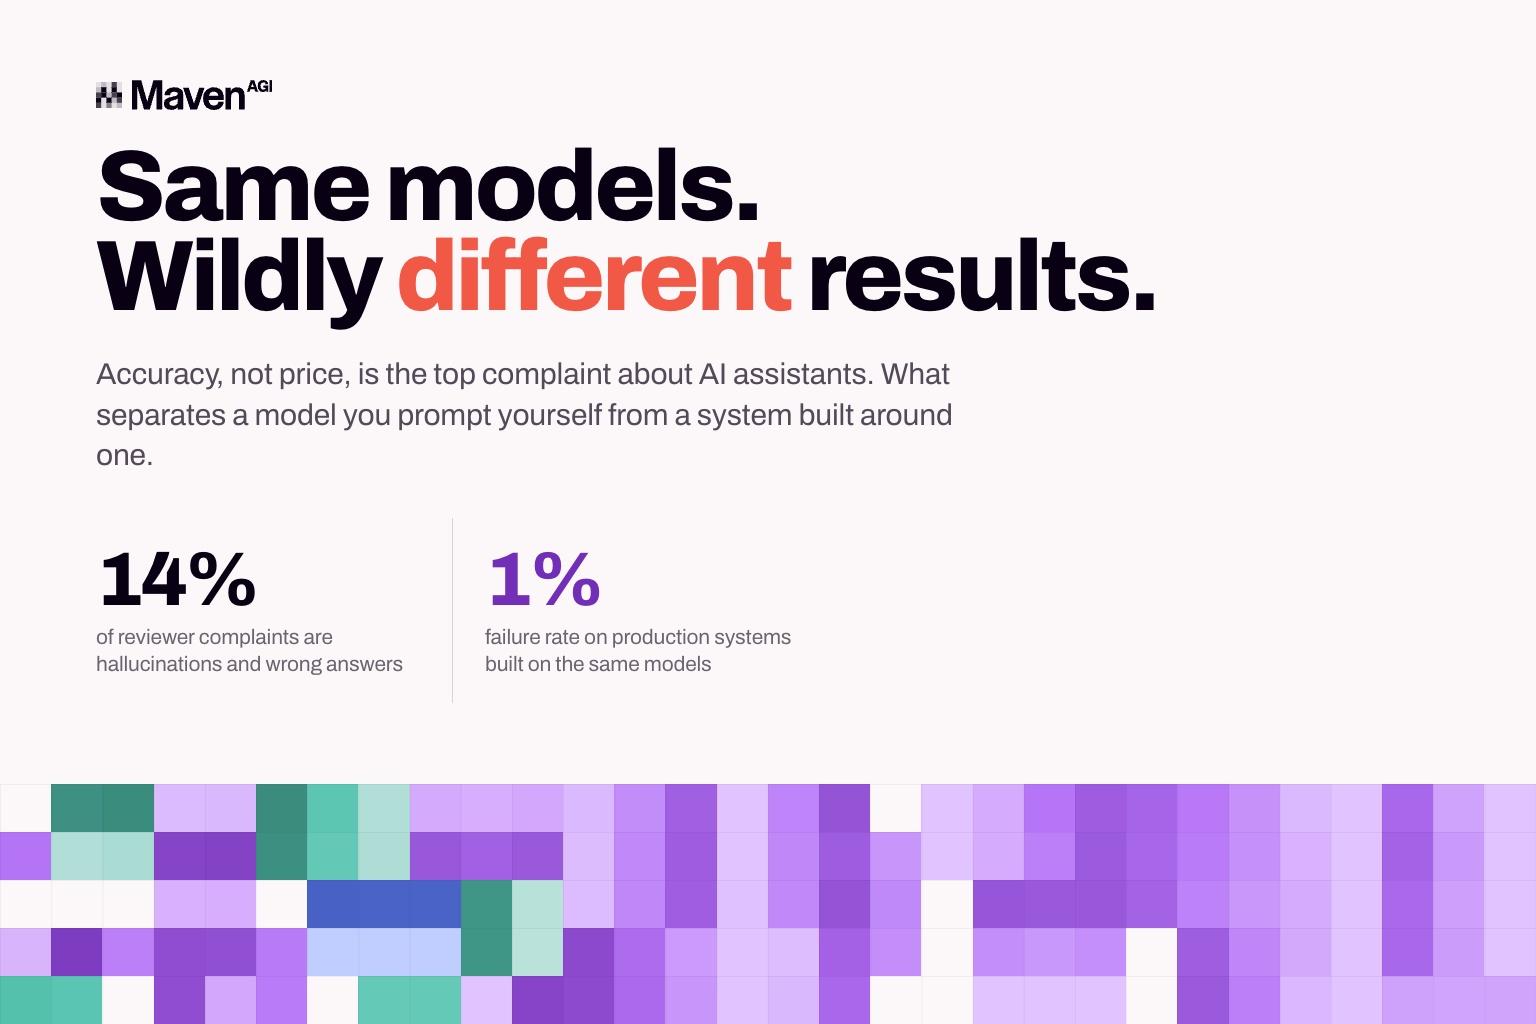
G2 עברה על יותר מ-2,950 ביקורות מאומתות מינואר ועד אמצע יולי ובדקה על מה אנשים מתלוננים הכי הרבה. התלונה המרכזית הייתה דיוק, לא מחיר. הזיות ותשובות שגויות היוו 14% מכל מה שהכותבים אמרו שלא אהבו. זה יותר מעלות, וזאת בשנה שבה כולם רוצים להתווכח רק על עלות.
כדאי לדעת מי הכותבים, כי זה משנה את משמעות המספר. רובם מדברים על העוזרים הכלליים שפתוחים אצל כולם בלשונית בדפדפן. הם לא צוותי CX שמתארים סוכן תמיכה בסביבת ייצור. אלה אנשים ששואלים מודל שאלה, מקבלים תשובה בטוחה בעצמה, ואז צריכים לברר בעצמם אם היא נכונה.
אחר כך G2 פנתה ל-4 ספקים שבונים מערכות ייצור על אותם מודלים בדיוק ושאלה איך נראים שיעורי הכשל שלהם בפועל. התשובה: נמוכים עד 1%.
כלומר, מה שבאמת מושווה כאן הוא לא מודל אחד מול אחר. זה מודל שאתם מנחים בעצמכם מול מערכת שמישהו בנה סביב מודל: אותה טכנולוגיה בבסיס, תוצאות שונות לגמרי. Maven הייתה אחד מ-4 הספקים ש-G2 פנתה אליהם.
מה עומד מאחורי הפער
שום דבר ממה ש-4 הספקים תיארו לא היה קשור לבחירת המודל. כולם אמרו פחות או יותר אותו דבר. המערכות שלהם עובדות בשלבים ולא בניסיון אחד. התשובות נשלפות מנתונים חיים, לא ממה שהמודל זוכר במקרה מהאימון. הם מודדים באיזו תדירות משימה באמת מושלמת, ומשכתבים פרומפטים ולוגיקה לפחות פעם בשבוע. אחד מהם עושה את זה מדי יום. כל זו עבודה שנעשית סביב המודל, לא עליו.
הנקודה החשובה יותר שהם הסכימו עליה היא לאן הולך המאמץ. כל ה-4 אמרו שהחלק הקשה הוא לא השאלה היומיומית, אלא מקרה הקצה והמשימה מרובת השלבים. לכן הם בונים מערכות שמזהות מתי הן מחוץ לתחום שלהן ומעבירות את השיחה לאדם במקום לנחש. המשפט של Maven בסקר היה: “אוטונומיה בלי לוגיקת גיבוי אמינה היא לא פיצ'ר; היא סיכון.”
זה רוב הפער. כשאתם מנחים מודל בעצמכם, אתם אלה שבודקים את העבודה שלו. מערכת ייצור בנויה כך שהמשימה הזו לעולם לא נופלת על הלקוח. G2 אמרה זאת במפורש: הספקים האלה לא רואים פחות כשלים, הם תופסים אותם לפני שמישהו שם לב.
הוויכוח סוכן מול צ'אטבוט הוא בעיקר על מילים
G2 שאלה את 4 הספקים ישירות אם סוכני AI אמינים יותר ממה שהקטגוריה עדיין מכנה צ'אטבוטים. כולם ענו בערך אותו דבר, וזו לא בשורה טובה למי שמוכר על בסיס המילה. בסביבת ייצור, ההבדל בין השניים קטן בהרבה ממה שהשיווק מרמז, והחלפת תווית אחת באחרת לא פותרת שום דבר בפני עצמה.
לזה יש משמעות גדולה יותר לקונים מאשר לספקים. אם אתם מחפשים את המילה “סוכן”, אתם קונים תווית ולא יכולת. העובדה שספק אחד קורא למוצר שלו סוכן ואחר קורא לו אחרת לא אומרת לכם דבר על כך אם מי מהם מחפש מידע בידע העדכני שלכם, מזהה מתי הוא לא בטוח, או נבדק מול שיחות אמיתיות אחרי ההשקה. אלה מאפיינים של AI אייג'נטי בשירות לקוחות, ואף אחד מהם לא מגיע עם התווית.
השאלות שכן אומרות משהו עוסקות באופן שבו המערכת בנויה, ואפשר לשאול את כל 5 השאלות כבר בשיחה הראשונה.
- מאיפה מגיעות התשובות? האם הוא מחפש בידע החי שלכם, או מסתמך על מה שהמודל ספג באימון?
- מה קורה כשהוא לא בטוח? האם הוא מעביר הלאה, או מנחש באותו טון בטוח שבו הוא משתמש כשהוא צודק?
- באיזו תדירות מישהו בודק את התשובות שלו מול שיחות אמיתיות, ומה בדיוק נמדד?
- האם הצוות שלכם יכול לשנות את התנהגות הסוכן, או שכל שינוי קטן עובר דרך הספק?
- האם הוא יכול באמת לבצע פעולות במערכות שלכם, או רק להגיד ללקוח מה לעשות?
אם ספק יכול לענות על כל 5, מישהו עשה את העבודה. אם הוא מדייק בראשונה ומתחיל לגמגם אחריה, הוא קנה מודל ועטף אותו בווידג'ט. גרסה מורחבת של הרשימה הזו נמצאת במדריך שלנו להערכת סוכני AI לשירות לקוחות בארגונים.
החלקים שקונים מדלגים עליהם
מה ש-4 הספקים תיארו הוא אותו מבנה שעליו בנויה ארכיטקטורת 5 השכבות של Maven. המודל הוא שכבה אחת. כל מה שהופך אותו לאמין נמצא סביבו: מה הסוכן יודע, מה מותר לו לעשות, איך בודקים את העבודה שלו אחרי שהוא עולה לאוויר, ומי מחזיק במנגנוני הבקרה. קונים בדרך כלל בוחרים לפי המודל, כי זו השכבה עם השמות המפורסמים. כל מה שהנתונים של G2 מצביעים עליו נמצא ב-4 השכבות האחרות, וזו הסיבה שפתרון אוטונומי הוא דבר שונה מתשובה טובה.
זו גם הסיבה שפריסה מהירה ואמינות אינן הפכים, למרות מה שהקטגוריה מניחה. בניית השכבות האלה היא הנדסה של ממש, אבל היא קורית פעם אחת, בתוך הפלטפורמה, במקום להפוך לפרויקט של 6 חודשים בסביבה של כל לקוח.
איך זה נראה כשהעבודה כבר נעשתה
Mastermind הגיעה ל-93% פתרון אוטונומי תוך 6 שבועות. K1x הגיעה ל-80% כבר בשבוע הראשון. Rho שמרה על CSAT של 95% תוך טיפול ב-12% יותר פניות בחודש, בלי לגייס אף אחד. Quest בנתה את AskQ על Maven, חיברה אותו לבסיס ידע ולמערכת ניהול תיקים שכבר היו קיימים, בלי הגירת נתונים, ומודדת אותו לפי שביעות רצון לקוחות ולא לפי הסטה.
גם הביקורות על Maven עצמה מצביעות לאותו כיוון. 4.8 מתוך 5 על בסיס 20 ביקורות מאומתות, וכדאי לקרוא מה אנשים באמת מעלים: מנוע אחד שמטפל בצ'אט, אימייל וקול במקום בוטים נפרדים שצריך לסנכרן; שליפת ידע שמסמנת מאמרים מיושנים, כפולים וסותרים במקום לענות מהמאמר הראשון שנמצא; הקמה שנמדדת בימים על גבי Salesforce או Zendesk. כל אלה הם הדברים שסביב המודל.
בדוחות Fall 2026 של G2, שפורסמו ב-25 באוגוסט, Maven נכללה ב-Mid-Market Grid for Customer Service Automation, ב-Mid-Market Results Index for AI Customer Support Agents וב-Implementation Index for AI Customer Support Agents. דוחות ה-Index מבוססים על מה שלקוחות אומרים על התוצאות שקיבלו ועל מהלך ההטמעה, לא על הגודל או המוכרות של החברה. הם מודדים בדיוק את מה שהנתונים הרחבים של G2 מראים שמשתבש בכל מקום אחר.
הפער הוא הסיפור
המספר שכדאי לשים לב אליו הוא המרחק בין 14% ל-1%, כי שניהם נשענים על אותה קבוצה קטנה של מודלים. שום דבר בטכנולוגיה לא מסביר פער כזה. מה שמסביר אותו הוא אם מישהו טרח לבנות את החלקים שתופסים תשובה שגויה לפני שלקוח רואה אותה. לכן שיעור פתרון אומר משהו רק כשיודעים איך הוא נמדד.
רוב הקונים עדיין משווים שמות של מודלים. 4 הספקים ש-G2 דיברה איתם ויתרו על זה מזמן.
אם אתם רוצים לראות את השכבות ולא רק לקרוא עליהן, קבעו הדגמה.
ראו את זה על השיחות שלכם.
בקשו הדגמה מותאמת אישית ללא עלות.


