
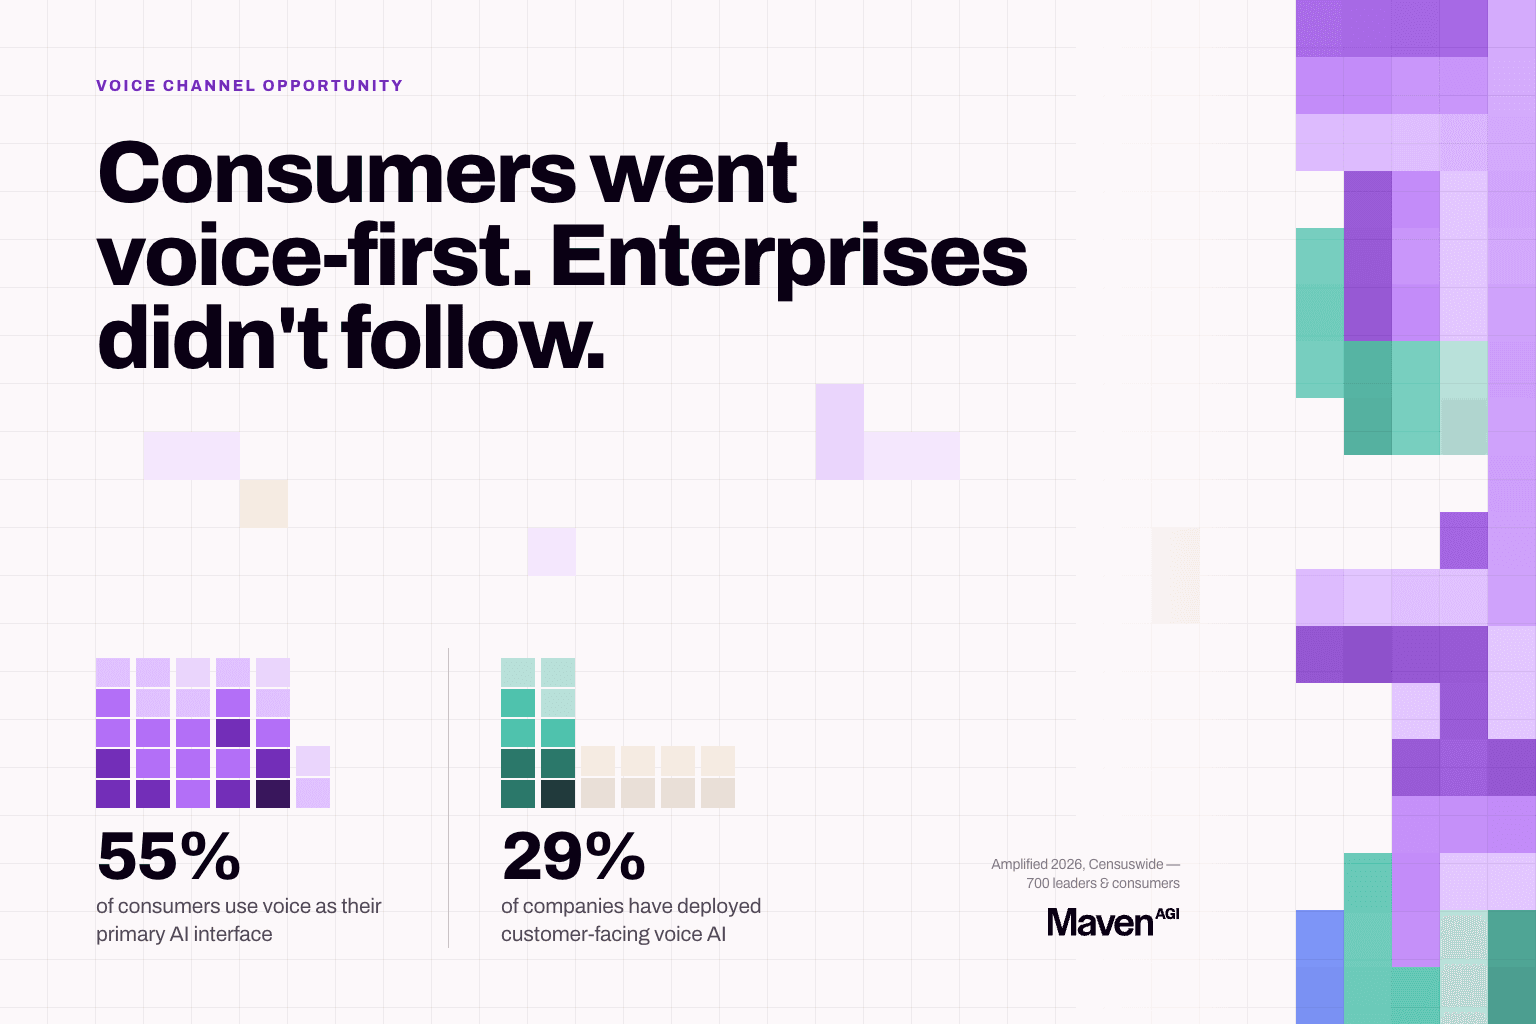
התנהגות הצרכנים סביב קול התקדמה מהר יותר ממוכנות הארגונים. Amplified 2026, סקר של Censuswide בקרב 700 מנהלים עסקיים וצרכנים, מצא ש-55% מהצרכנים משתמשים היום בקול כממשק העיקרי שלהם לאינטראקציות עם AI, בעוד שרק 29% מהחברות הטמיעו Voice AI מול לקוחות.
קול הוא בו-זמנית הערוץ עם הנפח הגבוה ביותר, העלות הגבוהה ביותר והדרישות הטכניות המורכבות ביותר בשירות הלקוחות, וגם הערוץ שבו אימוץ ה-AI מפגר הכי הרבה. זה שילוב חריג: בערוץ שבו יש הכי הרבה עלות לחסוך, יש הכי מעט תחרות על היתרון.
3 חסמים הפכו את הקול לקשה, וכל ה-3 היו אמיתיים: השהיה, דיוק ותאימות. מה שהשתנה הוא שהם הפכו לבעיות הנדסיות עם פתרונות, ולא לשאלות מחקר פתוחות.
למה ההשהיה הייתה הבעיה הקשה
הדרך המקובלת לבנות סוכן קולי משרשרת 3 מערכות. הדיבור מתומלל לטקסט, מודל שפה קורא את הטקסט וכותב תשובה, ומערכת שלישית מקריאה אותה בקול. כל שלב עובד היטב לבד. הבעיה היא מה שמצטבר ביניהם.
כל מעבר מוסיף עיכוב, והלקוח חווה את הסכום הכולל. זמן תגובה של פחות מ-300ms הוא בערך הסף לשיחה שמרגישה טבעית, ואחרי כשנייה של שקט אנשים מתחילים לדבר שוב. צינור עיבוד שעדיין מעבד את המשפט הראשון מקבל אז 2 קלטים חופפים, בלי דרך נקייה ליישב ביניהם.
השרשרת מאבדת יותר מזמן. התמלול מפיק טקסט, כך שטון, היסוס, עוצמת קול והצליל המוכר של מישהו שמאבד סבלנות לא שורדים את המעבר הראשון. המודל קורא משפט שטוח, בלי שום סימן שמי שאמר אותו עומד לנתק. גם ההתאוששות שבירה: כשלקוח קוטע או כש-2 אנשים מדברים בבת אחת, הצינור צריך לזהות את הבעיה בשלב אחד ולהעביר את המידע אחורה דרך שלבים שמעולם לא תוכננו לקבל אותו.
זו הסיבה שכל כך הרבה הטמעות קוליות עובדות מצוין בהדגמה ומתקשות ביום שלישי אחר הצהריים. הדגמות הן שקטות, מתוסרטות ונטולות קטיעות.
מה משנה voice-to-voice מבוסס מודל יחיד
ארכיטקטורה אחרת מבטלת את המעברים. מודל יחיד מקבל אודיו ומפיק אודיו, בלי תמלול לטקסט וחזרה באמצע.
מכיוון שהמודל עובד עם צליל ולא עם תמליל, מה שהצינור השליך נשאר זמין. קטיעות מגיעות כקטיעות. דיבור חופף, רעשי רקע ומבטאים לא מוכרים הופכים לתנאים שהמודל מתמודד איתם, ולא למצבי כשל ששוברים את ההעברה בין שלבים. בלי שלבי ביניים, פער התגובה מצטמצם מספיק כדי שלקוחות יפסיקו לדבר מעל המערכת.
זה המנגנון שעומד מאחורי הטענה שבעיות ההשהיה והדיוק נפתרו היום בייצור. Maven היא פלטפורמת ה-AI הארגונית הראשונה שהביאה סוכני voice-to-voice לייצור מלא, הישג ש-Ibex אימתה, והיא תומכת ב-57 שפות ב-voice-to-voice וב-54 שפות בצ'אט. בהטמעות ש-Maven מדדה, סוכנים קוליים בנויים היטב מגיעים לשיעורי פתרון בטווח דומה לצ'אט בכוונות דומות.
ולדיוק לגבי הסטאק: קול בזמן אמת פועל על OpenAI Realtime API יחד עם מודלי הקול של Cartesia, והסוכן הקולי משתמש באותו מנוע כמו הצ'אט והאימייל, כך שלקוח שמתקשר אחרי ששלח אימייל לא מתחיל מההתחלה.
3 ההחלטות שקובעות היום את לוח הזמנים
אחרי שהחסמים הטכניים טופלו, מהירות ההטמעה תלויה בכמה בחירות בודדות, ובכל אחת מהן ברירת המחדל המהירה יותר היא בדרך כלל גם הבטוחה יותר.
- טלפוניה. השתלבו עם הספק והסטאק הקיימים במקום לעבור ספק. מיגרציה כשלב ראשון כמעט אף פעם לא משתלמת, ו-voice-to-voice מתחבר למה שכבר פועל אצלכם, כולל Twilio, Vonage, Cisco, Zendesk Talk ו-Genesys.
- IVR. הוסיפו שכבה מעל ה-IVR הקיים והרחיבו אותו במקום לעקור ולהחליף. החלפה מציעה תקרה גבוהה יותר, אבל דרך ארוכה בהרבה.
- הסלמה. השתמשו בהעברה חמה שמעבירה לנציג את ההקשר המלא. העברה קרה בלי הקשר גרועה יותר מהיעדר אוטומציה בכלל, כי הלקוח נאלץ להסביר הכול פעמיים.
שאלת התאימות שקול מעלה מיד
בשיחה, לקוחות אומרים דברים שאסור לכם לשמור. מספרי כרטיסים, פרטים רפואיים, פרטי גישה לחשבון, הכול נאמר בקול בזמן שהם מבקשים עזרה.
התאימות בקול מחמירה יותר מאשר בטקסט, והיא נפתרת כשהפלטפורמה בנויה לכך מלכתחילה ולא מותאמת לכך בדיעבד. השאלה החשובה היא תזמון. השחרת PII בזמן אמת במהלך השיחה ועיבוד לאחר השיחה יוצרים חלונות חשיפה שונים, ורק הראשון מונע מהמחרוזת הרגישה להיכנס לצינור העיבוד. בררו מה אתם קונים לפני סקירת האבטחה, לא במהלכה.
ריבוי שפות מסתבך בקול
תרגום טקסט נפתר מספיק כדי שרוב הארגונים הפסיקו לדאוג ממנו. בקול זה לא אותו דבר. שפה מדוברת כוללת מגוון מבטאים, ניסוחים אזוריים, מעבר בין שפות באמצע משפט והבדלי קצב שתמליל משטיח. צינור משורשר מחריף את הבעיה, כי התמלול צריך לנחש את השפה לפני שהמודל רואה משהו, וניחוש שגוי מתגלגל לכל שלב שאחריו.
כדאי להתעקש על נתוני הכיסוי. שאלת ההמשך המועילה לכל ספק היא אם השפות ברשימה נבדקו בייצור, או שהן פשוט מופיעות בכרטיס המודל.
הוכחה בהיקף
ארגון גיימינג מרשימת Fortune 500 שפועל בשוק מפוקח מגיע ל-80% פתרון ביותר מ-330,000 אינטראקציות בחודש, כולל 13,000 אינטראקציות שנפתרו ביום שיא אחד של אירוע.
ימי שיא הם המבחן האמיתי. קפיצות בנפח הן הרגע שבו התורים מתפוצצים, שבו מערכת מחזיקה מעמד או מתדרדרת באופן גלוי, ושבו לקוחות מגבשים דעה יציבה אם כדאי להתקשר אליכם.
איך להעריך קול בלי ליפול להדגמה
הדגמות מוקלטות אינן ראיה. בקשו שיחה חיה, ובמהלכה התנהגו כמו הלקוחות שלכם.
- קטעו באמצע משפט ובדקו אם הסוכן עוצר או ממשיך לדבר
- שנו את דעתכם באמצע בקשה
- הוסיפו רעשי רקע
- דברו במבטא שהספק לא התכונן אליו
- בקשו ממנו לעשות משהו, לא רק לספר לכם משהו
לאחרון יש המשקל הרב ביותר. מענה על שאלה והשלמת פעולה הן יכולות שונות, ופתרון אוטונומי דורש את השנייה.
3 ההחלטות בגרסה מתומצתת נמצאות ב- The Voice AI Decision Tree , שמשלים את The 90-Day Pilot Scope לצוותים ששוקלים את הקול כערוץ האוטומטי הראשון שלהם. שניהם מבוססים על פרק Voice Channel Opportunity של דוח State of AI in CX 2026 .
ראו את זה על השיחות שלכם.
בקשו הדגמה מותאמת אישית ללא עלות.


