
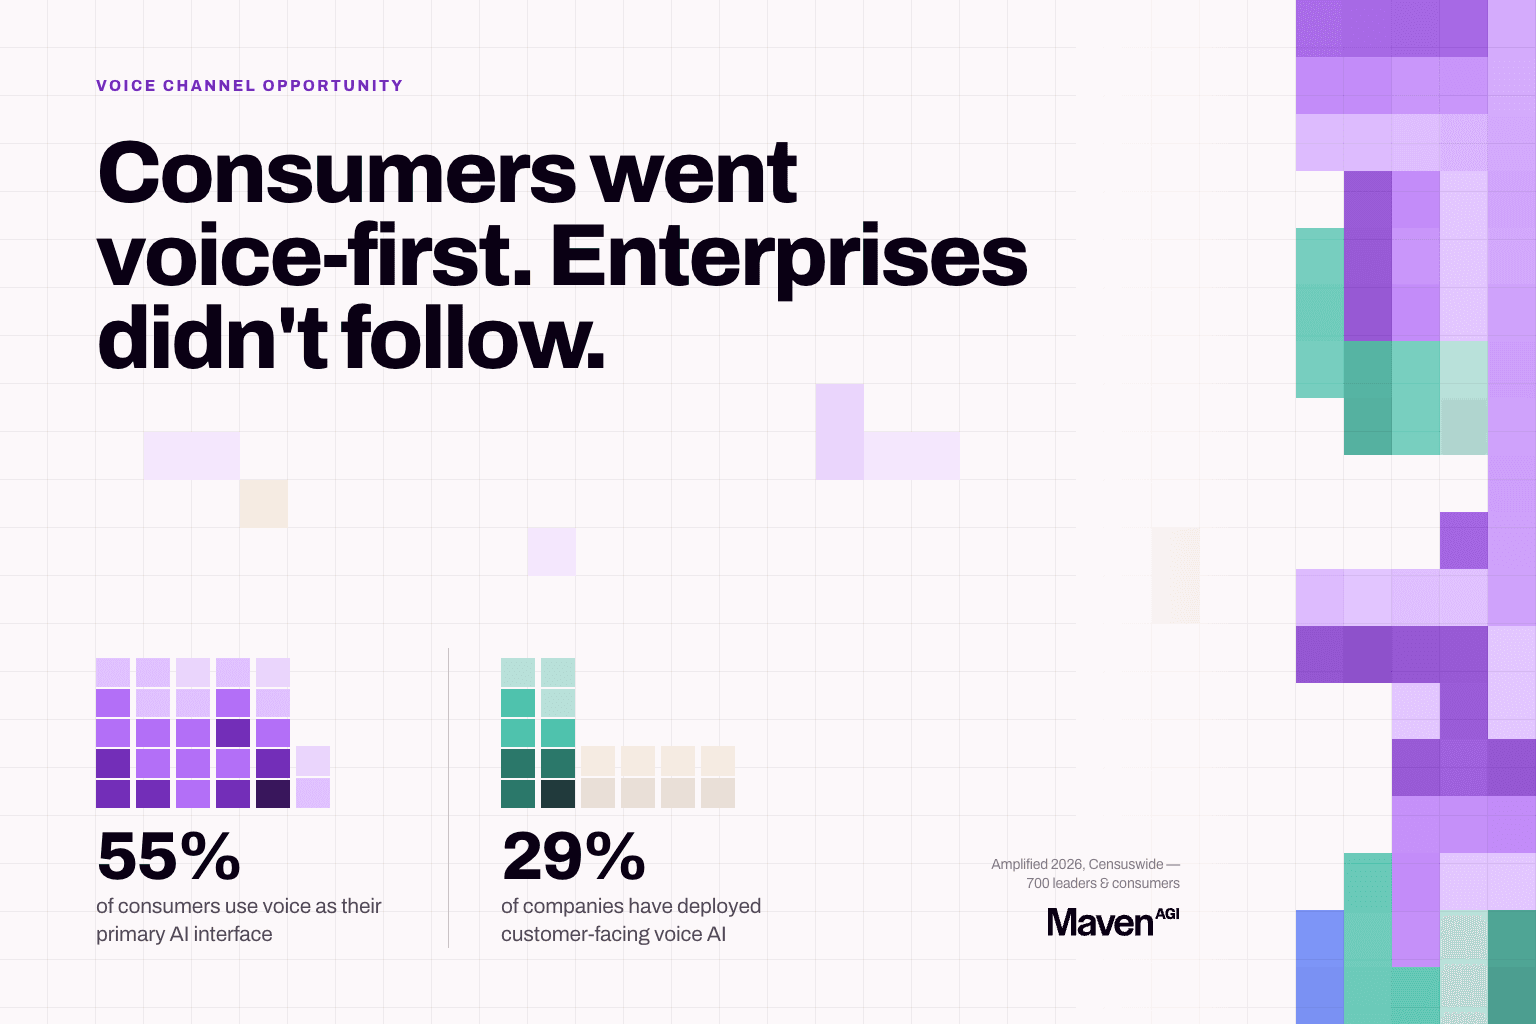
Das Nutzungsverhalten bei Voice hat sich schneller entwickelt als die Bereitschaft der Unternehmen. Amplified 2026, eine Censuswide-Umfrage unter 700 Führungskräften und Verbrauchern, ergab: 55 % der Verbraucher nutzen Sprache inzwischen als primäre Schnittstelle für KI-Interaktionen, aber nur 29 % der Unternehmen haben kundenorientierte Voice-KI im Einsatz.
Voice ist zugleich der Kanal mit dem höchsten Volumen, den höchsten Kosten und den größten technischen Anforderungen im Kundenservice – und der Kanal, in dem die KI-Einführung am weitesten zurückliegt. Diese Kombination ist ungewöhnlich. Wo sich die meisten Kosten einsparen lassen, ist der Wettbewerb um diesen Vorteil am geringsten.
3 Hürden machten Voice schwierig, und alle 3 waren real: Latenz, Genauigkeit und Compliance. Verändert hat sich, dass sie zu lösbaren Engineering-Problemen geworden sind statt offener Forschungsfragen.
Warum die Latenz die größte Hürde war
Der Standardansatz für einen Voice-Agenten verkettet 3 Systeme. Sprache wird in Text transkribiert, ein Sprachmodell liest den Text und formuliert eine Antwort, und ein drittes System spricht sie aus. Jede Stufe funktioniert für sich gut. Das Problem ist, was sich dazwischen summiert.
Jeder Zwischenschritt fügt Verzögerung hinzu, und der Kunde erlebt die Summe. Eine Antwortzeit unter 300 ms ist etwa die Schwelle, ab der sich ein Anruf wie ein Gespräch anfühlt; nach etwa 1 Sekunde Stille fangen Menschen wieder an zu sprechen. Eine Pipeline, die noch die erste Äußerung verarbeitet, hat dann 2 sich überlagernde Eingaben und keinen sauberen Weg, sie aufzulösen.
Die Kette verliert mehr als nur Zeit. Die Transkription erzeugt Text – Tonfall, Zögern, Lautstärke und die hörbare Ungeduld eines Anrufers überstehen den ersten Schritt nicht. Das Modell liest einen flachen Satz ohne jeden Hinweis darauf, dass die Person gleich auflegen wird. Auch die Fehlerbehandlung ist fragil: Wenn ein Kunde unterbricht oder 2 Personen gleichzeitig sprechen, muss die Pipeline das Problem in einer Stufe erkennen und diese Information rückwärts durch Stufen weitergeben, die nie dafür ausgelegt waren.
Deshalb überzeugen so viele Voice-Deployments in der Demo und haben an einem gewöhnlichen Dienstagnachmittag Probleme. Demos sind ruhig, geskriptet und frei von Unterbrechungen.
Was Single-Model-Voice-to-Voice verändert
Eine andere Architektur entfernt die Zwischenschritte. Ein einziges Modell empfängt Audio und erzeugt Audio – ohne Umweg über Text und zurück.
Da das Modell mit Klang statt mit einem Transkript arbeitet, bleibt verfügbar, was die Pipeline verworfen hat. Unterbrechungen kommen als Unterbrechungen an. Überlappende Sprache, Hintergrundgeräusche und ungewohnte Akzente werden zu Bedingungen, mit denen das Modell umgeht, statt zu Fehlerzuständen, die eine Übergabe abbrechen lassen. Ohne Zwischenstufen schrumpft die Antwortlücke so weit, dass Kunden dem System nicht mehr ins Wort fallen.
Das ist der Mechanismus hinter der Aussage, dass Latenz und Genauigkeit im Produktivbetrieb heute gelöst sind. Maven ist die erste Enterprise-KI-Plattform, die Voice-to-Voice-Agenten vollständig in den Produktivbetrieb gebracht hat – eine Auszeichnung, die Ibex bestätigt hat – und unterstützt 57 Sprachen in Voice-to-Voice sowie 54 im Chat. In den von Maven gemessenen Deployments erreichen gut gebaute Voice-Agenten bei vergleichbaren Anliegen ähnliche Lösungsquoten wie der Chat.
Zum Stack im Detail: Echtzeit-Voice läuft auf der OpenAI Realtime API zusammen mit Voice-Modellen von Cartesia. Der Voice-Agent nutzt dieselbe Engine wie Chat und E-Mail, sodass ein Kunde, der nach einer E-Mail anruft, nicht von vorn beginnen muss.
Die 3 Entscheidungen, die heute Ihren Zeitplan bestimmen
Sind die technischen Hürden genommen, hängt die Deployment-Geschwindigkeit von wenigen Entscheidungen ab – und in jedem Fall ist die schnellere Standardoption meist auch die sicherere.
- Telefonie. Integrieren Sie Ihren bestehenden Carrier und Stack, statt den Carrier zu wechseln. Eine Migration lohnt sich selten als erster Schritt, und Voice-to-Voice verbindet sich mit dem, was Sie bereits betreiben, darunter Twilio, Vonage, Cisco, Zendesk Talk und Genesys.
- IVR. Ergänzen und erweitern Sie das bestehende IVR, statt es komplett zu ersetzen. Ein Austausch bietet mehr Spielraum nach oben, aber einen deutlich längeren Weg.
- Eskalation. Setzen Sie auf eine Warm Handoff, die den vollständigen Kontext an den Mitarbeiter übergibt. Eine Cold Handoff ohne Kontext ist schlechter als gar keine Automatisierung, weil der Kunde alles zweimal erklären muss.
Die Compliance-Frage, die Voice sofort aufwirft
Am Telefon sagen Kunden Dinge, die Sie nicht speichern dürfen. Kartennummern, Gesundheitsdaten, Zugangsdaten – alles laut ausgesprochen, während sie um Hilfe bitten.
Compliance ist bei Voice strenger als bei Text, und sie wird dann gelöst, wenn die Plattform dafür gebaut ist, statt nachträglich angepasst zu werden. Entscheidend ist der Zeitpunkt. PII-Schwärzung in Echtzeit während des Anrufs und Nachbearbeitung im Anschluss schaffen unterschiedliche Risikofenster, und nur die erste hält die sensible Information aus der Pipeline heraus. Klären Sie, welche Variante Sie kaufen, vor dem Security Review – nicht währenddessen.
Mehrsprachigkeit wird bei Voice schwieriger
Textübersetzung ist so weit gelöst, dass sich die meisten Unternehmen darüber keine Gedanken mehr machen. Bei Voice ist das anders. Gesprochene Sprache bringt Akzentvarianten, regionale Ausdrucksweisen, Sprachwechsel mitten im Satz und unterschiedliche Sprechgeschwindigkeiten mit sich, die ein Transkript glättet. Eine verkettete Pipeline verschärft das, weil die Transkription die Sprache erraten muss, bevor das Modell etwas sieht – und ein Fehlgriff zieht sich durch jede nachfolgende Stufe.
Bei Angaben zur Sprachabdeckung lohnt es sich nachzuhaken. Die entscheidende Rückfrage an jeden Anbieter lautet, ob die aufgeführten Sprachen im Produktivbetrieb getestet wurden oder lediglich in einer Model Card stehen.
Nachweis bei hohem Volumen
Ein Fortune-500-Gaming-Unternehmen in einem regulierten Markt erreicht 80 % Lösungsquote bei mehr als 330.000 Interaktionen pro Monat, darunter 13.000 gelöste Interaktionen an einem einzigen Spitzentag.
Spitzentage sind der ehrliche Test. Bei Volumenspitzen laufen Warteschlangen über, ein System hält stand oder bricht sichtbar ein – und Kunden bilden sich eine dauerhafte Meinung darüber, ob es sich lohnt, bei Ihnen anzurufen.
Wie Sie Voice bewerten, ohne sich von Demos blenden zu lassen
Aufgezeichnete Demos sind kein Beleg. Bestehen Sie auf einem Live-Anruf und verhalten Sie sich dabei so, wie Ihre Kunden es tun.
- Unterbrechen Sie mitten im Satz und prüfen Sie, ob der Agent aufhört oder weiterspricht
- Ändern Sie Ihre Meinung mitten in einer Anfrage
- Sorgen Sie für Hintergrundgeräusche
- Sprechen Sie mit einem Akzent, auf den der Anbieter nicht vorbereitet ist
- Bitten Sie den Agenten, etwas zu erledigen, nicht nur, Ihnen etwas zu erklären
Der letzte Punkt wiegt am schwersten. Eine Frage zu beantworten und eine Transaktion abzuschließen sind unterschiedliche Fähigkeiten, und autonome Lösung erfordert die zweite.
Die 3 Entscheidungen in kompakter Form finden Sie im The Voice AI Decision Tree , der sich mit The 90-Day Pilot Scope ergänzt – für Teams, die Voice als ersten automatisierten Kanal in Betracht ziehen. Beide basieren auf dem Kapitel „Voice Channel Opportunity“ des State of AI in CX 2026 Report .
Testen Sie es mit Ihren eigenen Konversationen.
Fordern Sie eine kostenlose, individuelle Demo an.


