
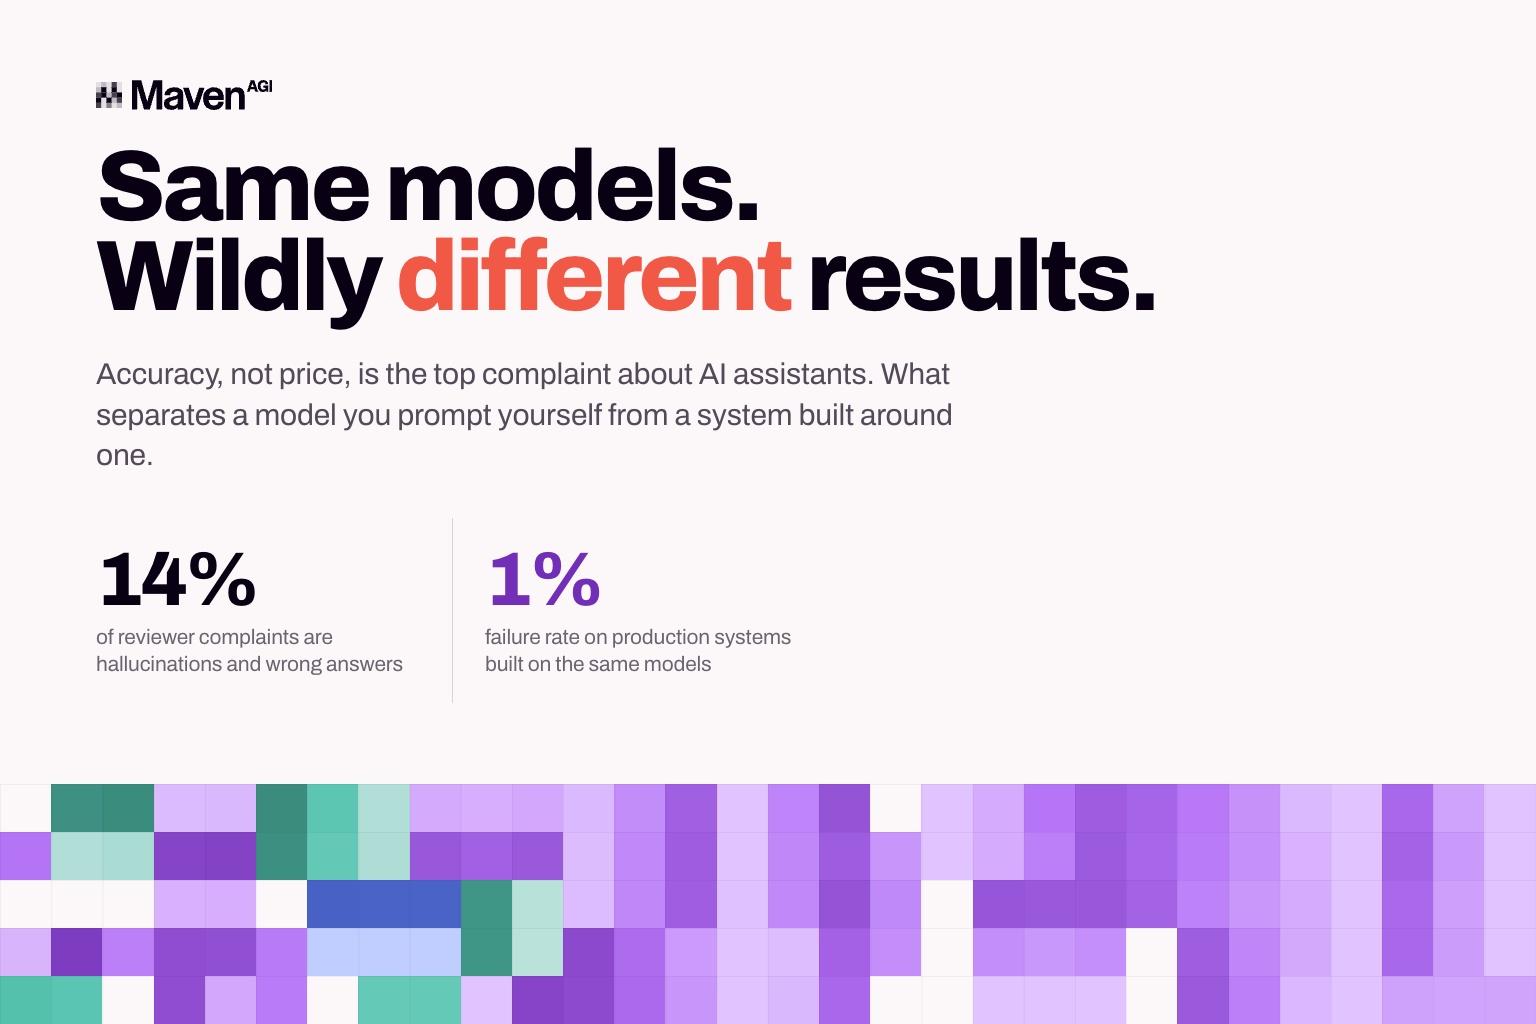
G2 menelaah lebih dari 2.950 ulasan terverifikasi sejak Januari hingga pertengahan Juli dan mencari tahu apa yang paling sering dikeluhkan pengguna. Keluhan terbesar ternyata akurasi, bukan harga. Halusinasi dan jawaban yang salah mencakup 14% dari semua hal yang tidak disukai pengulas. Angka ini mengungguli biaya, justru di tahun ketika semua orang sibuk memperdebatkan biaya.
Siapa para pengulas ini perlu diketahui, karena hal itu mengubah makna angkanya. Sebagian besar dari mereka membicarakan asisten serbaguna yang selalu terbuka di tab browser. Mereka bukan tim CX yang menilai agen dukungan di lingkungan produksi. Mereka adalah orang yang bertanya kepada model, mendapat jawaban yang terdengar meyakinkan, lalu harus memastikan sendiri apakah jawaban itu benar.
Kemudian G2 bertanya kepada 4 vendor yang membangun sistem produksi di atas model yang sama: seperti apa tingkat kegagalan mereka sebenarnya? Jawabannya: serendah 1%.
Jadi, yang sebenarnya dibandingkan bukanlah antarmodel. Yang dibandingkan adalah model yang Anda beri prompt sendiri dengan sistem yang sengaja dibangun di sekitar model. Teknologi dasarnya sama, hasilnya jauh berbeda. Maven adalah salah satu dari 4 vendor yang ditanyai G2.
Apa yang ada di balik kesenjangan ini
Tidak ada satu pun penjelasan dari keempat vendor tersebut yang berkaitan dengan pilihan model mereka. Semuanya mengatakan hal yang kurang lebih sama. Sistem mereka bekerja secara bertahap, bukan sekali jalan. Jawaban diambil dari data live, bukan dari apa pun yang kebetulan diingat model dari proses pelatihannya. Mereka mengukur seberapa sering sebuah tugas benar-benar tuntas, dan mereka merevisi prompt serta logika minimal seminggu sekali. Salah satunya bahkan melakukannya setiap hari. Semua itu adalah pekerjaan di sekitar model, bukan pada model itu sendiri.
Hal yang lebih berguna dari kesepakatan mereka adalah ke mana upaya itu dicurahkan. Keempatnya mengatakan bahwa bagian tersulit bukanlah pertanyaan sehari-hari, melainkan edge case dan tugas multi-langkah. Karena itu, mereka membangun sistem yang menyadari ketika sebuah persoalan di luar kemampuannya dan menyerahkan percakapan kepada manusia alih-alih menebak. Pernyataan Maven dalam survei tersebut: “otonomi tanpa logika fallback yang dapat dipercaya bukanlah fitur; itu adalah risiko.”
Di situlah sebagian besar kesenjangan itu berasal. Saat Anda memberi prompt sendiri kepada model, Andalah yang harus memeriksa hasilnya. Sistem produksi dibangun agar tugas itu tidak pernah jatuh ke tangan pelanggan. G2 menyatakannya dengan lugas: vendor-vendor ini bukan mengalami lebih sedikit kegagalan, melainkan menangkapnya sebelum ada yang menyadarinya.
Perdebatan agen versus chatbot sebagian besar hanya soal istilah
G2 bertanya langsung kepada keempat vendornya apakah agen AI lebih andal daripada apa yang masih disebut chatbot dalam kategori ini. Jawaban mereka kurang lebih sama, dan ini bukan kabar baik bagi siapa pun yang berjualan dengan mengandalkan istilah. Di lingkungan produksi, keduanya tidak seberbeda yang digambarkan materi pemasaran, dan mengganti label saja tidak memperbaiki apa pun.
Hal ini lebih penting bagi pembeli daripada bagi vendor. Jika Anda mencari produk berlabel “agen”, Anda membeli label, bukan kemampuan. Vendor yang menyebut produknya agen dan vendor lain yang menyebutnya dengan istilah berbeda tidak memberi tahu Anda apa pun tentang apakah produk tersebut mencari informasi dari pengetahuan terkini Anda, menyadari ketika ia tidak yakin, atau diuji terhadap percakapan nyata setelah diluncurkan. Semua itu adalah karakteristik agentic AI dalam layanan pelanggan, dan tidak ada satu pun yang otomatis datang bersama labelnya.
Pertanyaan yang benar-benar informatif adalah tentang cara sistem itu dibangun, dan Anda bisa mengajukan 5 pertanyaan berikut pada panggilan pertama.
- Dari mana jawabannya berasal? Apakah sistem mencari informasi dari pengetahuan live Anda, atau mengandalkan apa yang diserap model saat pelatihan?
- Apa yang terjadi ketika sistem tidak yakin? Apakah ia menyerahkan percakapan, atau menebak dengan nada yakin yang sama seperti saat jawabannya benar?
- Seberapa sering jawabannya diperiksa terhadap percakapan nyata, dan apa yang diukur?
- Apakah tim Anda dapat mengubah perilaku agen, atau setiap penyesuaian harus melalui vendor?
- Apakah sistem benar-benar bisa melakukan tindakan di sistem Anda, atau hanya bisa memberi tahu pelanggan apa yang harus dilakukan?
Jika vendor dapat menjawab kelima pertanyaan ini, berarti ada yang benar-benar mengerjakannya. Jika mereka mantap menjawab pertanyaan pertama tetapi mulai kabur setelahnya, mereka hanya membeli model dan membungkusnya dengan widget. Versi daftar yang lebih lengkap tersedia di panduan kami tentang mengevaluasi agen AI untuk layanan pelanggan enterprise.
Bagian yang sering dilewatkan pembeli
Apa yang dijelaskan keempat vendor tersebut adalah stack yang sama dengan fondasi arsitektur 5 lapis Maven. Model hanyalah 1 lapisan. Semua yang membuatnya andal berada di sekitarnya: apa yang diketahui agen, apa yang boleh dilakukannya, bagaimana Anda memeriksa kinerjanya setelah live, dan siapa yang memegang guardrail. Pembeli biasanya berfokus pada model, karena di lapisan itulah nama-nama terkenal berada. Padahal semua yang ditunjukkan data G2 ada di 4 lapisan lainnya, dan itulah sebabnya resolusi otonom berbeda dari sekadar jawaban yang bagus.
Itu juga sebabnya cepat diterapkan dan andal bukanlah dua hal yang bertentangan, apa pun anggapan umum di kategori ini. Membangun lapisan-lapisan tersebut memang pekerjaan engineering yang serius, tetapi cukup dilakukan sekali di dalam platform, bukan menjadi proyek 6 bulan di dalam stack setiap pelanggan.
Seperti apa hasilnya ketika pekerjaan itu sudah dilakukan
Mastermind mencapai resolusi otonom 93% dalam 6 minggu. K1x mencapai 80% di minggu pertamanya. Rho mempertahankan CSAT 95% sambil menangani 12% lebih banyak kontak per bulan tanpa menambah karyawan. Quest membangun AskQ di atas Maven, menghubungkannya ke knowledge base dan sistem kasus yang sudah ada tanpa migrasi data, dan menilainya berdasarkan kepuasan pelanggan, bukan deflection.
Ulasan Maven sendiri menunjukkan hal yang sama. 4,8 dari 5 dari 20 ulasan terverifikasi, dan yang menarik adalah apa yang sebenarnya disoroti pengguna: sebuah engine yang menangani chat, email, dan suara sekaligus, bukan bot terpisah yang harus terus disinkronkan; pengambilan pengetahuan yang menandai artikel usang, duplikat, dan saling bertentangan alih-alih menjawab dari artikel mana pun yang pertama ditemukan; serta penyiapan yang hanya memakan hitungan hari di atas Salesforce atau Zendesk. Semua itu adalah hal-hal di sekitar model.
Dalam laporan G2 Fall 2026 yang dirilis 25 Agustus, Maven masuk dalam Mid-Market Grid untuk Customer Service Automation, Mid-Market Results Index untuk AI Customer Support Agents, dan Implementation Index untuk AI Customer Support Agents. Laporan index disusun berdasarkan pendapat pelanggan tentang hasil yang mereka peroleh dan jalannya implementasi, bukan berdasarkan besar atau terkenalnya sebuah perusahaan. Laporan ini mengukur persis hal yang menurut data G2 yang lebih luas sedang bermasalah di tempat lain.
Kesenjangan inilah intinya
Angka yang perlu diperhatikan adalah jarak antara 14% dan 1%, karena keduanya berdiri di atas segelintir model yang sama. Tidak ada aspek teknologi yang bisa menjelaskan kesenjangan sebesar itu. Yang menjelaskannya adalah apakah ada yang mau repot membangun bagian-bagian yang menangkap jawaban buruk sebelum dilihat pelanggan. Itulah sebabnya tingkat resolusi baru bermakna setelah Anda tahu cara mengukurnya.
Sebagian besar pembeli masih membandingkan nama model. Keempat vendor yang diajak bicara G2 sudah lama meninggalkan cara itu.
Jika Anda ingin melihat lapisan-lapisan tersebut secara langsung, bukan sekadar membacanya, jadwalkan demo.
Lihat langsung pada percakapan Anda sendiri.
Minta demo personal gratis.


