

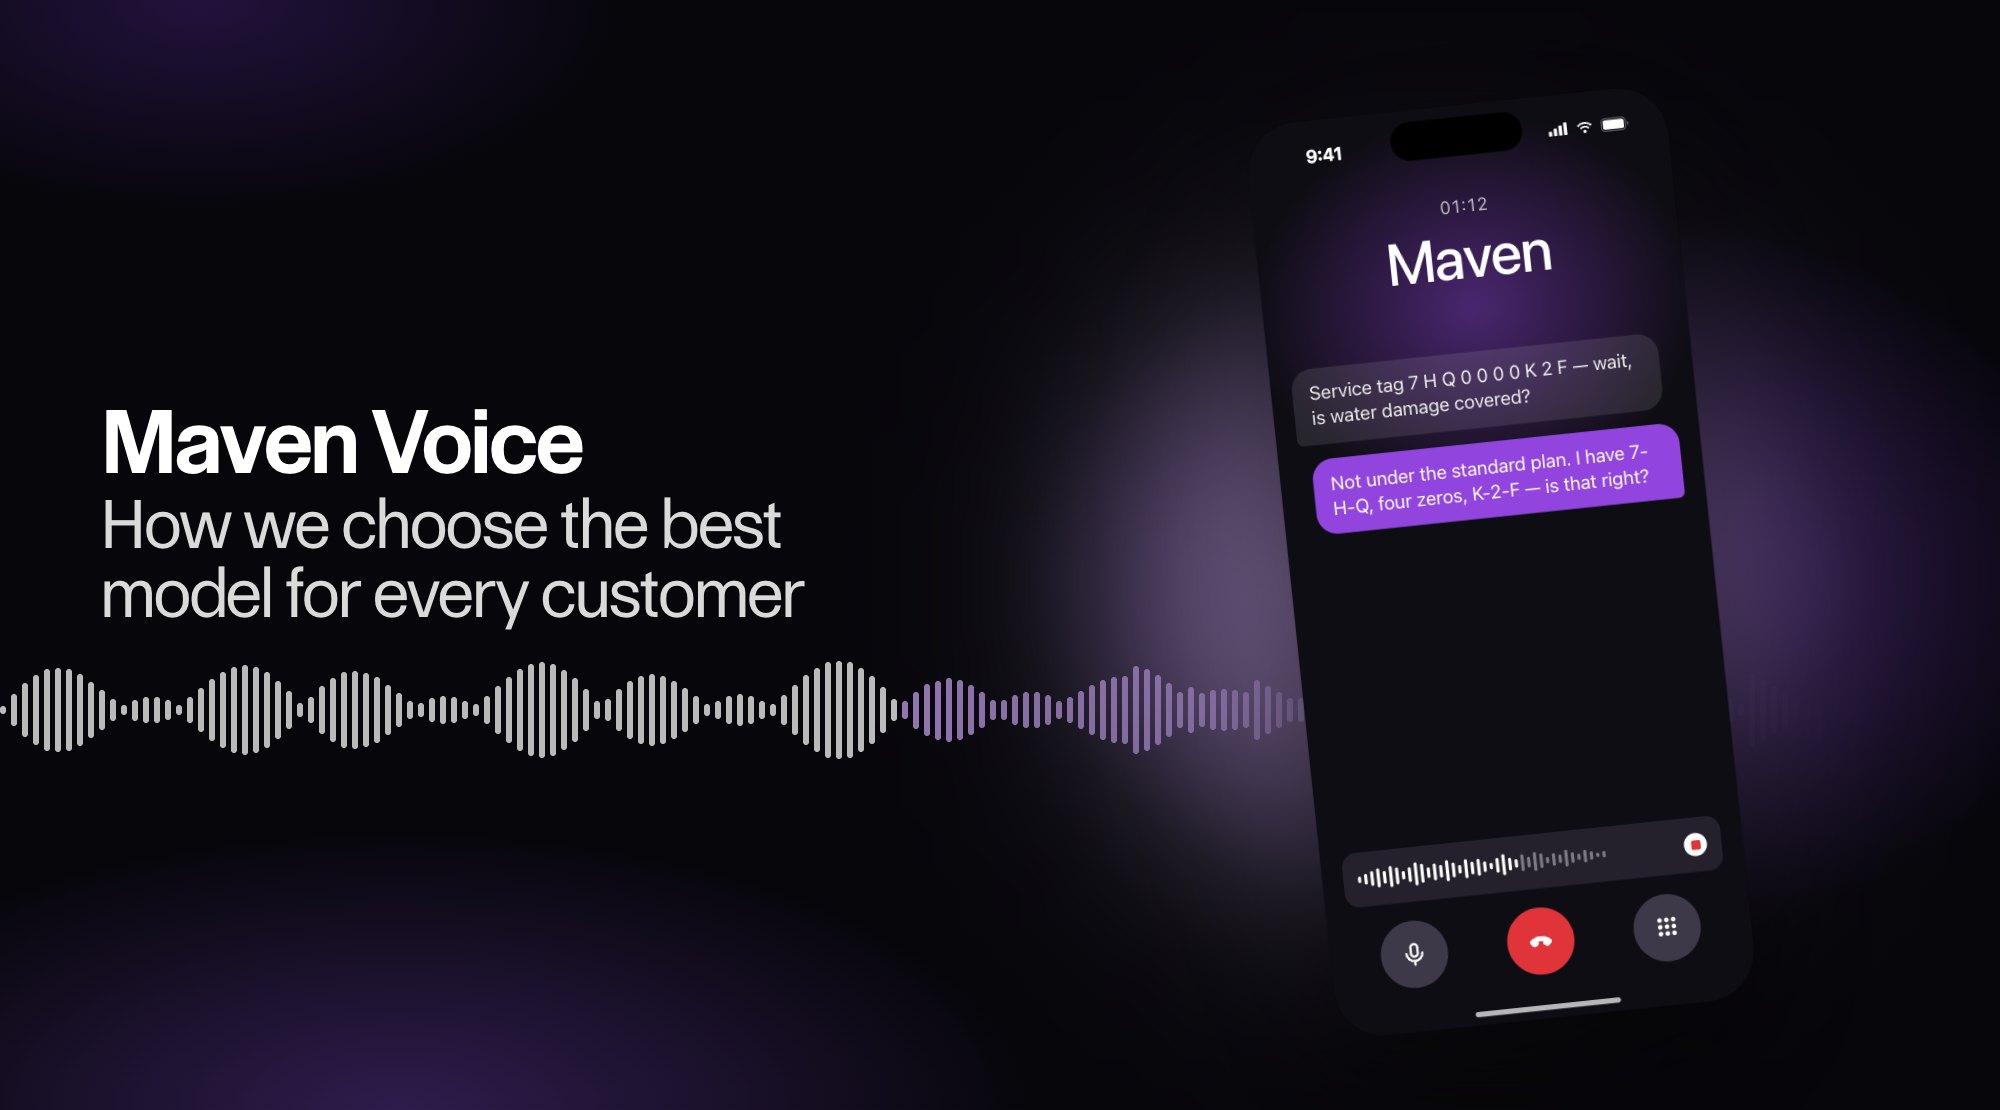
Pengalaman voice terbaik dibangun secara khusus
Setiap demo voice AI terdengar hebat lewat speaker laptop. Audio wideband, ruangan yang tenang, presenter yang tidak menyela. Lalu model yang sama masuk ke saluran telepon produksi: audio dipadatkan menjadi 8 kHz, jaringan menambah 100 hingga 200 milidetik lagi, dan penelepon sungguhan membacakan nomor seri 22 karakter dengan 4 angka nol berturut-turut, lalu menyela di tengah jawaban.
Kesenjangan itulah penyebab utama voice masih menjadi kanal yang belum diotomatisasi oleh sebagian besar perusahaan. Kesulitannya bukan membuat model voice terdengar bagus saat demo; melainkan membuatnya tetap berfungsi ketika penelepon menyela, membacakan identifier panjang, berganti bahasa, atau membutuhkan agen untuk mengambil tindakan di akun mereka. Karena itu kami berhenti memercayai benchmark yang dipublikasikan, termasuk yang diukur melalui aplikasi milik vendor sendiri, dan membangun cara untuk menguji model voice sebagaimana pelanggan mengalaminya: melalui panggilan telepon. Model terbaru yang menjalani pengujian ini adalah GPT-Live-1 dari OpenAI.
Cara Maven memilih model
Maven menggunakan sekumpulan model mutakhir untuk menjalankan pengalaman voice pelanggan. Setiap pelanggan memiliki kasus penggunaan yang unik: pencarian akun, identifier yang kompleks, diagnostik multi-langkah, interupsi, kebutuhan bahasa, spesifikasi penerapan, hingga permintaan yang memerlukan tindakan. Model yang bekerja sempurna untuk satu pelanggan bisa memberikan hasil pas-pasan untuk pelanggan lain. Karena itu, kami menguji model untuk menemukan yang terbaik bagi kasus penggunaan dan kriteria unik setiap pelanggan. Hasilnya kami gunakan untuk menentukan model mana yang menjalankan percakapan langsung, di mana model lain perlu membantu, dan safeguard apa yang dibutuhkan dalam pengalaman tersebut.
Pemilihan model hanyalah keputusan pertama. Kerangka evaluasi yang sama juga menunjukkan di mana perlu menambahkan konfirmasi untuk identifier yang kompleks, mencegah jeda hening dalam percakapan, atau mengarahkan tugas yang lebih sulit ke lapisan penalaran yang lebih kuat. Tujuannya bukan memilih satu model untuk semua kasus penggunaan, melainkan menghadirkan pengalaman terbaik bagi pelanggan dari pelanggan kami.
Mengevaluasi model terbaik di Arena
Voice Arena adalah kerangka evaluasi model Maven yang dapat diulang. Kerangka ini menguji model kandidat melalui panggilan keluar sungguhan di jaringan telepon publik, lalu menilai apa yang terjadi dari sudut pandang pelanggan. Kami mengadopsi disiplin evaluasi berpasangan secara blind dan menyesuaikannya untuk telepon.
Setiap evaluasi dimulai dengan scorecard yang sama:
- Kelancaran percakapan: seberapa alami dan jelas suara agen.
- Pemulihan interupsi: apakah agen berhenti, memahami permintaan baru, dan meresponsnya.
- Penangkapan identifier: apakah agen dapat mendengar dan mengonfirmasi rangkaian karakter yang benar-benar dibacakan penelepon.
- Waktu hingga jawaban yang berguna: lama waktu tunggu untuk respons yang substansial, bukan sekadar tanggapan awal.
- Keandalan panggilan: apakah agen menyelesaikan interaksi tanpa melewatkan permintaan atau melakukan handoff yang sebenarnya tidak perlu.
Kemudian kami menambahkan skenario yang penting bagi pengalaman voice pelanggan tersebut. Perusahaan yang saluran dukungannya menangani nomor seri produk yang kompleks membutuhkan stress test yang berbeda dari perusahaan yang menangani refund, janji temu, atau pertanyaan tagihan. Kerangkanya tetap konsisten, sementara scorecard-nya disesuaikan dengan penerapan masing-masing.
Keunggulan GPT-Live-1 dari OpenAI
GPT-Live-1 sangat unggul dalam aspek yang paling pertama disadari kebanyakan orang: pergantian giliran bicara. Model ini mampu memproses ucapan secara kontinu, sehingga dapat merespons ketika penelepon berbicara di tengah ucapan agen, tanpa menunggu turn detector terpisah.
Kami menguji model voice terbaru OpenAI untuk salah satu pelanggan Fortune 50 kami yang menangani jutaan panggilan per tahun, pada kasus penggunaan dukungan dan penjualan mereka. Evaluasi mereka difokuskan pada kemampuan model menangani identifier produk yang kompleks dan diagnostik panjang, dan GPT-Live-1 memimpin di antara model yang kami uji pada beberapa ukuran utama:
- 90% pembacaan ulang yang tepat pada service tag mereka, tingkat tertinggi dalam pengujian.
- 100% pemulihan interupsi; model ini menjawab pertanyaan baru setelah setiap interupsi.
- Median respons 1.257 milidetik terhadap permintaan baru, tercepat di antara model yang diuji.
- Median waktu jawaban 1,7 detik, dengan 81% jawaban tiba dalam 2 detik.
Model ini tidak unggul di semua scorecard. Pembacaan ulang yang tepat pada nomor seri panjang hanya 60%, dengan angka nol berulang sebagai kelemahan utamanya. Selain itu, 38% jawaban membuat penelepon menunggu lebih dari 5 detik untuk mendapatkan sesuatu yang substansial setelah tanggapan awal "Baik". Ini bukan alasan untuk mengabaikan model tersebut. Justru inilah celah produksi yang memang dirancang untuk diungkap oleh Arena.
GPT-Live-1 lebih baik sebagai pemimpin percakapan daripada satu model untuk semua panggilan
Dalam kasus ini, GPT-Live-1 adalah pilihan yang meyakinkan untuk memimpin percakapan: cepat, responsif, dan sangat andal saat penelepon menyela. Untuk momen yang padat identifier atau membutuhkan penalaran intensif, sistem mungkin memerlukan lapisan tambahan. Itulah alasan mereka memilih Maven. Kami membangun pengalaman voice berdasarkan bukti, bukan meminta setiap pelanggan menanggung kompromi dari satu model saja.
Bantu kami meningkatkan standar voice
Pelanggan: bawakan kami panggilan yang akan menggagalkan sebuah demo: identifier yang kompleks, interupsi berulang, tugas multi-langkah, atau apa pun yang tidak boleh berakhir dengan deflection. Kami akan mengevaluasi setiap model berdasarkan kondisi yang benar-benar dihadapi penelepon Anda.
Penyedia model: jika Anda ingin melihat seberapa tangguh model Anda pada panggilan enterprise nyata, kami ingin mengujinya di Arena. Semakin baik kualitas para pesaing, semakin baik pula pengalaman voice bagi setiap pelanggan.
Lihat langsung pada percakapan Anda sendiri.
Minta demo personal gratis.


