
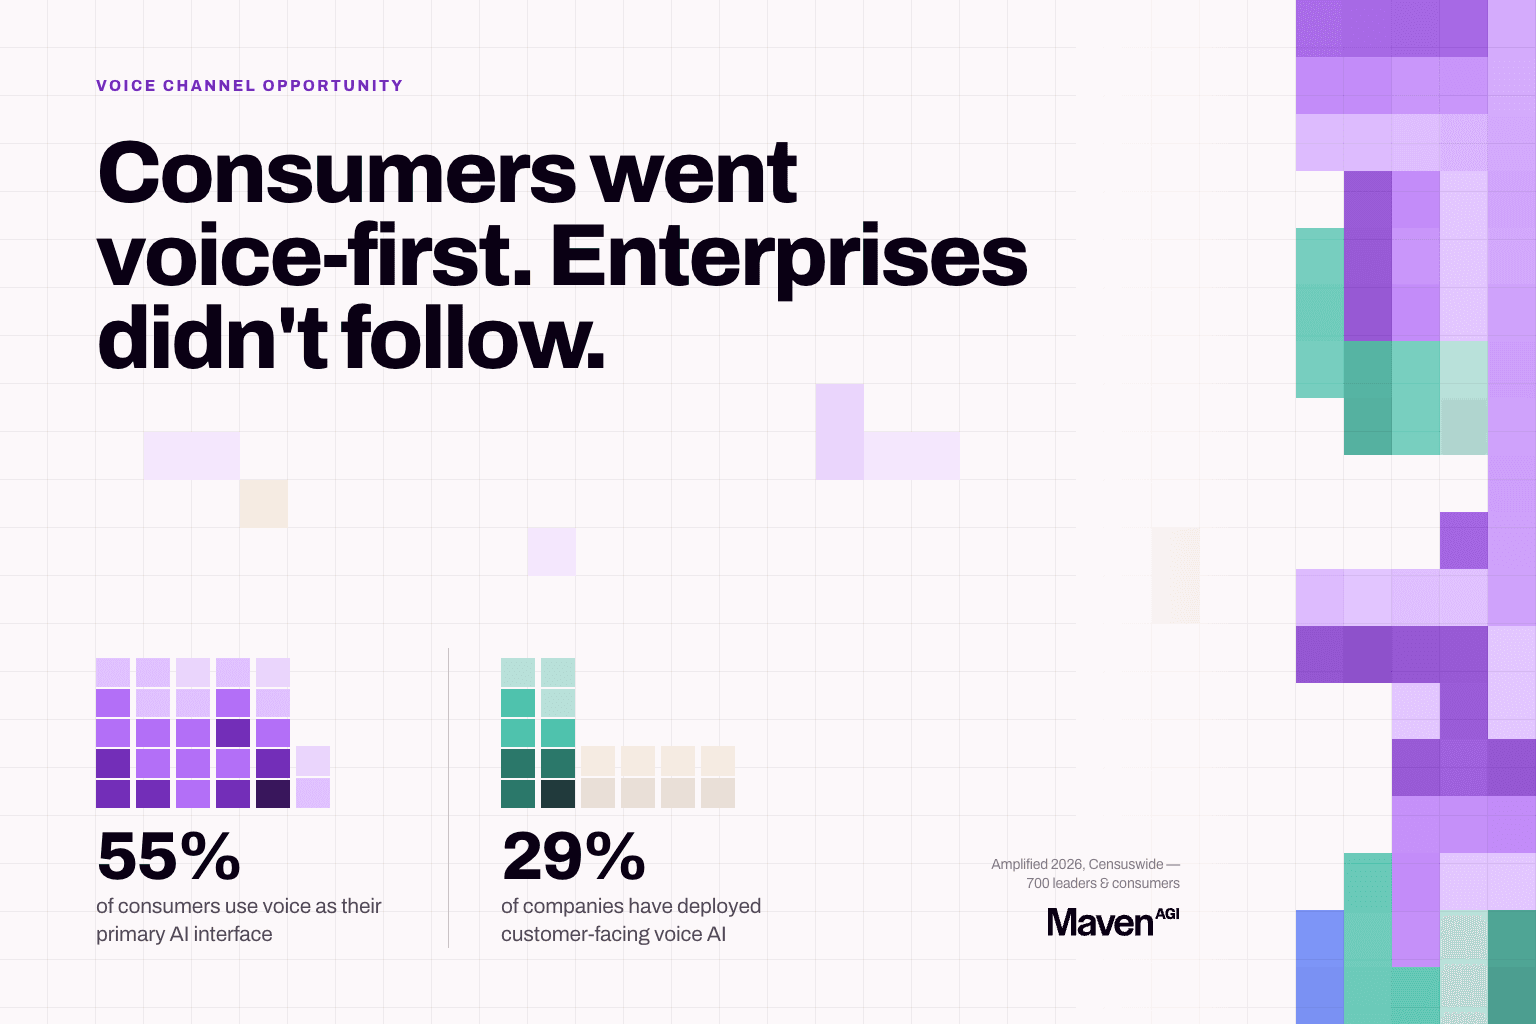
Perilaku konsumen terkait suara bergerak lebih cepat daripada kesiapan enterprise. Amplified 2026, survei Censuswide terhadap 700 pemimpin bisnis dan konsumen, menemukan bahwa 55% konsumen kini menggunakan suara sebagai antarmuka utama untuk berinteraksi dengan AI, sementara baru 29% perusahaan yang telah menerapkan voice AI untuk pelanggan.
Suara adalah kanal dengan volume tertinggi, biaya tertinggi, dan tuntutan teknis paling berat dalam layanan pelanggan, sekaligus kanal dengan adopsi AI yang paling tertinggal. Kombinasi ini tidak biasa. Kanal dengan potensi penghematan biaya terbesar justru memiliki persaingan paling sedikit untuk meraih keunggulan.
3 hambatan membuat kanal suara sulit, dan ketiganya nyata: latensi, akurasi, dan kepatuhan. Yang berubah adalah ketiganya kini menjadi masalah engineering yang sudah punya jawaban, bukan lagi pertanyaan riset yang terbuka.
Mengapa latensi adalah yang tersulit
Cara standar membangun agen suara adalah merangkai 3 sistem. Ucapan ditranskripsi menjadi teks, model bahasa membaca teks dan menulis balasan, lalu sistem ketiga mengucapkannya. Setiap tahap bekerja baik secara terpisah. Masalahnya ada pada apa yang menumpuk di antara tahap-tahap tersebut.
Setiap lompatan menambah jeda, dan yang dirasakan pelanggan adalah totalnya. Respons di bawah 300 ms kurang lebih merupakan ambang batas agar panggilan terasa seperti percakapan, dan setelah sekitar 1 detik hening, orang mulai berbicara lagi. Pipeline yang masih memproses ucapan pertama kemudian menghadapi 2 input yang tumpang tindih tanpa cara yang rapi untuk menyelaraskannya.
Rantai ini kehilangan lebih dari sekadar waktu. Transkripsi menghasilkan teks, sehingga nada, keraguan, volume, dan suara orang yang mulai kehilangan kesabaran tidak bertahan melewati lompatan pertama. Model membaca kalimat datar tanpa petunjuk bahwa orang yang mengucapkannya hampir menutup telepon. Pemulihannya juga rapuh, karena ketika pelanggan menyela atau 2 orang berbicara bersamaan, pipeline harus mendeteksi masalah di sebuah tahap lalu meneruskan informasi itu mundur melalui tahap-tahap yang tidak pernah dirancang untuk menerimanya.
Inilah alasan banyak deployment suara berkinerja baik saat demo tetapi kewalahan pada Selasa sore. Demo itu tenang, sesuai skrip, dan tanpa interupsi.
Apa yang diubah oleh voice-to-voice model tunggal
Arsitektur yang berbeda menghilangkan lompatan tersebut. Sebuah model tunggal menerima audio dan menghasilkan audio, tanpa transkripsi ke teks dan kembali lagi di antaranya.
Karena model bekerja dengan suara, bukan transkrip, informasi yang dibuang pipeline tetap tersedia. Interupsi diterima sebagai interupsi. Ucapan yang tumpang tindih, kebisingan latar, dan aksen yang tidak dikenal menjadi kondisi yang ditangani model, bukan keadaan gagal yang merusak serah terima. Tanpa tahap perantara, jeda respons menyempit cukup jauh sehingga pelanggan berhenti berbicara menimpa sistem.
Itulah mekanisme di balik klaim bahwa latensi dan akurasi kini sudah teratasi di produksi. Maven adalah platform AI enterprise pertama yang membawa agen voice-to-voice ke produksi penuh, sebuah pencapaian yang divalidasi oleh Ibex, dan mendukung 57 bahasa dalam voice-to-voice serta 54 bahasa dalam chat. Dalam deployment yang telah diukur Maven, agen suara yang dibangun dengan baik mencapai tingkat resolusi yang setara dengan chat untuk intent yang sebanding.
Secara spesifik soal stack-nya: suara real-time berjalan di OpenAI Realtime API bersama model suara Cartesia, dan agen suara menggunakan engine yang sama dengan chat dan email, sehingga pelanggan yang menelepon setelah mengirim email tidak perlu mengulang dari awal.
3 keputusan yang kini menentukan linimasa Anda
Setelah hambatan teknis teratasi, kecepatan deployment bergantung pada sejumlah kecil pilihan, dan dalam setiap kasus, opsi default yang lebih cepat cenderung juga lebih aman.
- Telefoni. Integrasikan dengan carrier dan stack yang sudah ada alih-alih berpindah carrier. Migrasi jarang layak dilakukan di awal, dan voice-to-voice terhubung ke sistem yang sudah Anda jalankan, termasuk Twilio, Vonage, Cisco, Zendesk Talk, dan Genesys.
- IVR. Tumpangkan dan perkuat IVR yang ada alih-alih membongkar dan menggantinya. Penggantian memiliki potensi lebih tinggi, tetapi jalannya jauh lebih panjang.
- Eskalasi. Gunakan warm handoff yang membawa konteks lengkap ke agen. Cold handoff tanpa konteks lebih buruk daripada tidak ada otomatisasi sama sekali, karena pelanggan harus menjelaskan semuanya 2 kali.
Pertanyaan kepatuhan yang langsung muncul di kanal suara
Dalam panggilan, pelanggan mengucapkan hal-hal yang tidak boleh Anda simpan. Nomor kartu, detail kesehatan, kredensial akun, semuanya diucapkan saat meminta bantuan.
Kepatuhan di kanal suara lebih ketat daripada di teks, dan dapat diatasi ketika platform memang dibangun untuk itu, bukan sekadar diadaptasi. Pertanyaan yang penting adalah soal waktu. Redaksi PII real-time selama panggilan dan pemrosesan setelah panggilan menciptakan jendela paparan yang berbeda, dan hanya yang pertama yang menjaga data sensitif tetap berada di luar pipeline. Tanyakan mana yang Anda beli sebelum tinjauan keamanan, bukan di tengah prosesnya.
Multibahasa lebih sulit di kanal suara
Terjemahan teks sudah cukup matang sehingga sebagian besar enterprise tidak lagi mengkhawatirkannya. Suara berbeda. Bahasa lisan membawa variasi aksen, ungkapan daerah, code-switching di tengah kalimat, dan perbedaan kecepatan bicara yang hilang dalam transkrip. Pipeline berantai memperparah hal ini, karena transkripsi harus menebak bahasanya sebelum model melihat apa pun, dan tebakan yang salah merambat ke setiap tahap sesudahnya.
Angka cakupan bahasa layak dipertanyakan. Pertanyaan lanjutan yang berguna untuk vendor mana pun adalah apakah bahasa yang tercantum sudah diuji di produksi atau hanya tercantum di model card.
Bukti dalam volume besar
Sebuah perusahaan gaming Fortune 500 yang beroperasi di pasar yang diregulasi mencapai 80% resolusi di lebih dari 330.000 interaksi per bulan, termasuk 13.000 interaksi yang terselesaikan dalam 1 hari puncak event.
Hari puncak adalah ujian yang sebenarnya. Lonjakan volume adalah saat antrean membludak, saat sistem bertahan atau jelas-jelas menurun kinerjanya, dan saat pelanggan membentuk opini yang bertahan lama tentang apakah menelepon Anda ada gunanya.
Cara mengevaluasi voice AI tanpa terkecoh demo
Demo rekaman bukanlah bukti. Mintalah panggilan langsung, dan selama panggilan, bersikaplah seperti pelanggan Anda.
- Sela di tengah kalimat dan lihat apakah agen berhenti atau terus berbicara
- Ubah keinginan Anda di tengah permintaan
- Tambahkan kebisingan latar
- Bicaralah dengan aksen yang tidak diantisipasi vendor
- Minta agen melakukan sesuatu, bukan sekadar memberi tahu sesuatu
Poin terakhir paling menentukan. Menjawab pertanyaan dan menyelesaikan transaksi adalah kapabilitas yang berbeda, dan resolusi otonom membutuhkan yang kedua.
Versi ringkas dari 3 keputusan tersebut tersedia dalam The Voice AI Decision Tree , yang melengkapi The 90-Day Pilot Scope bagi tim yang mempertimbangkan suara sebagai kanal otomatisasi pertama mereka. Keduanya bersumber dari bab Voice Channel Opportunity dalam laporan State of AI in CX 2026 .
Lihat langsung pada percakapan Anda sendiri.
Minta demo personal gratis.


