
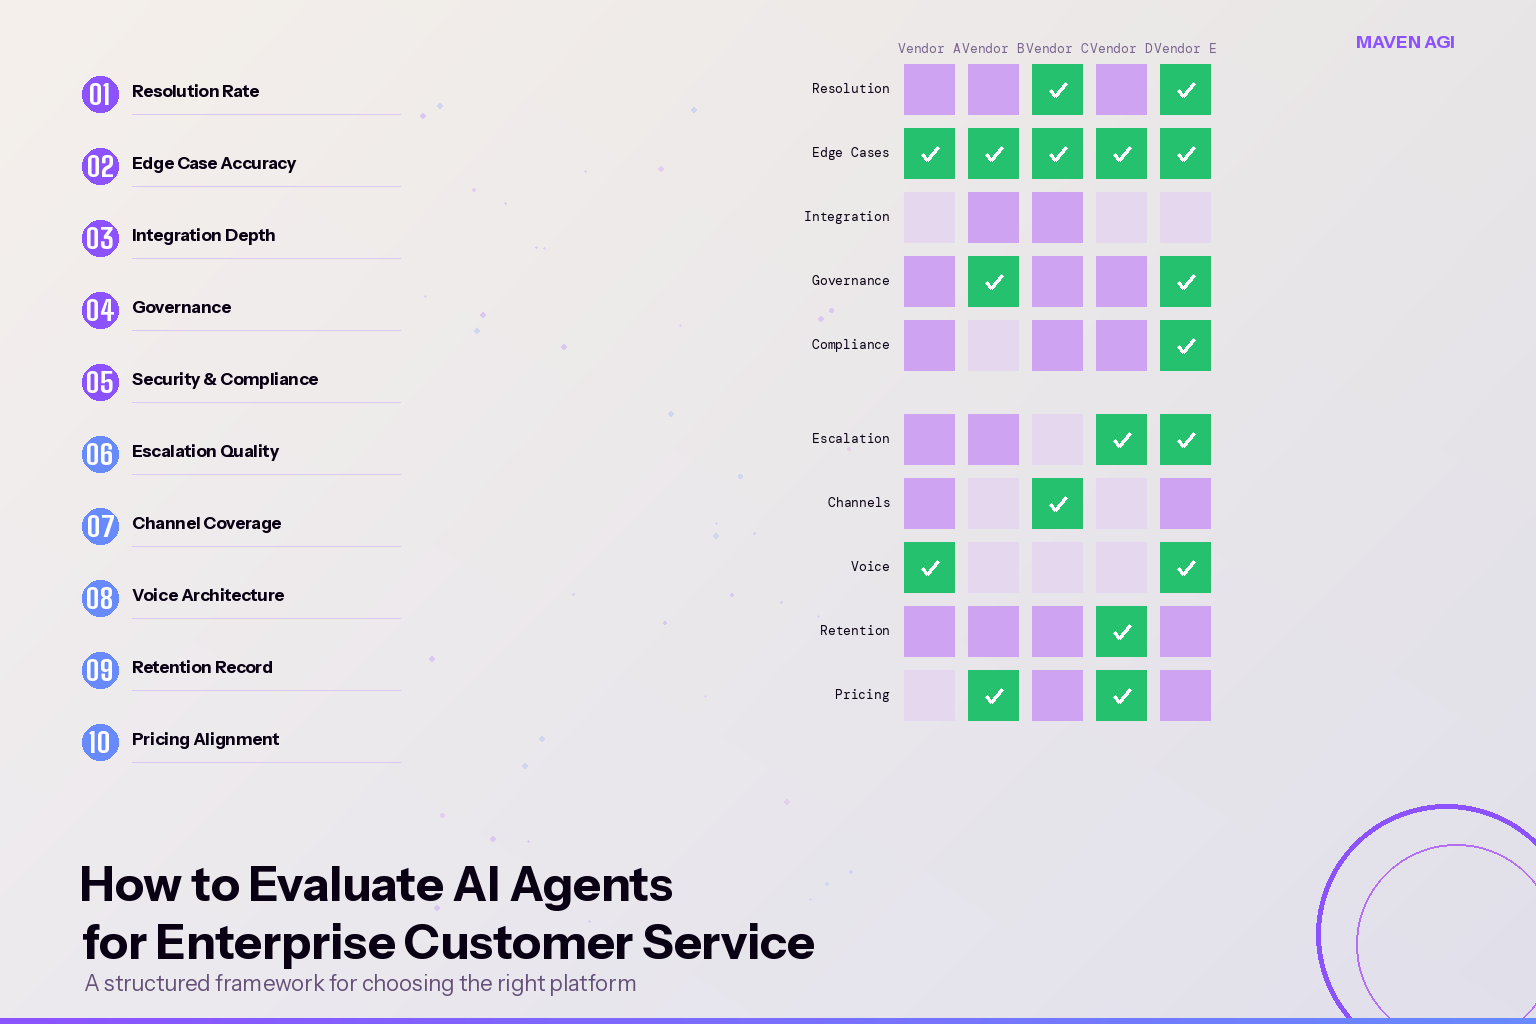
Pasar agen AI enterprise kini sudah cukup matang sehingga tidak sulit menemukan vendor yang mengklaim hasil gemilang. Lingkungan proof-of-concept rutin menghasilkan angka-angka yang memikat, seperti tingkat otomatisasi 80% atau 90%, namun implementasi yang mampu mempertahankan hasil tersebut di lingkungan produksi jauh lebih jarang. Kesenjangan ini bisa diprediksi jika Anda tahu apa yang perlu diperhatikan, dan nyaris tak terlihat jika Anda menjalankan evaluasi standar.
Yang membedakan tim yang berhasil dari yang lain bukanlah demonya, melainkan apakah mereka menguji platform secara ketat pada variabel-variabel yang menentukan kinerja di produksi. Panduan ini adalah jawaban praktis tentang cara mengevaluasi platform layanan pelanggan berbasis AI tanpa terkecoh oleh kesan pertama yang memukau, serta cara memilih platform layanan pelanggan AI terbaik untuk implementasi enterprise yang harus tetap andal di bawah volume nyata. Panduan ini disusun berdasarkan pertanyaan-pertanyaan yang membedakan platform yang dibangun untuk produksi dari platform yang dibangun agar tampil bagus saat demo. Jika membantu, mulailah dari kasus penggunaan layanan pelanggan yang benar-benar Anda jalankan, lalu tarik mundur ke kriterianya.
Mulailah dengan memahami apa yang sebenarnya Anda evaluasi
Sebagian besar evaluasi vendor dimulai dengan permintaan demo dan diakhiri dengan panggilan referensi. Proses itu dirancang untuk software yang bekerja sesuai konfigurasinya. Agen AI berbeda: kinerjanya dalam demonstrasi yang terkendali sering kali kurang bisa memprediksi kinerjanya di produksi. Variabel yang paling penting di produksi, yaitu distribusi pertanyaan, frekuensi edge case, keandalan integrasi, dan perilaku di bawah beban, justru merupakan variabel yang sengaja dihindari dalam demo.
Sebelum menjalankan evaluasi apa pun, ada 3 hal yang perlu Anda perjelas.
Apa arti resolusi untuk kasus penggunaan Anda? Bukan deflection, bukan containment. Resolusi otonom berarti masalah pelanggan benar-benar terselesaikan, mereka tidak kembali menghubungi untuk masalah yang sama, dan AI mengambil tindakan tanpa perlu manusia untuk menuntaskannya. Jika Anda tidak dapat mendefinisikan hal ini secara spesifik untuk produk Anda sebelum evaluasi dimulai, benchmark apa pun dari vendor akan sulit ditafsirkan.
Seperti apa wujud kegagalan? Agen AI yang menangani 80% interaksi dengan baik tetapi salah menangani 20% sisanya hingga merusak kepercayaan bukanlah kemenangan implementasi. Dengan mengetahui mode kegagalan Anda, seperti refund yang salah, perubahan akun yang keliru, atau eskalasi yang kehilangan konteks, Anda bisa memasukkannya ke dalam evaluasi alih-alih baru menemukannya setelah peluncuran.
Bagaimana realitas integrasi Anda? Kesenjangan kinerja antara sandbox dan produksi hampir selalu bersumber dari integrasi. Agen yang dievaluasi dengan sampel knowledge base Anda akan berperilaku berbeda dari agen yang terhubung ke CRM, sistem tiket, dan platform penagihan Anda yang sedang berjalan. Semakin awal Anda bisa menguji dengan akses sistem yang nyata, semakin prediktif hasilnya.
Pertanyaan yang mengungkap kapabilitas produksi
Evaluasi vendor standar cenderung berpusat pada fitur dan harga. Pertanyaan-pertanyaan berikut dirancang untuk mengungkap hal yang lebih spesifik: apakah platform tersebut dirancang sesuai cara kerja dukungan enterprise yang sebenarnya.
Bagaimana Anda mendefinisikan resolusi otonom, dan bagaimana mengukurnya? Jawabannya lebih informatif daripada benchmark apa pun. Vendor dengan pengalaman produksi yang nyata memiliki definisi dan metodologi pengukuran yang spesifik. Mereka membedakan antara tiket yang ditutup oleh AI, tiket yang dialihkan ke self-service, dan tiket yang sampai ke manusia. Vendor yang mengoptimalkan kinerja demo cenderung mencampuradukkan ketiganya. Minta mereka menjelaskan bagaimana tiket yang terselesaikan diklasifikasikan dibandingkan tiket yang dialihkan di sistem mereka.
Berapa tingkat kontak ulang dalam 72 jam? Inilah metrik yang membongkar resolusi palsu. Jika sebagian besar interaksi yang ditandai terselesaikan berujung pada pelanggan yang sama menghubungi dukungan lagi dalam 3 hari, tingkat resolusi efektifnya lebih rendah dari angka yang diklaim. Ini adalah pembeda yang sama antara deflection dan resolusi. Vendor yang fokus pada produksi melacaknya. Vendor yang tidak melacaknya berarti mengukur hal yang salah.
Bisakah agen mengambil tindakan di sistem backend saya, atau hanya menampilkan informasi? Integrasi read-only versus read-write adalah garis pemisah arsitekturalnya. Agen yang bisa memberi tahu pelanggan bahwa pesanannya terlambat tetapi tidak bisa menjadwalkan ulang pengiriman tidak sedang menyelesaikan masalah, melainkan sekadar menjawab pertanyaan. Untuk sebagian besar kasus penggunaan dukungan enterprise, resolusi yang sesungguhnya memerlukan akses tulis ke setidaknya 2 atau 3 sistem backend. Tanyakan integrasi mana yang tersedia melalui konektor bawaan dan mana yang memerlukan pengembangan kustom.
Bagaimana eskalasi bekerja, dan apa yang terjadi pada konteksnya? Momen eskalasi adalah titik di mana sebagian besar implementasi AI justru menciptakan hambatan alih-alih menghilangkannya. Saat agen menyerahkan percakapan ke manusia, apakah manusia tersebut menerima ringkasan percakapan dan riwayat akun pelanggan, atau pelanggan harus mengulang dari awal? Uji hal ini secara khusus selama evaluasi. Ini adalah interaksi yang paling mungkin memicu keluhan, dan yang paling sering diabaikan dalam demo.
Apa yang dilakukan agen ketika tidak tahu jawabannya? Kegagalan yang tertangani dengan baik sama pentingnya dengan kinerja yang kuat. Perhatikan bagaimana sistem menangani pertanyaan di luar cakupan pelatihannya, permintaan yang ambigu, dan upaya sengaja untuk memancing output yang buruk. Vendor yang yakin dengan penanganan kasus-kasus ini akan mempersilakan Anda mengujinya selama evaluasi. Vendor yang menghindari pengujian ini biasanya punya alasan.
Berapa lama integrasi berlangsung? Jika jawaban jujurnya adalah berbulan-bulan, itu informasi yang berguna. Implementasi enterprise yang memerlukan layanan profesional berkepanjangan sebelum go-live membawa biaya dan risiko yang signifikan. Arsitektur overlay yang terhubung ke help desk yang sudah ada tanpa perlu migrasi data sering kali bisa go-live dalam hitungan minggu. Minta timeline spesifik mulai dari kontrak ditandatangani hingga interaksi live pertama.
Jebakan proof-of-concept
POC hampir selalu ada dalam evaluasi AI enterprise, dan hampir selalu menghasilkan hasil yang lebih baik daripada implementasi produksi. Ini bukan kebetulan. POC berjalan dengan data bersih, cakupan pertanyaan terbatas, dan dukungan dari pihak vendor. POC disetel khusus untuk evaluasi. Implementasi produksi berjalan dengan seluruh ragam pertanyaan pelanggan, terhubung ke sistem yang tidak pernah dirancang untuk bekerja dengan AI, dan dikelola oleh tim yang punya pekerjaan lain.
Untuk menutup kesenjangan ini, dorong agar kondisi POC benar-benar menyerupai produksi. Jalankan dengan pertanyaan live dari basis pelanggan Anda yang sebenarnya, bukan sampel. Hubungkan ke sistem yang setara dengan produksi, bukan sandbox. Jalankan cukup lama hingga kinerjanya stabil, bukan hanya pada periode awal yang sudah disetel. Tanyakan berapa persen pertanyaan selama POC yang berada dalam cakupan yang telah dikonfigurasi sebelumnya dibandingkan yang di luarnya. Sebagian besar pilot yang tampak bagus saat demo tidak pernah sampai ke produksi, dan alasannya cukup konsisten sehingga bisa diantisipasi; ulasan tentang kesenjangan dari pilot ke produksi membahas apa yang membedakan keduanya.
Vendor yang bersedia menjalankan POC dalam kondisi tersebut adalah vendor yang membangun untuk produksi. Vendor yang bersikeras mengendalikan kondisi secara ketat sedang mengoptimalkan POC itu sendiri.
Seperti apa evaluasi yang ketat dalam praktik
Evaluasi terbaik datang dari tim yang memperlakukan pemilihan vendor sebagai keputusan engineering, bukan formalitas pengadaan. Ketika Clio, platform legal-tech, berupaya mengganti bot berbasis skrip yang sudah usang, timnya mengevaluasi 32 vendor, lalu menjalankan uji perbandingan langsung terhadap lebih dari 10 vendor sebelum memilih Maven. Mereka menguji berdasarkan kebutuhan nyata: jawaban akurat untuk pertanyaan chat dalam aplikasi, integrasi mendalam dengan stack yang sudah ada termasuk Salesforce, dan kinerja pada edge case yang membuat sistem berbasis skrip gagal.
Hasilnya terbukti di produksi, bukan hanya di demo: 80% resolusi otonom, dengan dukungan live 4x lebih cepat untuk pertanyaan teknis yang masih sampai ke manusia. Kombinasi tersebut, resolusi otonom yang tinggi disertai penanganan pengecualian yang lebih cepat, adalah ciri evaluasi yang diuji untuk produksi, bukan untuk kesan pertama yang memukau. Inilah juga kesamaan tim CX terbaik: mereka merancang evaluasi untuk menemukan titik-titik kegagalan sebelum menandatangani kontrak, bukan sesudahnya.
Kepatuhan bukan tambahan
Untuk sebagian besar implementasi enterprise, jalan dari POC ke produksi melewati tinjauan keamanan Anda. Di sinilah banyak evaluasi agen AI terhenti atau gagal sepenuhnya. Persyaratan kepatuhan untuk agen AI yang secara otonom menangani data pelanggan, memproses transaksi, dan mengambil tindakan di sistem produksi sangatlah besar, dan sebagian besar organisasi tidak sesiap yang mereka kira. Dalam survei Grant Thornton tahun 2026, 78% pemimpin mengaku tidak yakin dapat lolos audit AI dalam 90 hari.
Evaluasi postur kepatuhan sejak awal, bukan sebagai pemeriksaan terakhir. Secara spesifik: apakah vendor memiliki SOC 2 Type II, ketersediaan HIPAA BAA, perjanjian pemrosesan data GDPR, dan kepatuhan PCI-DSS untuk alur kerja yang berkaitan dengan pembayaran. Apakah jejak audit tersedia dan dapat ditelusuri untuk setiap tindakan agen. Apakah subprosesor vendor telah dievaluasi dan diungkapkan. Apakah platform dapat beroperasi sesuai persyaratan residensi data Anda.
Vendor dengan infrastruktur kepatuhan enterprise yang sesungguhnya akan menjawab pertanyaan ini dengan dokumentasi, bukan sekadar jaminan. Vendor yang memperlakukan kepatuhan sebagai formalitas di tahap akhir adalah yang paling mungkin gagal dalam tinjauan keamanan setelah Anda telanjur berinvestasi dalam evaluasi.
Panggilan referensi yang seharusnya Anda minta
Sebagian besar panggilan referensi vendor dirancang untuk mengonfirmasi pengalaman positif. Sebaliknya, mintalah panggilan referensi dengan pelanggan yang mengalami implementasi sulit, yang memerlukan troubleshooting signifikan sebelum berjalan dengan baik. Cara vendor menangani implementasi tersebut lebih informatif daripada 3 implementasi yang mulus.
Tanyakan secara spesifik kepada referensi apa yang salah, berapa lama penyelesaiannya, dan apakah mereka mendapatkan dukungan yang dibutuhkan. Jawabannya menentukan apakah Anda ingin tetap bekerja sama dengan vendor ini 18 bulan setelah implementasi produksi berjalan.
Jalankan evaluasi yang memprediksi kinerja produksi
Setiap vendor bisa lolos demo. Jauh lebih sedikit yang bisa lolos evaluasi yang dirancang untuk mengungkap apa yang terjadi pada volume nyata, di sistem nyata, di bawah tinjauan keamanan yang nyata. Gunakan pertanyaan-pertanyaan ini sebagai scorecard, jalankan POC dengan pertanyaan tersulit Anda, dan utamakan referensi produksi di atas penghargaan analis. Tim yang konsisten melakukan ini adalah tim yang implementasinya tetap berkinerja baik setahun kemudian.
Lihat bagaimana kerangka ini bertahan menghadapi volume tiket Anda sendiri. Jadwalkan demo dan bawa pertanyaan yang Anda perkirakan bisa membuatnya gagal.
Lihat langsung pada percakapan Anda sendiri.
Minta demo personal gratis.


