
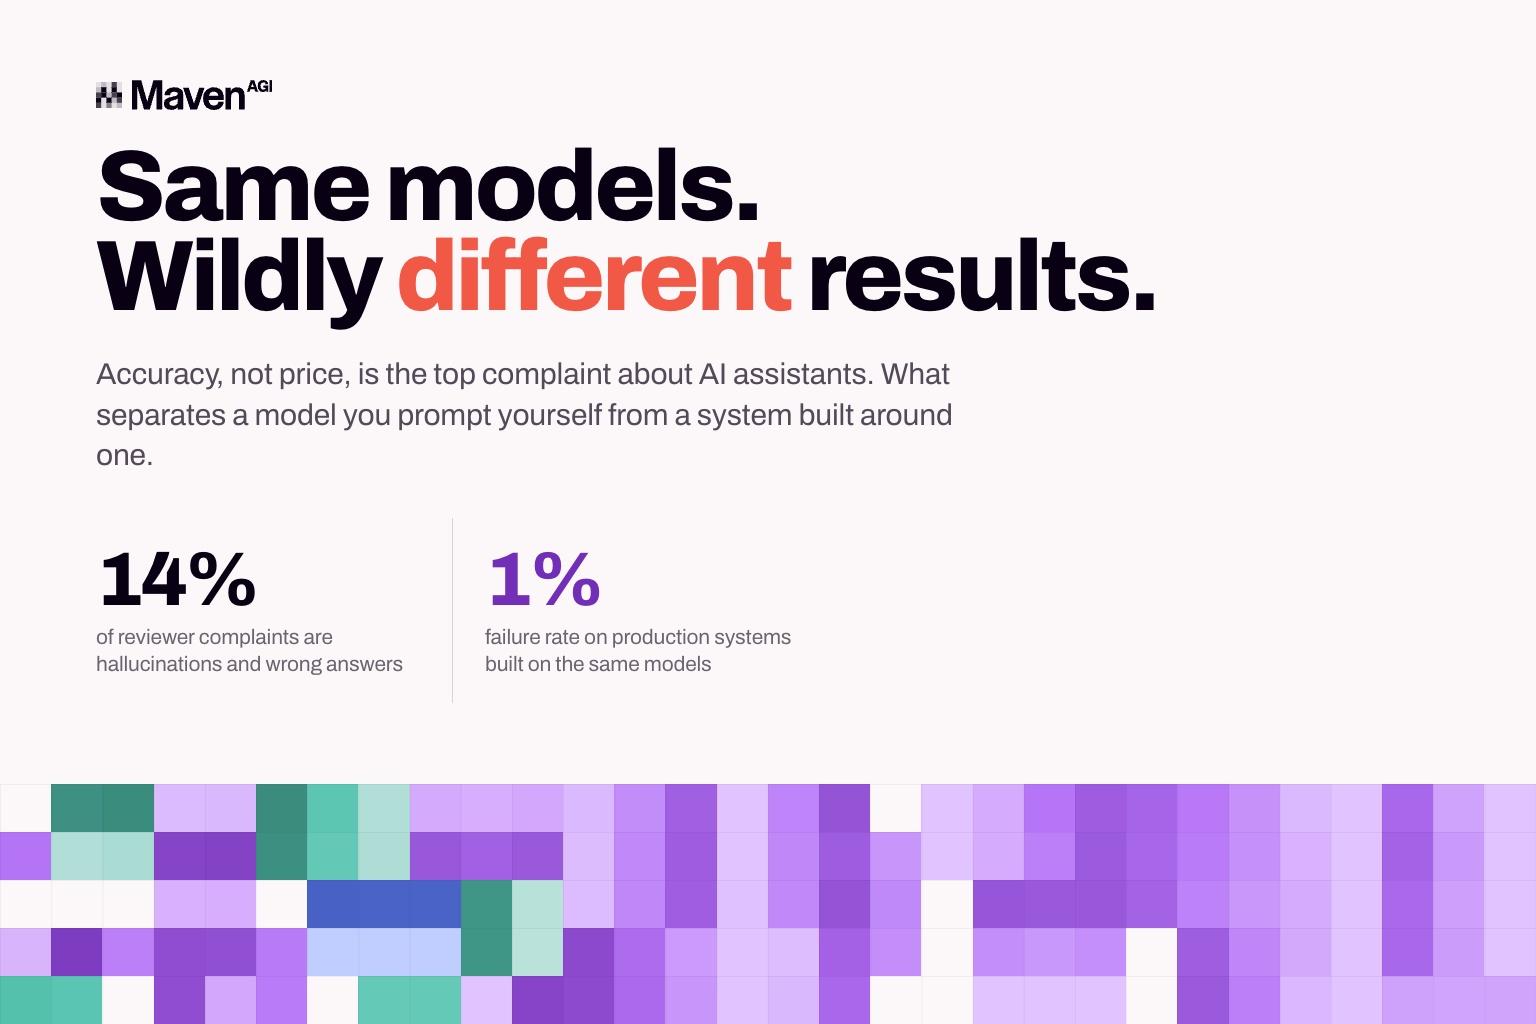
G2 a passé en revue plus de 2 950 avis vérifiés publiés entre janvier et mi-juillet pour identifier les principaux motifs de plainte. Le premier n'était pas le prix, mais la précision. Les hallucinations et les réponses erronées représentaient 14 % de tout ce que les utilisateurs disaient ne pas aimer, devant le coût, alors même que cette année le coût est au cœur de tous les débats.
Il est utile de savoir qui sont ces utilisateurs, car cela change la portée du chiffre. La plupart parlent des assistants généralistes que tout le monde garde ouverts dans un onglet de navigateur. Il ne s'agit pas d'équipes CX décrivant un agent de support en production. Ce sont des personnes qui posent une question à un modèle, reçoivent une réponse assurée, puis doivent vérifier par elles-mêmes si elle est exacte.
G2 a ensuite interrogé quatre éditeurs qui construisent des systèmes de production sur ces mêmes modèles, en leur demandant quels sont réellement leurs taux d'échec. Réponse : jusqu'à 1 % seulement.
La vraie comparaison n'oppose donc pas un modèle à un autre. Elle oppose un modèle que vous interrogez vous-même à un système que quelqu'un a construit autour d'un modèle : même technologie sous-jacente, résultats radicalement différents. Maven faisait partie des quatre éditeurs interrogés par G2.
Ce qui explique l'écart
Rien de ce qu'ont décrit ces quatre éditeurs ne tenait au choix du modèle. Tous ont dit à peu près la même chose. Leurs systèmes fonctionnent par étapes plutôt qu'en une seule passe. Les réponses s'appuient sur des données en temps réel plutôt que sur ce dont le modèle se souvient de son entraînement. Ils mesurent la fréquence à laquelle une tâche est réellement menée à bien, et ils réécrivent prompts et logique au moins une fois par semaine. L'un d'eux le fait quotidiennement. Tout ce travail se fait autour du modèle, pas sur le modèle.
Le point d'accord le plus utile concerne la répartition de l'effort. Pour les quatre, la difficulté n'est pas la question courante, mais le cas limite et la tâche en plusieurs étapes. Ils conçoivent donc des systèmes capables de détecter quand ils dépassent leurs compétences et de transmettre la conversation à une personne au lieu de deviner. Dans l'enquête, Maven le résumait ainsi : « l'autonomie sans mécanisme de repli fiable n'est pas une fonctionnalité, c'est un risque ».
L'essentiel de l'écart est là. Quand vous interrogez un modèle vous-même, c'est à vous de vérifier son travail. Un système de production est conçu pour que cette tâche ne retombe jamais sur le client. G2 l'a dit clairement : ces éditeurs ne constatent pas moins d'erreurs, ils les interceptent avant que quiconque ne les remarque.
Le débat agent contre chatbot est surtout une affaire de vocabulaire
G2 a demandé sans détour à ses quatre éditeurs si les agents IA sont plus fiables que ce que la catégorie appelle encore des chatbots. Tous ont répondu à peu près la même chose, ce qui n'est pas une bonne nouvelle pour ceux qui misent tout sur le mot. En production, les deux sont bien moins différents que le marketing ne le laisse entendre, et remplacer une étiquette par une autre ne règle rien en soi.
C'est plus important pour les acheteurs que pour les éditeurs. Si vous cherchez le mot « agent », vous achetez une étiquette, pas une capacité. Qu'un éditeur appelle son produit un agent et qu'un autre l'appelle autrement ne vous dit rien sur le fait que l'un ou l'autre consulte vos connaissances à jour, détecte quand il n'est pas sûr, ou soit évalué sur de vraies conversations après le lancement. Ce sont des propriétés de l'IA agentique dans le service client, et aucune n'est fournie avec l'étiquette.
Les questions réellement révélatrices portent sur la façon dont le système est construit, et vous pouvez poser les cinq dès le premier appel.
- D'où viennent les réponses ? Le système consulte-t-il vos connaissances en temps réel, ou s'appuie-t-il sur ce que le modèle a assimilé pendant son entraînement ?
- Que se passe-t-il quand il n'est pas sûr ? Passe-t-il la main, ou devine-t-il avec la même assurance que lorsqu'il a raison ?
- À quelle fréquence quelqu'un vérifie-t-il ses réponses sur de vraies conversations, et que mesure-t-on ?
- Votre équipe peut-elle modifier le comportement de l'agent, ou chaque ajustement doit-il repasser par l'éditeur ?
- Peut-il réellement agir dans vos systèmes, ou peut-il seulement dire au client quoi faire ?
Si un éditeur sait répondre aux cinq, c'est que le travail a été fait. S'il maîtrise la première et devient flou ensuite, il a acheté un modèle et l'a habillé d'un widget. Vous trouverez une version plus complète de cette liste dans notre guide pour évaluer les agents IA pour le service client en entreprise.
Ce que les acheteurs négligent
Ce que décrivent ces quatre éditeurs correspond à la pile sur laquelle repose l'architecture à cinq couches de Maven. Le modèle n'est qu'une couche. Tout ce qui le rend fiable se situe autour : ce que l'agent sait, ce qu'il est autorisé à faire, la façon dont vous vérifiez son travail une fois en production, et qui détient les garde-fous. Les acheteurs comparent généralement les modèles, car c'est la couche qui porte les noms célèbres. Or tout ce que pointent les données de G2 se trouve dans les quatre autres, et c'est ce qui fait que la résolution autonome est autre chose qu'une bonne réponse.
C'est aussi pourquoi rapidité de déploiement et fiabilité ne s'opposent pas, quoi qu'en pense la catégorie. Construire ces couches est un vrai travail d'ingénierie, mais il est fait une seule fois, au sein de la plateforme, au lieu de devenir un projet de six mois dans l'environnement de chaque client.
À quoi ressemble un travail bien fait
Mastermind a atteint 93 % de résolution autonome en six semaines. K1x a atteint 80 % dès sa première semaine. Rho a maintenu un CSAT de 95 % tout en absorbant 12 % de contacts supplémentaires par mois, sans recruter. Quest a construit AskQ sur Maven, l'a connecté à une base de connaissances et à un système de gestion des dossiers déjà en place, sans migration de données, et l'évalue sur la satisfaction client plutôt que sur la déflexion.
Les avis sur Maven vont dans le même sens. 4,8 sur 5 sur 20 avis vérifiés, et ce que les utilisateurs mettent en avant mérite d'être lu : un seul moteur pour le chat, l'e-mail et la voix au lieu de bots distincts à synchroniser ; une recherche de connaissances qui signale les articles obsolètes, en double ou contradictoires plutôt que de répondre à partir du premier trouvé ; une mise en place qui se compte en jours sur Salesforce ou Zendesk. Tout cela relève de ce qui entoure le modèle.
Dans les rapports G2 de l'automne 2026, publiés le 25 août, Maven figure dans la Mid-Market Grid for Customer Service Automation, le Mid-Market Results Index for AI Customer Support Agents et l'Implementation Index for AI Customer Support Agents. Les rapports Index reposent sur ce que les clients disent des résultats obtenus et du déroulement du déploiement, et non sur la taille ou la notoriété de l'entreprise. Ils mesurent précisément ce que les données plus larges de G2 identifient comme défaillant partout ailleurs.
L'écart, c'est tout le sujet
Le chiffre à retenir est l'écart entre 14 % et 1 %, car les deux reposent sur la même poignée de modèles. Rien dans la technologie n'explique un tel écart. Ce qui l'explique, c'est que quelqu'un ait pris ou non la peine de construire les éléments qui interceptent une mauvaise réponse avant qu'un client ne la voie. C'est pourquoi un taux de résolution n'a de sens que si l'on sait comment il a été mesuré.
La plupart des acheteurs en sont encore à comparer des noms de modèles. Les quatre éditeurs interrogés par G2 y ont renoncé depuis longtemps.
Si vous préférez voir ces couches plutôt que lire à leur sujet, réservez une démo.
Voyez-le à l’œuvre sur vos propres conversations.
Demandez une démo personnalisée gratuite.


