
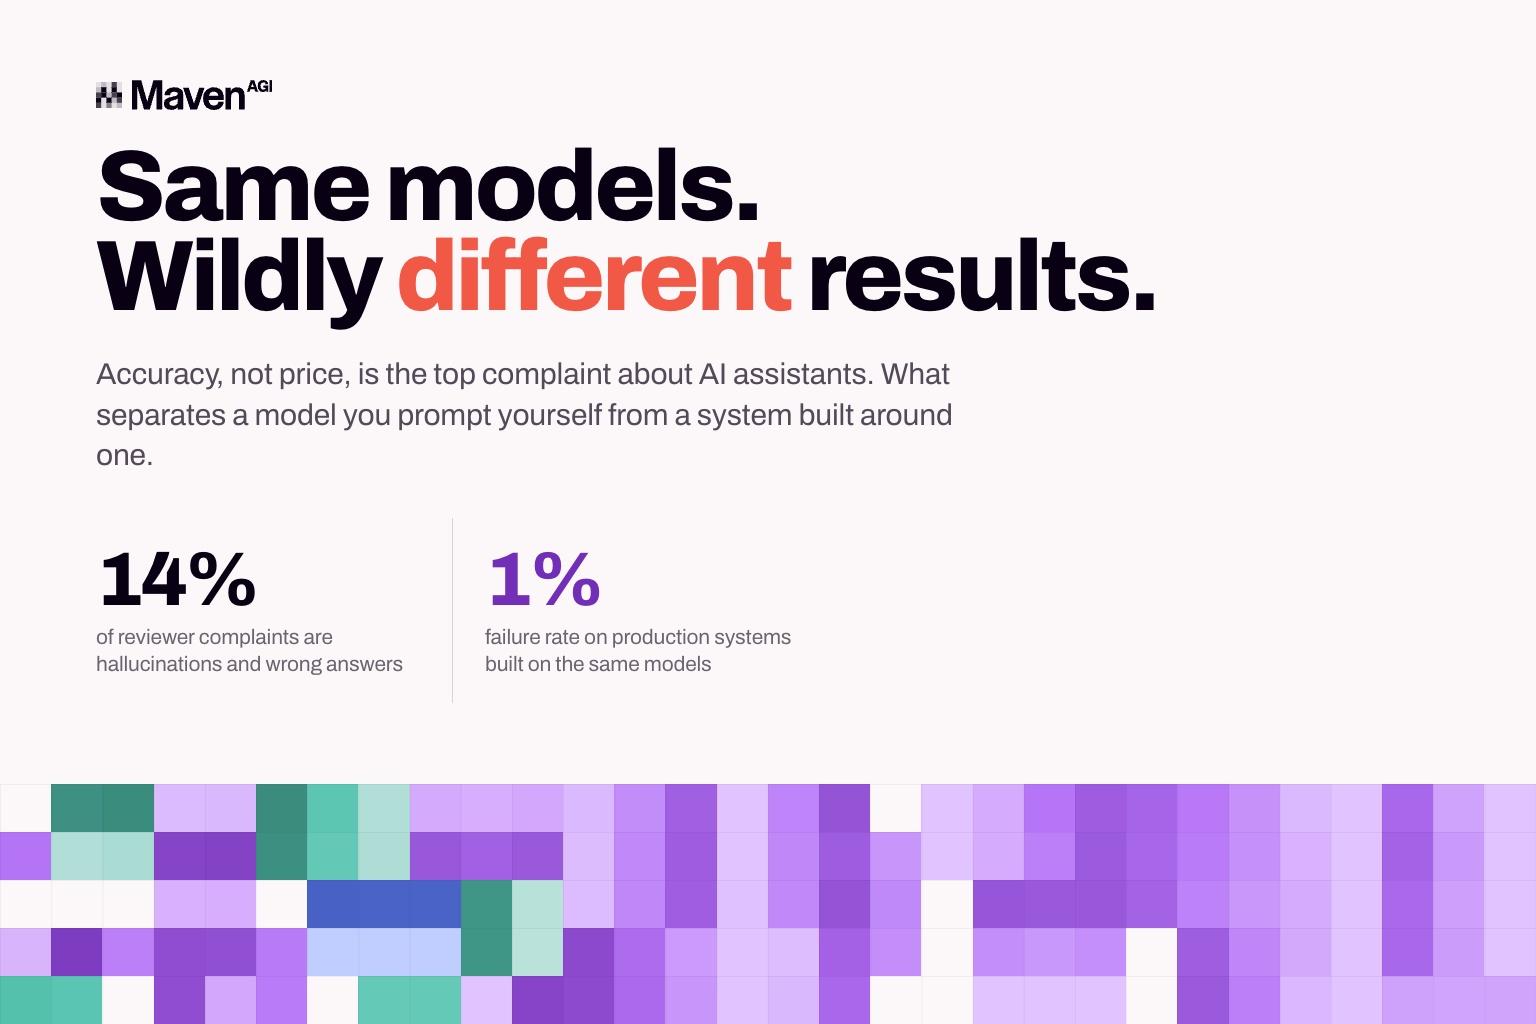
G2 las meer dan 2.950 geverifieerde reviews door van januari tot half juli en keek waar mensen het vaakst over klagen. De grootste ergernis was nauwkeurigheid, niet de prijs. Hallucinaties en foute antwoorden waren goed voor 14% van alles wat reviewers als minpunt noemden. Daarmee eindigden ze boven kosten, in een jaar waarin iedereen het alleen maar over kosten wil hebben.
Het is goed om te weten wie die reviewers zijn, want dat verandert wat het cijfer betekent. De meesten hebben het over de algemene assistenten die iedereen in een browsertabblad open heeft staan. Het zijn geen CX-teams die een support-agent in productie beschrijven. Het zijn mensen die een model iets vragen, een stellig antwoord terugkrijgen en vervolgens zelf moeten uitzoeken of het klopt.
Daarna vroeg G2 aan 4 leveranciers die productiesystemen op diezelfde modellen bouwen hoe hoog hun foutpercentages werkelijk zijn. Soms maar 1%.
Wat hier eigenlijk wordt vergeleken, is dus niet het ene model met het andere. Het is een model dat je zelf prompt tegenover een systeem dat iemand rond een model heeft gebouwd: dezelfde technologie eronder, totaal andere resultaten. Maven was een van de 4 leveranciers die G2 benaderde.
Waar het verschil vandaan komt
Niets van wat die 4 beschreven had te maken met het model dat ze hadden gekozen. Ze zeiden allemaal min of meer hetzelfde. Hun systemen werken in stappen in plaats van in één keer. Antwoorden komen uit live data in plaats van uit wat het model toevallig nog weet uit zijn training. Ze meten hoe vaak een taak echt wordt afgerond, en ze herschrijven prompts en logica minstens 1 keer per week. Eén van hen doet dat dagelijks. Dat is allemaal werk rondom het model, niet aan het model.
Nuttiger is waar ze het over eens waren als het gaat om waar de inspanning naartoe gaat. Alle 4 zeiden dat het lastige deel niet de alledaagse vraag is, maar de uitzondering en de taak met meerdere stappen. Daarom bouwen ze systemen die doorhebben wanneer ze er niet uitkomen en het gesprek dan aan een mens overdragen in plaats van te gokken. Maven zei het in de enquête zo: “Autonomie zonder betrouwbare fallback-logica is geen feature, maar een risico.”
Daar zit het grootste deel van het verschil. Als je zelf een model prompt, ben jij degene die het werk controleert. Een productiesysteem is zo gebouwd dat die taak nooit bij de klant terechtkomt. G2 zei het zonder omwegen: deze leveranciers zien niet minder fouten, ze vangen ze op voordat iemand het merkt.
Het debat over agents versus chatbots gaat vooral over woorden
G2 vroeg de 4 leveranciers op de man af of AI-agents betrouwbaarder zijn dan wat de categorie nog steeds chatbots noemt. Ze zeiden allemaal ongeveer hetzelfde, en dat is geen goed nieuws voor wie op dat woord verkoopt. In productie liggen de 2 lang niet zo ver uit elkaar als de marketing doet geloven, en het ene label inruilen voor het andere lost op zichzelf niets op.
Dat is belangrijker voor kopers dan voor leveranciers. Als je shopt op het woord “agent”, koop je een label en geen capaciteit. Of de ene leverancier zijn product een agent noemt en de andere iets anders, zegt niets over of een van beide informatie opzoekt in je actuele kennis, doorheeft wanneer het niet zeker is, of na de lancering wordt getoetst aan echte gesprekken. Dat zijn eigenschappen van agentic AI in de klantenservice, en geen van die eigenschappen komt mee met het label.
De vragen die je wél iets vertellen, gaan over hoe het systeem is gebouwd. Je kunt ze alle 5 in een eerste gesprek stellen.
- Waar komen de antwoorden vandaan? Zoekt het systeem informatie op in je live kennis, of gaat het uit van wat het model tijdens de training heeft opgepikt?
- Wat gebeurt er als het niet zeker is? Draagt het over, of gokt het met dezelfde stelligheid als wanneer het gelijk heeft?
- Hoe vaak controleert iemand de antwoorden aan de hand van echte gesprekken, en wat wordt er dan gemeten?
- Kan je team aanpassen hoe de agent zich gedraagt, of moet elke wijziging via de leverancier?
- Kan het daadwerkelijk iets doen in je systemen, of kan het de klant alleen vertellen wat die moet doen?
Als een leverancier alle 5 kan beantwoorden, heeft iemand het werk gedaan. Als het eerste antwoord raak is en het daarna vaag wordt, hebben ze een model gekocht en er een widget omheen gezet. Een uitgebreidere versie van deze lijst vind je in onze gids over het evalueren van AI-agents voor enterprise-klantenservice.
De onderdelen die kopers overslaan
Wat die 4 leveranciers beschreven, is dezelfde stack waarop Mavens 5-lagenarchitectuur is gebouwd. Het model is slechts een van die lagen. Alles wat het betrouwbaar maakt, zit eromheen: wat de agent weet, wat hij mag doen, hoe je zijn werk controleert zodra hij live is, en wie de guardrails beheert. Kopers kiezen meestal op het model, omdat dat de laag is met de bekende namen. Alles waar de data van G2 naar wijst, zit in de andere 4 lagen, en dat is precies waarom autonome afhandeling iets anders is dan een goed antwoord.
Het is ook de reden dat snel implementeren en betrouwbaarheid elkaar niet uitsluiten, wat de categorie ook aanneemt. Die lagen bouwen is echt engineeringwerk, maar het gebeurt 1 keer, binnen het platform, in plaats van dat het een project van 6 maanden wordt in de stack van elke klant.
Hoe het eruitziet als het werk gedaan is
Mastermind bereikte binnen 6 weken 93 procent autonome afhandeling. K1x haalde 80 procent in de eerste week. Rho hield een CSAT van 95 procent vast terwijl het 12 procent meer contacten per maand verwerkte, zonder iemand aan te nemen. Quest bouwde AskQ op Maven, koppelde het zonder datamigratie aan een bestaande kennisbank en een bestaand casesysteem, en beoordeelt het op klanttevredenheid in plaats van deflectie.
De reviews van Maven zelf wijzen dezelfde kant op. 4,8 van de 5 op basis van 20 geverifieerde reviews, en het loont om te lezen wat mensen echt noemen: een enkele engine voor chat, e-mail en voice in plaats van losse bots die je synchroon moet houden; kennisopvraging die verouderde, dubbele en tegenstrijdige artikelen signaleert in plaats van te antwoorden op basis van het eerste artikel dat het vindt; een implementatie die in dagen wordt gemeten bovenop Salesforce of Zendesk. Dat is allemaal wat er rondom het model zit.
In de Fall 2026-rapporten van G2, verschenen op 25 augustus, kwam Maven terecht in de Mid-Market Grid voor Customer Service Automation, de Mid-Market Results Index voor AI Customer Support Agents en de Implementation Index voor AI Customer Support Agents. Indexrapporten zijn gebaseerd op wat klanten zeggen over de behaalde resultaten en het verloop van de uitrol, niet op hoe groot of bekend een bedrijf is. Ze meten precies datgene waarvan de bredere data van G2 zegt dat het overal elders misgaat.
Het verschil is het verhaal
Het cijfer om op te letten is de afstand tussen 14% en 1%, want beide draaien op hetzelfde handjevol modellen. Niets aan de technologie verklaart zo'n groot verschil. Wat het wel verklaart, is of iemand de moeite heeft genomen om de onderdelen te bouwen die een slecht antwoord onderscheppen voordat een klant het ziet. Daarom zegt een resolution rate pas iets als je weet hoe die is gemeten.
De meeste kopers vergelijken nog steeds modelnamen. De 4 leveranciers die G2 sprak, zijn daar al een tijd geleden mee gestopt.
Wil je de lagen zien in plaats van erover te lezen? Plan een demo.
Zie het op je eigen gesprekken.
Vraag een gratis demo op maat aan.


