
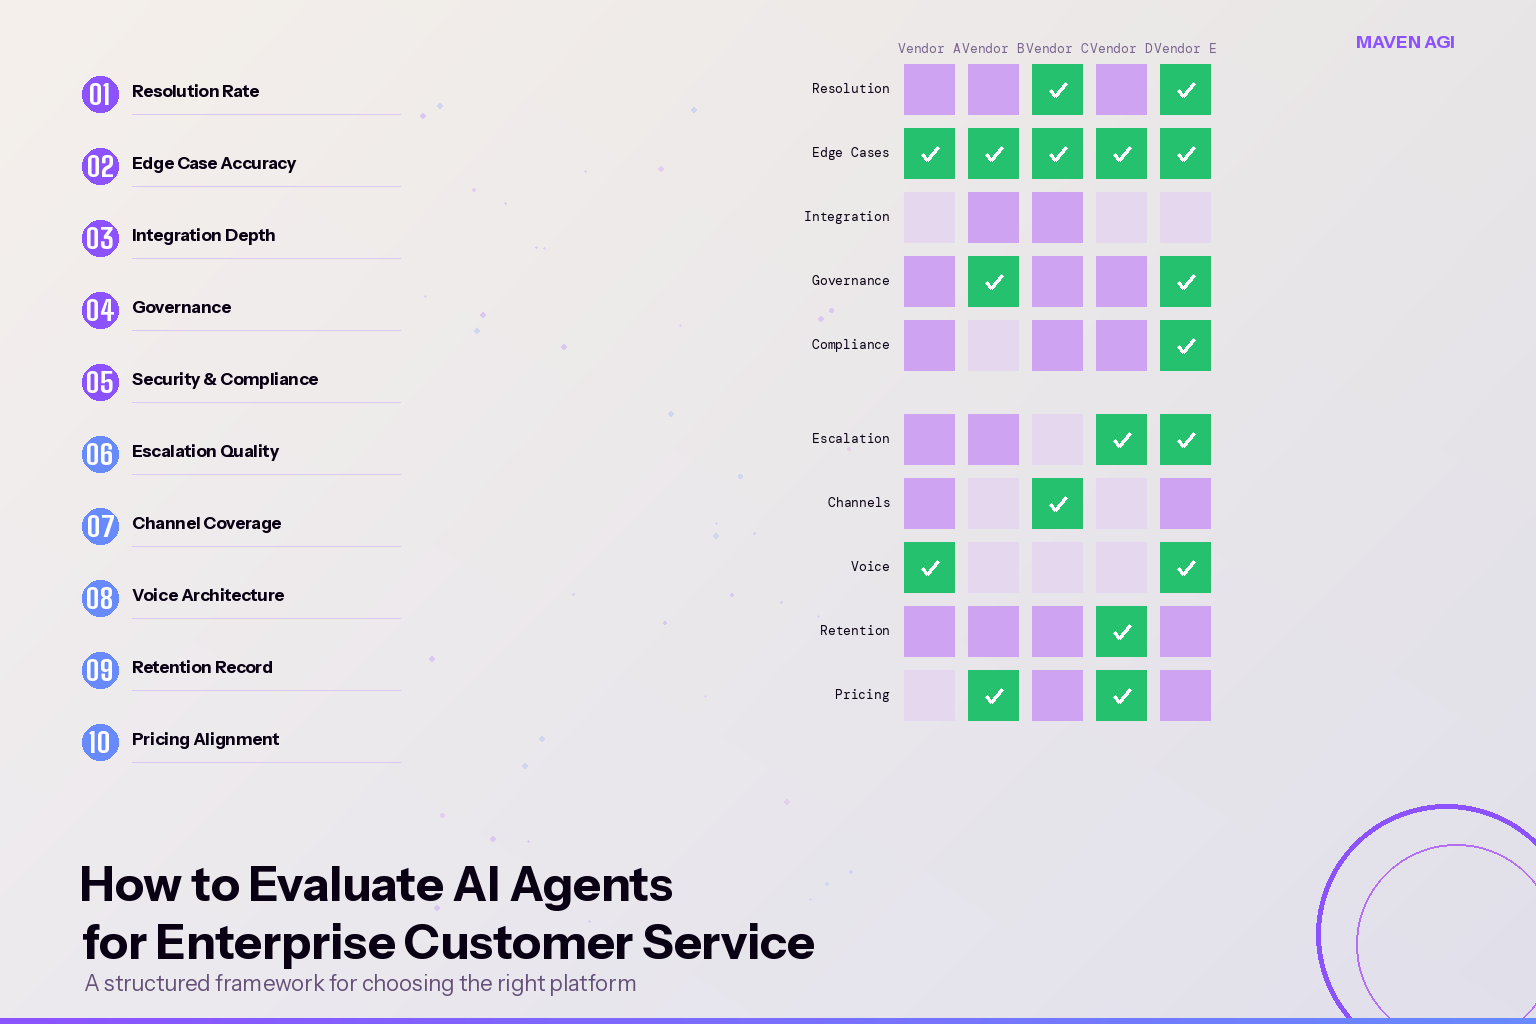
De markt voor enterprise AI-agents is inmiddels zo volwassen dat er geen gebrek is aan leveranciers die sterke resultaten claimen. Proof-of-concept-omgevingen leveren regelmatig de opvallende cijfers op, automatiseringsgraden van 80% of 90%, maar implementaties die die resultaten in productie vasthouden zijn een stuk zeldzamer. Die kloof is voorspelbaar als je weet waar je op moet letten, en grotendeels onzichtbaar als je een standaardevaluatie uitvoert.
Het verschil tussen de teams die dit goed doen en de rest zit niet in de demo. Het zit erin of ze het platform grondig hebben getest op de variabelen die bepalen hoe het in productie presteert. Deze gids geeft een praktisch antwoord op de vraag hoe je AI-platforms voor klantenservice evalueert zonder je te laten misleiden door een gepolijste eerste indruk, en hoe je het beste AI-platform voor klantenservice kiest voor een enterprise-implementatie die onder echt volume overeind moet blijven. Hij is opgebouwd rond de vragen die platforms voor productie onderscheiden van platforms die vooral goed demonstreren. Helpt het om uit te gaan van de klantenservice-use-cases die je daadwerkelijk draait, begin dan daar en werk terug naar de criteria.
Begin met begrijpen wat je eigenlijk evalueert
De meeste leveranciersevaluaties beginnen met een demoverzoek en eindigen met een referentiegesprek. Dat proces is ontworpen voor software die doet waarvoor hij is geconfigureerd. AI-agents zijn anders: hun prestaties in een gecontroleerde demonstratie zeggen vaak weinig over hun prestaties in productie. De variabelen die in productie het zwaarst wegen, zoals de verdeling van vragen, de frequentie van randgevallen, de betrouwbaarheid van integraties en het gedrag onder belasting, zijn precies de variabelen die demo's zo ingericht zijn te vermijden.
Voordat je een evaluatie start, is het goed om 3 dingen helder te hebben.
Wat betekent resolutie voor jouw use case? Niet deflectie, niet containment. Autonome resolutie betekent dat het probleem van de klant is opgelost, dat de klant niet terugkomt over hetzelfde probleem en dat de AI de actie heeft uitgevoerd zonder dat een mens die hoefde af te ronden. Als je dit niet specifiek voor jouw product kunt definiëren voordat de evaluatie begint, is elke benchmark van de leverancier lastig te interpreteren.
Hoe ziet falen eruit? Een AI-agent die 80% van de interacties goed afhandelt, maar de overige 20% zo verkeerd aanpakt dat het vertrouwen beschadigt, is geen geslaagde implementatie. Als je je faalscenario's kent, zoals onterechte terugbetalingen, onjuiste accountwijzigingen of escalaties waarbij context verloren gaat, kun je die in de evaluatie meenemen in plaats van ze na de lancering te ontdekken.
Hoe ziet jouw integratiewerkelijkheid eruit? Het prestatieverschil tussen sandbox en productie is bijna altijd terug te voeren op integratie. Een agent die is geëvalueerd op een deel van je kennisbank gedraagt zich anders dan een agent die is gekoppeld aan je live CRM, ticketsysteem en factureringsplatform. Hoe eerder je kunt testen met echte systeemtoegang, hoe voorspellender de resultaten.
De vragen die productiegeschiktheid blootleggen
Standaard leveranciersevaluaties draaien vaak om functies en prijzen. Deze vragen zijn bedoeld om iets specifiekers boven tafel te krijgen: of het platform is ontworpen voor hoe enterprise-support in de praktijk werkt.
Hoe definieer je autonome resolutie en hoe meet je die? Het antwoord vertelt je meer dan welke benchmark ook. Leveranciers met echte productie-ervaring hebben specifieke definities en specifieke meetmethoden. Ze maken onderscheid tussen tickets die door de AI zijn gesloten, tickets die naar selfservice zijn afgeleid en tickets die bij een mens zijn beland. Leveranciers die optimaliseren voor demoprestaties gooien die vaak op één hoop. Vraag ze uit te leggen hoe een opgelost ticket in hun systeem wordt geclassificeerd ten opzichte van een afgeleid ticket.
Wat is je recontactpercentage binnen 72 uur? Dit is de metric die schijnresolutie blootlegt. Als een aanzienlijk deel van de als opgelost gemarkeerde interacties ertoe leidt dat dezelfde klant binnen 3 dagen opnieuw contact opneemt, ligt de werkelijke resolutiegraad lager dan het kopcijfer. Het is hetzelfde onderscheid als dat tussen deflectie en resolutie. Leveranciers die op productie gericht zijn, houden dit bij. Leveranciers die dat niet doen, meten het verkeerde.
Kan de agent acties uitvoeren in mijn backendsystemen, of alleen informatie tonen? Alleen-lezen versus lezen-en-schrijven is de architectonische scheidslijn. Een agent die een klant kan vertellen dat zijn bestelling vertraagd is, maar de levering niet kan verzetten, lost het probleem niet op: hij beantwoordt een vraag. Voor de meeste enterprise-supportscenario's vereist echte resolutie schrijftoegang tot minstens 2 of 3 backendsystemen. Vraag welke integraties beschikbaar zijn via kant-en-klare connectors en welke maatwerk vereisen.
Hoe werkt escalatie en wat gebeurt er met de context? Bij escalatie creëren de meeste AI-implementaties juist frictie in plaats van die weg te nemen. Krijgt de medewerker bij de overdracht een samenvatting van het gesprek en de accountgeschiedenis van de klant, of moet de klant opnieuw beginnen? Test dit tijdens de evaluatie specifiek. Het is de interactie die het vaakst tot klachten leidt, en de interactie die in demo's het vaakst wordt overgeslagen.
Wat doet de agent als hij het antwoord niet weet? Netjes falen is net zo belangrijk als sterk presteren. Kijk hoe het systeem omgaat met vragen buiten zijn training, dubbelzinnige verzoeken en bewuste pogingen om slechte output uit te lokken. Leveranciers die vertrouwen hebben in hoe ze deze gevallen afhandelen, laten je ze tijdens de evaluatie gewoon testen. Leveranciers die deze tests uit de weg gaan, hebben daar meestal een reden voor.
Hoe lang duurt de integratie? Als het eerlijke antwoord maanden is, is dat nuttige informatie. Enterprise-implementaties die een langdurig traject met professional services vereisen voordat ze live gaan, brengen aanzienlijke kosten en risico's met zich mee. Een overlay-architectuur die aansluit op bestaande helpdesks zonder datamigratie kan vaak binnen weken live. Vraag om concrete tijdlijnen van getekend contract tot de eerste live interacties.
De proof-of-concept-valkuil
POC's zijn vrijwel standaard bij enterprise AI-evaluaties, en ze leveren bijna altijd betere resultaten op dan productie-implementaties. Dat is geen toeval. POC's draaien op schone data, een beperkte reikwijdte aan vragen en ondersteuning van de leverancier. Ze zijn afgestemd op de evaluatie. Productie-implementaties draaien op het volledige spectrum aan klantvragen, gekoppeld aan systemen die nooit zijn ontworpen om met AI te werken, en worden beheerd door teams die ook ander werk hebben.
Om die kloof te dichten, moet je aandringen op POC-omstandigheden die echt op productie lijken. Draai de POC op live vragen van je eigen klanten, niet op een steekproef. Koppel hem aan systemen die gelijkwaardig zijn aan productie, niet aan een sandbox. Laat hem lang genoeg lopen om de prestaties te zien stabiliseren, niet alleen de eerste, bijgestelde periode. Vraag welk percentage van de vragen tijdens de POC binnen de vooraf geconfigureerde scope viel en welk percentage erbuiten. De meeste pilots die er in een demo goed uitzien, halen productie nooit, en de redenen zijn consistent genoeg om er rekening mee te houden; de analyse van de kloof tussen pilot en productie laat zien wat de twee van elkaar scheidt.
De leveranciers die bereid zijn een POC onder die omstandigheden te draaien, bouwen voor productie. Leveranciers die erop staan de omstandigheden strak te controleren, optimaliseren voor de POC zelf.
Hoe een grondige evaluatie er in de praktijk uitziet
De sterkste evaluaties komen van teams die leveranciersselectie behandelen als een technische beslissing, niet als een inkoopformaliteit. Toen Clio, het legal-techplatform, een verouderde, gescripte bot wilde vervangen, evalueerde het team 32 leveranciers en liet het er daarna meer dan 10 rechtstreeks tegen elkaar strijden voordat het voor Maven koos. Ze testten op hun echte eisen: nauwkeurige antwoorden op vragen via de in-app chat, diepe integratie met hun bestaande stack, waaronder Salesforce, en prestaties bij de randgevallen waarop gescripte systemen stuklopen.
Het resultaat hield stand in productie, niet alleen in een demo: 80% autonome resolutie, met 4x snellere live support voor de technische vragen die nog wel bij een mens terechtkomen. Die combinatie, hoge autonome resolutie samen met snellere afhandeling van de uitzonderingen, is het kenmerk van een evaluatie die op productie is getest in plaats van op een gepolijste eerste indruk. Het is ook wat de sterkste CX-teams gemeen hebben: ze richten de evaluatie zo in dat ze de zwakke plekken vinden vóór ze tekenen, niet erna.
Compliance is geen extraatje
Bij de meeste enterprise-implementaties loopt de weg van POC naar productie via je securityreview. Daar lopen veel evaluaties van AI-agents vast of mislukken ze volledig. De compliance-eisen voor een AI-agent die zelfstandig klantdata verwerkt, transacties afhandelt en acties uitvoert in productiesystemen zijn aanzienlijk, en de meeste organisaties zijn minder goed voorbereid dan ze denken. In een onderzoek van Grant Thornton uit 2026 gaf 78% van de leiders aan er niet zeker van te zijn dat ze binnen 90 dagen een AI-audit zouden doorstaan.
Beoordeel de compliancepositie vroeg, niet als laatste controlepunt. Concreet: of de leverancier beschikt over SOC 2 Type II, of er een HIPAA BAA beschikbaar is, of er GDPR-verwerkersovereenkomsten zijn en of er PCI DSS-compliance is voor workflows die met betalingen te maken hebben. Of er voor elke actie van de agent audittrails beschikbaar en doorzoekbaar zijn. Of de subverwerkers van de leverancier zijn beoordeeld en bekendgemaakt. Of het platform binnen jouw eisen voor dataresidentie kan werken.
Leveranciers met een echte enterprise-compliance-infrastructuur beantwoorden deze vragen met documentatie, niet met geruststellingen. Leveranciers die compliance zien als een vinkje in een laat stadium, zijn degenen die het vaakst zakken voor de securityreview nadat jij al in de evaluatie hebt geïnvesteerd.
Het referentiegesprek waar je om zou moeten vragen
De meeste referentiegesprekken van leveranciers zijn bedoeld om positieve ervaringen te bevestigen. Vraag in plaats daarvan om een gesprek met een klant die een moeizame implementatie had, een die flink wat troubleshooting vergde voordat hij goed presteerde. Hoe de leverancier met die implementatie omging, zegt je meer dan 3 soepele.
Vraag de referentie concreet wat er misging, hoe lang het duurde om het op te lossen en of ze de ondersteuning kregen die ze nodig hadden. De antwoorden bepalen of je 18 maanden na de start van een productie-implementatie nog met deze leverancier wilt samenwerken.
Voer de evaluatie uit die productie voorspelt
Elke leverancier komt door een demo. Veel minder komen door een evaluatie die laat zien wat er gebeurt bij echt volume, op echte systemen en onder een echte securityreview. Gebruik deze vragen als scorekaart, draai de POC op je lastigste vragen en laat productiereferenties zwaarder wegen dan analistenbadges. De teams die dit consequent doen, zijn de teams waarvan de implementaties een jaar later nog steeds presteren.
Bekijk hoe dit framework standhoudt bij jouw eigen ticketvolume. Plan een demo en neem de vragen mee waarvan je verwacht dat ze het systeem breken.
Zie het op je eigen gesprekken.
Vraag een gratis demo op maat aan.


