
De meeste AI-supportprojecten in grote organisaties mislukken niet in de ideefase. Ze stranden ergens tussen een geslaagde proof of concept en het moment waarop het systeem echt volume, echte data en echte gevolgen moet aankunnen.
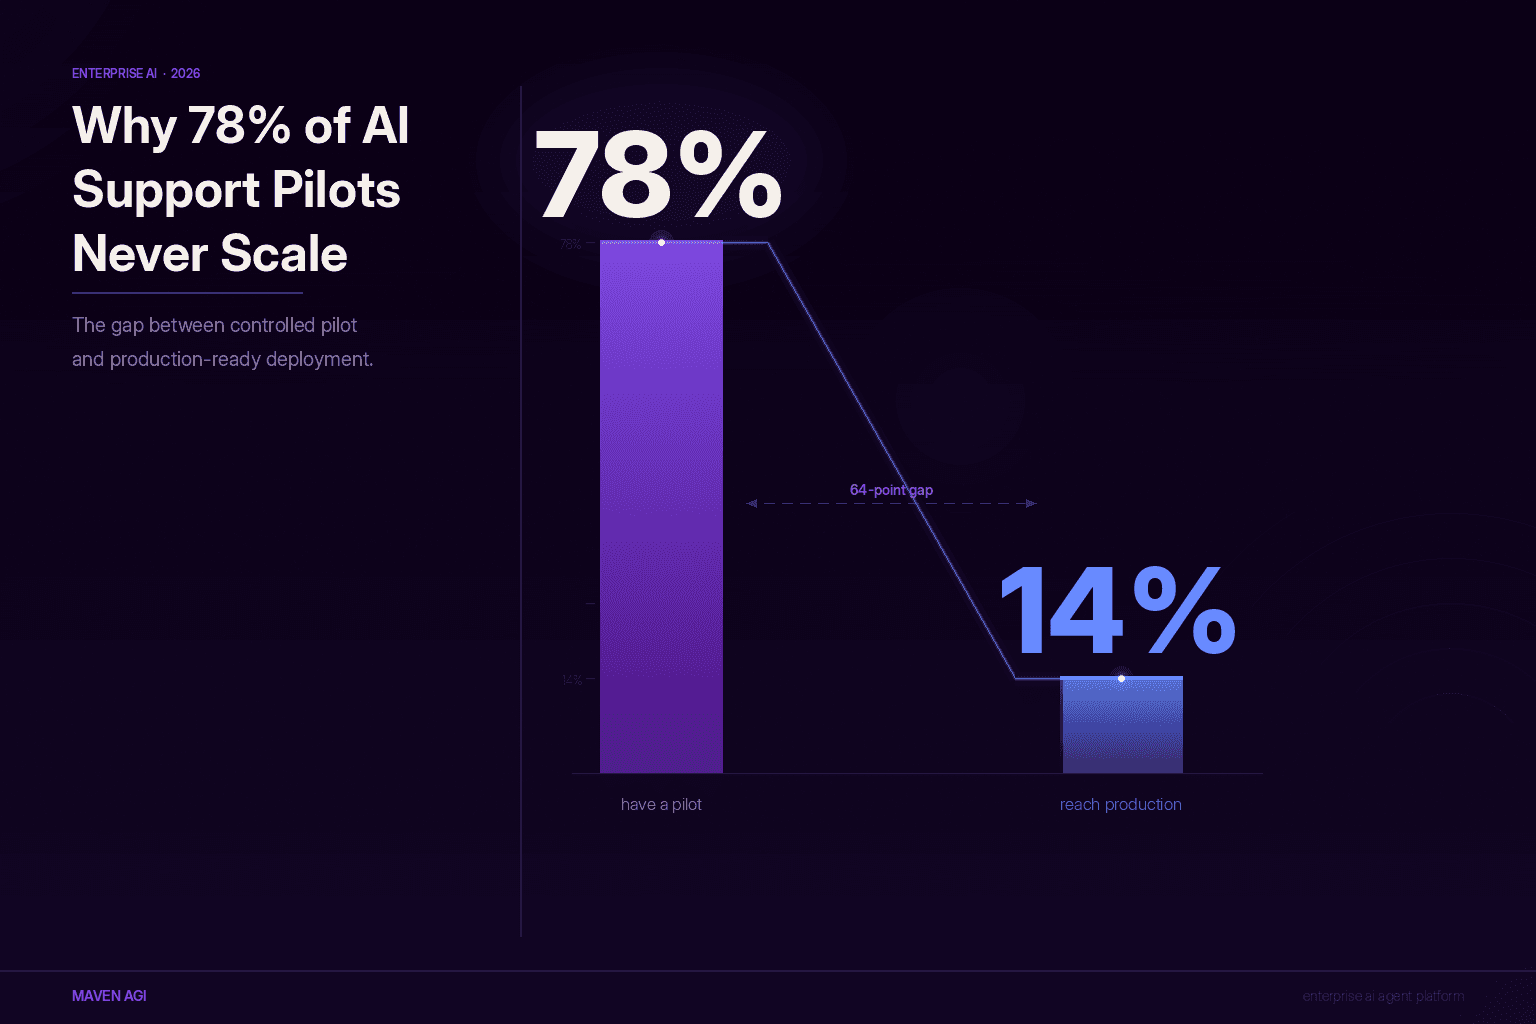
Een onderzoek uit maart 2026 onder 650 technologieleiders in grote organisaties zette een getal op die kloof: 78% van de grote organisaties heeft minstens 1 AI-agentpilot draaien in een gecontroleerde omgeving. Slechts 14% heeft een agent met succes opgeschaald naar organisatiebreed operationeel gebruik. In die kloof van 64 procentpunten tussen 'we hebben een pilot' en 'we hebben een uitrol' verdwijnen de meeste AI-budgetten stilletjes.
De oorzaak ligt meestal niet bij de AI zelf. De modellen zijn volwassen geworden. De tooling is beter. De kloof is organisatorisch en operationeel: de meeste organisaties bouwen hun pilots niet voor productie. Ze bouwen voor de demo.
Wat een demo test en wat productie vraagt
Een pilot draait onder gecontroleerde omstandigheden. De data is schoon, het volume is beheersbaar en de uitzonderingen hebben zich nog niet aangediend. Iemand in het team kijkt mee bij elke interactie. Als er iets misgaat, wordt het opgelost voordat het een patroon wordt.
Productie is anders. Die draait op volume, met data die vaak rommelig en onvolledig is, zonder vangnet per interactie. De uitzonderingen die in de pilot nooit voorkwamen, duiken ineens voortdurend op. Volgens een analyse van Gartner, besproken door CTO Magazine, wordt naar verwachting meer dan 40% van de agentic AI-projecten vóór eind 2027 stopgezet: niet omdat de technologie niet werkt, maar door 'onduidelijke bedrijfswaarde, oplopende kosten en ontoereikende risicobeheersing'. Dat zijn geen technologische mislukkingen. Het zijn mislukkingen in de architectuur van de uitrol.
Organisaties die met succes opschalen, hanteren een consistente implementatiearchitectuur, ook als hun use cases verschillen. Die architectuur ontdekken ze niet tijdens de pilot. Ze bouwen hem voordat de uitrol begint.
De 5 kloven achter de meeste mislukte opschalingen
Het onderzoek uit maart 2026 bracht 5 hoofdoorzaken aan het licht die samen goed zijn voor 89% van de mislukte opschalingen van AI-agents in grote organisaties:
- Complexe integratie met legacysystemen. Een AI-agent die een statische kennisbank raadpleegt, presteert in een demo redelijk goed. Een agent die in realtime moet redeneren over een CRM, een helpdesk, een orderbeheersysteem en een factuurplatform, en daar ook gegevens naar terugschrijft als hij iets oplost, is een heel ander verhaal. De meeste pilots testen het eerste. De meeste productie-eisen vragen het tweede.
- Wisselende outputkwaliteit bij volume. In een pilot blijft de kwaliteit vaak op peil dankzij toezicht. Als een mens elke interactie beoordeelt, worden problemen vroeg opgemerkt. Op schaal verdwijnt dat toezicht. Als de agent niet systematisch is geëvalueerd op het volledige spectrum aan input dat hij in productie tegenkomt, ook de ongebruikelijke, gaat de kwaliteit achteruit op manieren die onzichtbaar blijven tot klanten gaan klagen.
- Geen monitoringtooling. Wat je niet ziet, kun je niet verbeteren. Uitrollen die de prestaties van agents niet vanaf dag 1 meten, lopen doorgaans vast. De feedbackloop tussen agentoutput en workflowontwerp maakt het verschil tussen uitrollen die steeds meer waarde opleveren en uitrollen die stilvallen.
- Onduidelijk eigenaarschap binnen de organisatie. Iemand moet eigenaar zijn van de prestaties van elke agentic workflow: niet alleen van de technische werking, maar ook van de bedrijfsresultaten. Zonder duidelijk eigenaarschap vervaagt de verantwoordelijkheid. Problemen die in dagen opgelost zouden moeten zijn, duren weken. Voor de hand liggende verbeteringen worden nooit doorgevoerd.
- Onvoldoende domeinspecifieke trainingsdata. Bedrijfsdata is nooit één schone bron. Ze is verspreid over systemen, inconsistent van structuur en voortdurend in beweging. Zodra je van een gecontroleerde pilot naar productie gaat, wordt die versnippering groter. Agents die nauwkeurig redeneerden over een zorgvuldig samengestelde dataset, stuiten ineens op tegenstrijdige documenten, dubbele records en verouderd beleid.
Wat productierijp echt betekent voor CX
Specifiek voor klantenservice bleek uit de Infor Enterprise AI Adoption Impact Index, waarvoor begin 2026 1.000 zakelijke beslissers in de VS, het VK, Duitsland en Frankrijk werden ondervraagd, dat meer dan de helft van de bedrijven moeite heeft om AI verder op te schalen dan de eerste uitrol. De genoemde obstakels zijn geen tekortkomingen in capaciteit. Het zijn tekortkomingen in uitvoering.
Productierijp betekent dat het platform echt ticketvolume aankan zonder kwaliteitsverlies. Het betekent dat escalaties de volledige context doorgeven aan menselijke medewerkers, in plaats van de gespreksgeschiedenis kwijt te raken bij de overdracht. Het betekent dat de governance-infrastructuur, met audittrails, permissieniveaus en routering van uitzonderingen, vanaf het begin is ontworpen en niet achteraf is ingebouwd onder druk van een securityreview. En het betekent dat de integratielaag in twee richtingen verbonden is met de systemen waar het supportwerk echt gebeurt: de helpdesk, het CRM, het factuursysteem en de kennisbank.
Dit is goed om te weten als je aan het begin staat van een evaluatie van AI voor klantenservice. De vraag is niet alleen of het platform het supportvolume aankan. De echte vraag is of het is ontworpen om in productie te draaien of om een inkooptraject te winnen. Dat zijn verschillende ontwerpfilosofieën, en ze leveren verschillende systemen op.
De metrics die laten zien of je op koers ligt
Voordat een pilot overgaat naar een bredere uitrol, zijn er 3 metingen die teams op weg naar productie onderscheiden van teams die een permanente proof of concept bouwen.
De eerste is de autonome oplossingsgraad, niet de deflectiegraad. Deflectie telt contacten die de AI heeft doorgestuurd naar een mens. Oplossing telt contacten die de AI heeft afgehandeld. Een platform kan sterke deflectiecijfers laten zien terwijl de onderliggende oplossingsgraad zo laag is dat de business case de investering niet rechtvaardigt.
De tweede is het heropeningspercentage. Een contact dat door de AI is 'opgelost' en binnen 24 uur terugkomt als ticket voor een mens, is niet opgelost maar uitgesteld. De meeste platforms tonen deze metric niet standaard, waardoor teams het probleem vaak pas ontdekken als het zichtbaar wordt in klanttevredenheidsscores.
De derde is de prestatie bij het 90e percentiel van vraagcomplexiteit, niet de mediaan. Pilots worden meestal beoordeeld op gemiddelde prestaties. Productie-uitrollen staan of vallen met de uitzonderingen. Wie een platform alleen beoordeelt op de vragen die het goed afhandelt, eindigt met een uitrol die werkt voor 60% van de contacten en structureel faalt bij de andere 40%, meestal juist de belangrijkste.
Voor een uitgebreider evaluatiekader beschrijft het artikel over hoe je AI-agents evalueert voor klantenservice in grote organisaties de specifieke criteria die productiewaardige platforms onderscheiden van platforms die zijn geoptimaliseerd voor demo's.
Wat de 14% die wél opschaalt anders doet
De organisaties die met succes van pilot naar productie gaan, delen een paar vaste werkwijzen. Ze beginnen met datagereedheid voordat ze agents uitrollen: ze auditen de bronnen waarop de agent gaat steunen, zorgen voor schone integratielagen en controleren of de informatie die de agent raadpleegt actueel en volledig genoeg is voor betrouwbaar redeneren.
Ze bouwen audittrails en permissie-infrastructuur vóórdat ze de autonomie van agents uitbreiden, niet erna. Inkoopcommissies en juridische teams van grote organisaties eisen doorzoekbare registraties van elke actie van een agent. Uitrollen die die documentatie niet kunnen leveren, lopen vast bij de bredere uitrol. Het vanaf het begin inbouwen is veel eenvoudiger dan het achteraf toevoegen.
En ze kiezen een eerste workflow op basis van volume en meetbaarheid, niet op basis van wat het best demonstreert. Een supportworkflow met veel volume en een duidelijke afbakening, zoals wachtwoordresets, orderstatus of accountwijzigingen, geeft een agent genoeg input om kwaliteitsproblemen snel bloot te leggen en genoeg data om systematisch te verbeteren. Beginnen met een complexe workflow met weinig volume levert een uitrol op die wisselend presteert en lastig te beoordelen is.
De vraag rond een enterprise AI-agentplatform is niet of AI-agents klaar zijn voor support in grote organisaties. In 2026 is die capaciteit er. De vraag is of de uitrolarchitectuur, de integratiediepte, de governance-infrastructuur, de monitoringtooling en het eigenaarschap binnen de organisatie op hetzelfde niveau zijn gebracht als het model zelf.
De meeste pilots komen niet zo ver. De pilots die dat wel doen, worden meestal de productie-uitrollen die verlengd worden.
Zie het op je eigen gesprekken.
Vraag een gratis demo op maat aan.


