
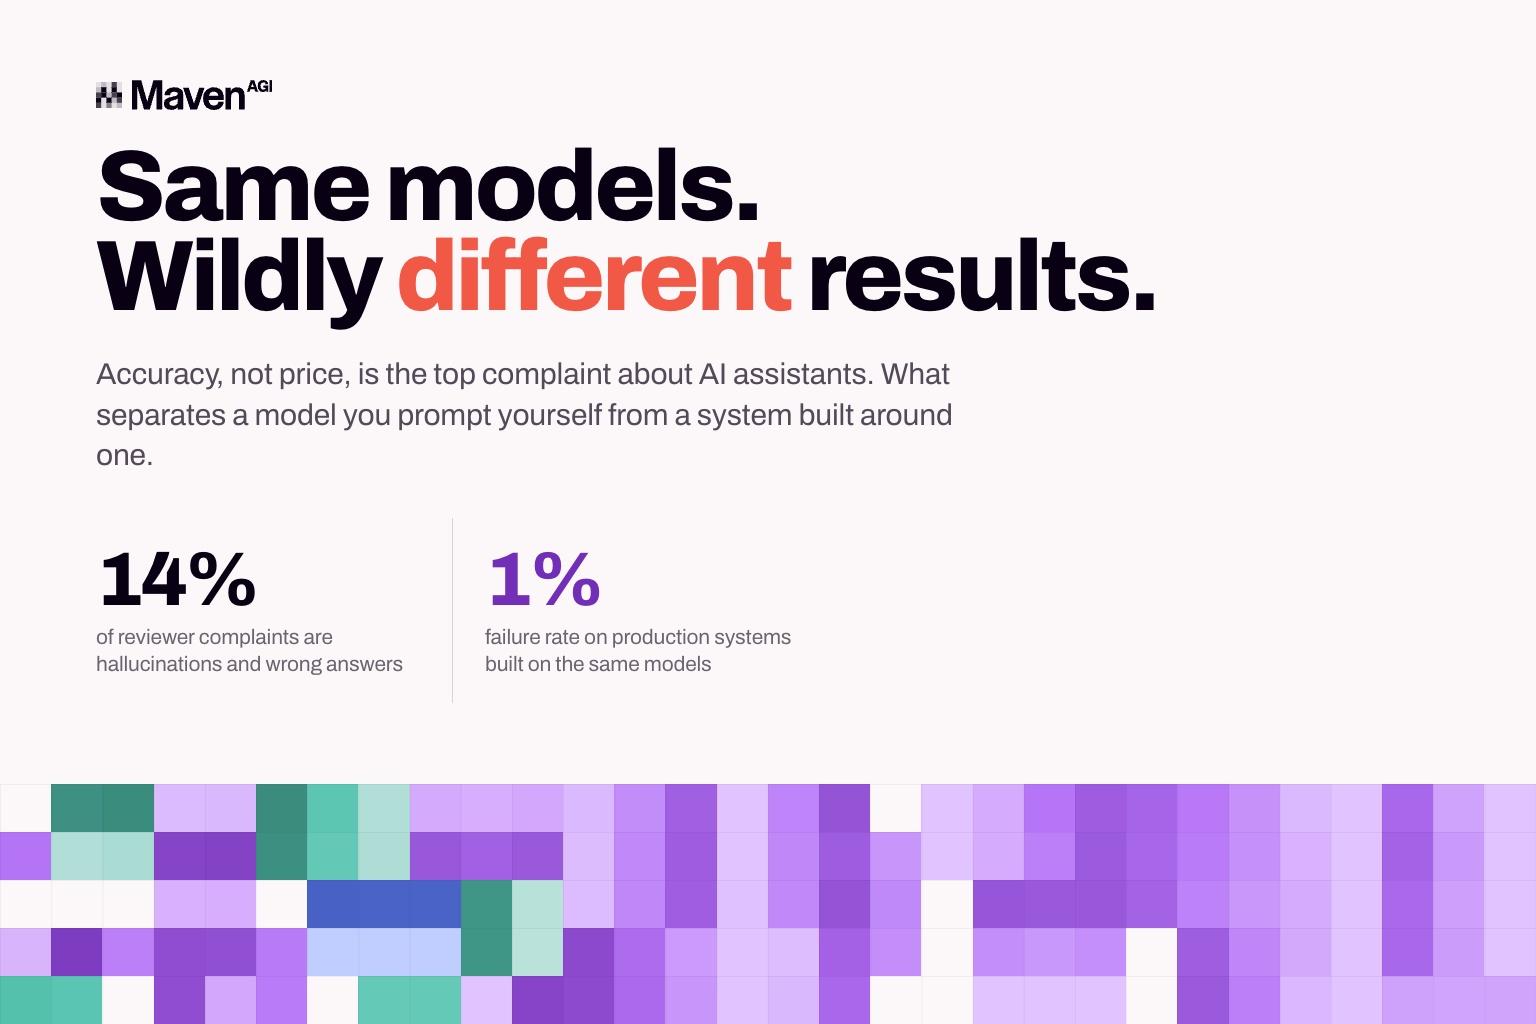
G2는 1월부터 7월 중순까지 검증된 리뷰 2,950건 이상을 분석해 사용자들이 가장 많이 제기하는 불만이 무엇인지 살펴봤습니다. 가장 큰 불만은 가격이 아니라 정확성이었습니다. 할루시네이션과 잘못된 답변이 리뷰어들이 꼽은 불만 사항 전체의 14%를 차지했습니다. 모두가 비용만 이야기하는 해에 비용보다 앞선 것입니다.
리뷰어가 누구인지 알아둘 필요가 있습니다. 그에 따라 이 숫자의 의미가 달라지기 때문입니다. 대부분은 누구나 브라우저 탭에 띄워 두고 쓰는 범용 어시스턴트에 대한 이야기입니다. 운영 환경의 지원 에이전트를 평가하는 CX 팀이 아닙니다. 모델에 질문하고, 확신에 찬 답을 받은 뒤, 그것이 사실인지 스스로 확인해야 하는 사람들입니다.
이어 G2는 같은 모델을 기반으로 운영 시스템을 구축하는 4개 벤더에게 실제 실패율이 어느 정도인지 물었습니다. 답은 최저 1%였습니다.
즉 실제로 비교되는 것은 모델과 모델이 아닙니다. 직접 프롬프트를 입력해 쓰는 모델과, 누군가 모델을 중심으로 구축한 시스템의 비교입니다. 기반 기술은 같지만 결과는 크게 다릅니다. Maven은 G2가 질문한 4개 벤더 중 하나였습니다.
격차의 원인
4개 벤더가 설명한 내용 중 어떤 모델을 골랐는지와 관련된 것은 하나도 없었습니다. 모두 거의 같은 이야기를 했습니다. 시스템이 한 번에 답하지 않고 단계별로 작동합니다. 답변은 모델이 학습 과정에서 기억한 내용이 아니라 실시간 데이터에서 가져옵니다. 작업이 실제로 완료되는 비율을 측정하고, 프롬프트와 로직을 최소 주 1회 수정합니다. 한 곳은 매일 수정합니다. 모두 모델 자체가 아니라 모델을 둘러싼 작업입니다.
더 유용한 공통점은 노력을 어디에 쏟는가입니다. 4개 벤더 모두 어려운 부분은 일상적인 질문이 아니라 예외 상황과 다단계 작업이라고 답했습니다. 그래서 감당하기 어려운 상황을 스스로 인식하고, 추측하는 대신 사람에게 대화를 넘기는 시스템을 만듭니다. Maven은 설문에서 “신뢰할 수 있는 폴백 로직 없는 자율성은 기능이 아니라 리스크”라고 답했습니다.
격차의 대부분은 바로 여기서 나옵니다. 모델에 직접 프롬프트를 입력하면 결과를 검증하는 사람은 자기 자신입니다. 운영 시스템은 그 일이 고객에게 넘어가지 않도록 설계됩니다. G2도 분명히 말했습니다. 이 벤더들은 실패를 덜 겪는 것이 아니라, 누군가 알아차리기 전에 실패를 잡아내고 있습니다.
에이전트 대 챗봇 논쟁은 대부분 용어의 문제
G2는 4개 벤더에게 AI 에이전트가 업계에서 여전히 챗봇이라 부르는 것보다 더 신뢰할 수 있는지 직접 물었습니다. 모두 비슷하게 답했고, 이 용어를 내세워 판매하는 쪽에는 반갑지 않은 소식입니다. 운영 환경에서 둘은 마케팅이 말하는 만큼 다르지 않으며, 이름만 바꾼다고 해결되는 것은 없습니다.
이는 벤더보다 구매자에게 더 중요합니다. “에이전트”라는 단어를 보고 구매한다면 역량이 아니라 이름표를 사는 셈입니다. 어떤 벤더는 제품을 에이전트라 부르고 다른 벤더는 다른 이름으로 부른다는 사실만으로는, 어느 쪽이 최신 지식을 조회하는지, 확신이 없을 때 이를 인식하는지, 출시 후 실제 대화를 기준으로 검증받는지 알 수 없습니다. 이는 고객 서비스 분야 에이전틱 AI가 갖춰야 할 특성이며, 어느 것도 이름표와 함께 따라오지 않습니다.
실제로 의미 있는 질문은 시스템이 어떻게 구축되었는지에 관한 것이며, 다음 5가지는 첫 미팅에서 모두 물어볼 수 있습니다.
- 답변은 어디에서 나오나요? 실시간 지식을 조회하나요, 아니면 모델이 학습한 내용에 의존하나요?
- 확신이 없을 때는 어떻게 하나요? 사람에게 넘기나요, 아니면 맞을 때와 똑같이 확신에 찬 어조로 추측하나요?
- 실제 대화를 기준으로 답변을 얼마나 자주 검토하며, 무엇을 측정하나요?
- 팀이 직접 에이전트의 동작을 변경할 수 있나요, 아니면 작은 수정도 매번 벤더를 거쳐야 하나요?
- 시스템 안에서 실제로 작업을 수행할 수 있나요, 아니면 고객에게 무엇을 해야 하는지 알려주기만 하나요?
5가지 질문에 모두 답할 수 있는 벤더라면 제대로 작업을 해둔 것입니다. 첫 번째 질문에는 확실히 답하지만 그 뒤로 모호해진다면, 모델을 사서 위젯을 씌웠을 뿐입니다. 더 자세한 목록은 엔터프라이즈 고객 서비스를 위한 AI 에이전트 평가 가이드에서 확인하실 수 있습니다.
구매자가 놓치는 부분
4개 벤더가 설명한 구조는 Maven의 5계층 아키텍처의 기반과 같습니다. 모델은 그중 한 계층일 뿐입니다. 신뢰성을 만드는 모든 요소는 그 주변에 있습니다. 에이전트가 무엇을 알고 있는지, 무엇을 할 수 있는지, 운영 중 작업을 어떻게 검증하는지, 그리고 누가 가드레일을 관리하는지입니다. 구매자는 보통 모델을 보고 고릅니다. 유명한 이름이 붙은 계층이기 때문입니다. 그러나 G2의 데이터가 가리키는 것은 모두 나머지 4개 계층에 있으며, 바로 이 때문에 자율 해결은 좋은 답변과는 다른 개념입니다.
같은 이유로, 업계의 통념과 달리 빠른 배포와 신뢰성은 상충하지 않습니다. 이 계층들을 구축하는 것은 상당한 엔지니어링 작업이지만, 플랫폼 안에서 한 번만 이루어지면 됩니다. 고객마다 각자의 스택 안에서 6개월짜리 프로젝트로 반복할 필요가 없습니다.
제대로 구축된 시스템의 모습
Mastermind는 6주 만에 자율 해결률 93%를 달성했습니다. K1x는 첫 주에 80%에 도달했습니다. Rho는 추가 채용 없이 월 문의량이 12% 늘어나는 동안에도 CSAT 95%를 유지했습니다. Quest는 Maven으로 AskQ를 구축해 데이터 마이그레이션 없이 기존 지식 베이스와 케이스 시스템에 연결했으며, 디플렉션이 아닌 고객 만족도로 성과를 평가합니다.
Maven의 리뷰도 같은 방향을 가리킵니다. 검증된 리뷰 20건 기준 5점 만점에 4.8점이며, 사용자들이 실제로 언급하는 내용을 살펴볼 만합니다. 별도의 봇을 각각 동기화할 필요 없이 하나의 엔진이 채팅, 이메일, 음성을 처리한다는 점, 처음 찾은 문서로 답하는 대신 오래되었거나 중복되거나 상충하는 문서를 표시하는 지식 검색, 그리고 Salesforce나 Zendesk 위에서 며칠 만에 끝나는 설정입니다. 모두 모델을 둘러싼 요소입니다.
8월 25일 발표된 G2 2026년 가을 보고서에서 Maven은 Customer Service Automation 부문 Mid-Market Grid, AI Customer Support Agents 부문 Mid-Market Results Index, AI Customer Support Agents 부문 Implementation Index에 이름을 올렸습니다. Index 보고서는 기업의 규모나 인지도가 아니라, 고객이 얻은 성과와 도입 과정에 대한 고객의 평가를 바탕으로 합니다. G2의 전체 데이터가 다른 곳에서 문제가 되고 있다고 지적하는 바로 그 부분을 측정하는 것입니다.
핵심은 격차입니다
주목해야 할 숫자는 14%와 1% 사이의 차이입니다. 둘 다 같은 소수의 모델을 기반으로 하기 때문입니다. 기술만으로는 이만큼 큰 격차를 설명할 수 없습니다. 격차를 만드는 것은 고객이 잘못된 답변을 보기 전에 이를 잡아내는 장치를 누군가 공들여 구축했는지 여부입니다. 그래서 해결률은 어떻게 측정했는지 알아야만 의미가 있습니다.
대부분의 구매자는 여전히 모델 이름을 비교하고 있습니다. G2가 인터뷰한 4개 벤더는 이미 오래전에 그 방식을 버렸습니다.
글로 읽는 대신 각 계층을 직접 확인하고 싶으시다면 데모를 예약하세요.
귀사의 실제 대화로 확인하세요.
맞춤형 무료 데모를 신청하세요.


