
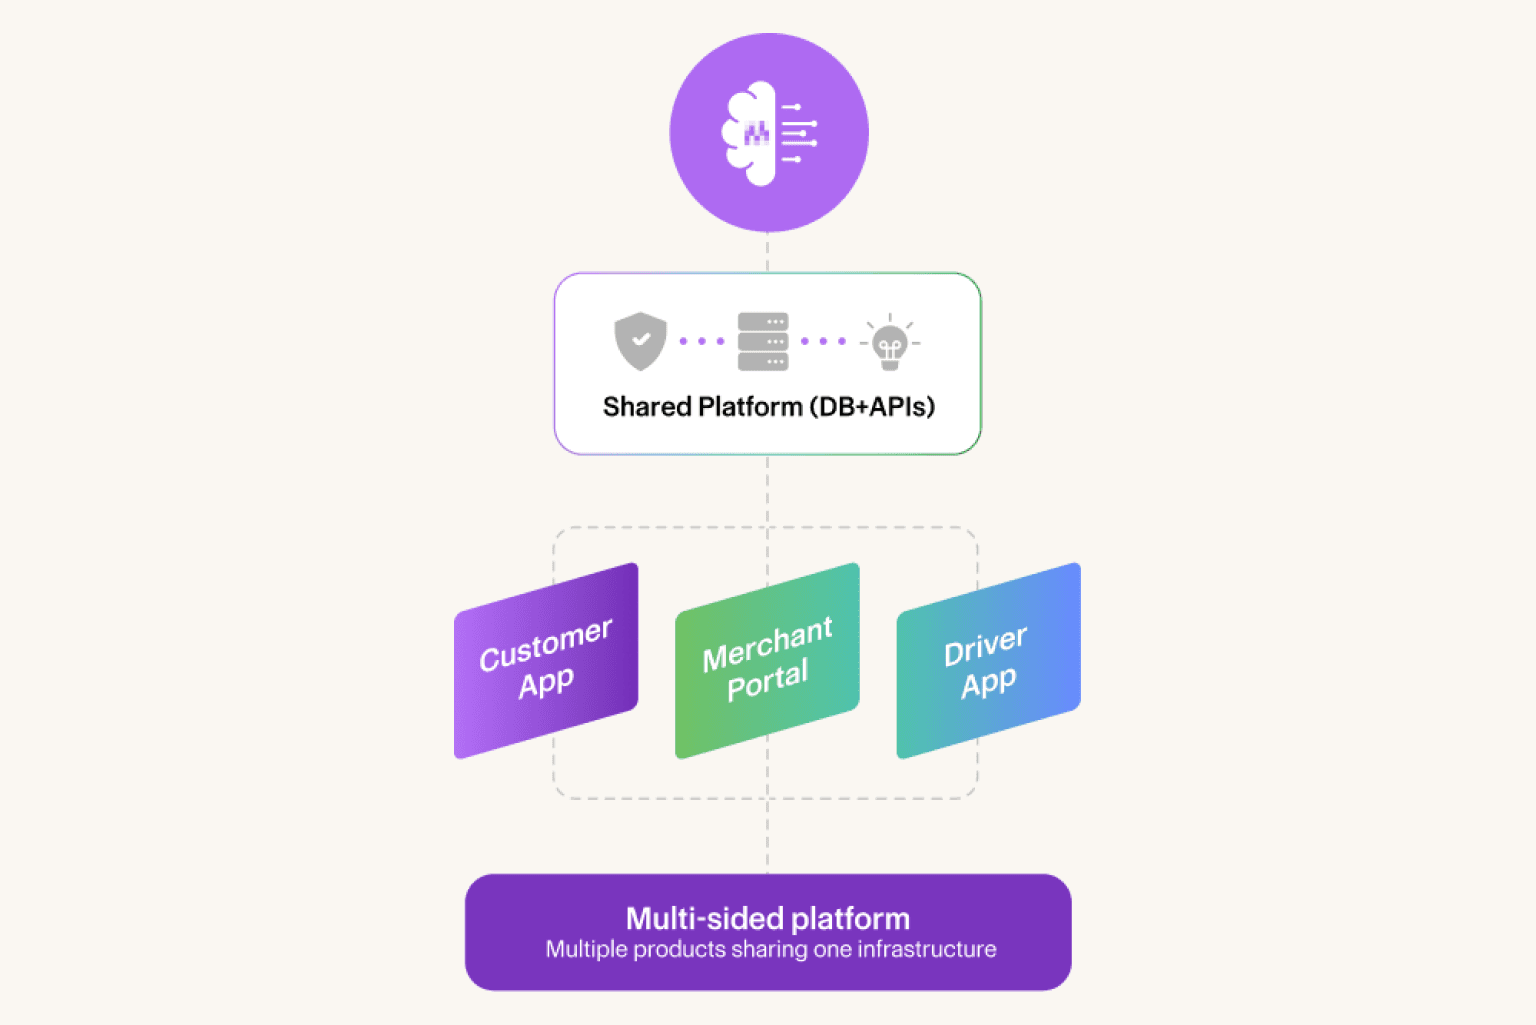
In das Design der meisten KI-Agenten ist eine Annahme eingebaut, die kaum hinterfragt wird: Wenn Daten für die Beantwortung einer Frage relevant sind, sollte der Agent sie auch nutzen dürfen.
Das klingt vernünftig, ist aber falsch.
Für Unternehmen, die Plattformen mit mehreren Teilnehmergruppen betreiben – Kunden und Händler, Fahrgäste und Fahrer, Auftraggeber und Dienstleister –, ist genau diese Annahme der Grund, warum KI-Deployments unbemerkt zu Vertrauensproblemen werden.
Die Relevanzfalle
Ein Kunde wendet sich wegen einer verspäteten Lieferung an den Support. Er möchte wissen, was passiert ist, und bittet um eine Rückerstattung.
Zu den relevantesten Informationen gehören die durchschnittlichen Zubereitungszeiten des Restaurants, das konkrete Zubereitungsfenster dieser Bestellung, der Routenverlauf des Fahrers und alle Auffälligkeiten, die während der Abwicklung markiert wurden. All das ist unmittelbar nützlich und führt zu einer besseren, präziseren Antwort.
Gleichzeitig würden dadurch operative Leistungsdaten des Restaurants einem Kunden angezeigt, der sie nichts angehen. Das Verhalten eines Fahrers würde ohne faires Verfahren belastet. Und es entstünde eine direkte Verbindung zwischen dem Ergebnis der einen Seite und den Daten der anderen – ohne Wissen oder Zustimmung einer der beiden Parteien.
Der Agent hat keinen Fehler gemacht – er hat genau das getan, wofür er entwickelt wurde: Relevantes finden und nutzen. Der Fehler lag in der Annahme, dass Relevanz und Berechtigung dasselbe sind.
Warum diese Unterscheidung schwieriger ist, als sie scheint
Bei einem Single-Sided-Produkt decken sich Relevanz und Berechtigung weitgehend. Wer die Frage stellt, ist auch die Person, um deren Daten es geht. Die Lücke zwischen Nützlichem und Erlaubtem ist so klein, dass die meisten Agenten sie ohne Zwischenfälle bewältigen.
Multi-Sided-Plattformen hebeln diese Annahme komplett aus.
Jede Teilnehmergruppe hat eigene Daten, Workflows, Erwartungen an den Datenschutz und Vorstellungen davon, was ein faires Ergebnis ist. Wenn ein KI-Agent über eine gemeinsame Wissensbasis für alle Gruppen arbeitet, bewegt er sich nicht in einer einzigen Datenumgebung, sondern in mehreren gleichzeitig – ohne feste Grenzen dazwischen.
3 Fehlermuster treten dabei immer wieder auf:
Datenabfluss zwischen Oberflächen. Informationen, die auf einer Oberfläche relevant sind, gehören einem Teilnehmer auf einer anderen. Ein Kunden-Agent, der den Streitfallverlauf eines Händlers einsehen kann, ein Händlerportal, das Details zu Kundenbeschwerden anzeigt, oder eine Fahrer-Oberfläche, die auf plattformweite Sanktionsdaten verweist.
Aktionen mit ungeprüften Folgen an anderer Stelle. Eine Rückerstattung auf der Kundenseite löst einen Abzug bei der Auszahlung auf der Händlerseite aus. Ein KI-Agent, der die erste Aktion ausführen kann, die zweite Konsequenz aber nicht sieht, trifft plausibel klingende Entscheidungen, die Probleme verursachen, mit denen er nie konfrontiert wird. Der Feedback-Loop schließt sich nicht.
Ungleiche Behandlung je nach Teilnehmergruppe. Dieselbe Frage – Warum wurde meine Zahlung gekürzt? – bedeutet etwas grundlegend anderes, je nachdem, ob ein Händler oder ein Fahrer sie stellt. Die zulässigen Daten, die angemessene Antwort und die erlaubten Aktionen unterscheiden sich jeweils. Ein Agent ohne feste Grenzen zwischen den Oberflächen liefert Antworten, die technisch korrekt, aber im Kontext falsch sind.
Nichts davon ist die Schuld des KI-Agenten – es sind Fehler in der Architektur. Dem Agenten wurde nie gesagt, wo die Grenzen verlaufen.
Relevanz ist ein Ausgangspunkt, keine Autorisierung
Der entscheidende Perspektivwechsel: Relevanz sollte bestimmen, wonach der Agent sucht – Berechtigung sollte bestimmen, worauf er tatsächlich zugreifen kann.
2 separate Fragen, nacheinander beantwortet.
Die Berechtigung kommt zuerst. Bevor ein Agent irgendetwas abruft, muss die Plattform bereits geklärt haben: Von welcher Oberfläche kommt diese Interaktion? Welche Teilnehmergruppe ist authentifiziert? Welche Daten und Aktionen sind für diese Oberfläche, diese Rolle und diesen Richtlinienkontext freigegeben? Was ist grundsätzlich tabu, egal wie relevant es sein mag?
Das sind keine Fragen, die das Modell selbst durchdenken sollte. Es sind Vorgaben, die die Plattform deterministisch durchsetzt, bevor der Agent startet. Relevanz wirkt dann innerhalb dieser Vorgaben – nicht an ihrer Stelle.
Der praktische Effekt ist erheblich. Ein Agent, der auf die Kundenoberfläche beschränkt ist, kann nicht versehentlich Händlerdaten offenlegen. Nicht, weil man es ihm untersagt hat, sondern weil diese Daten von vornherein nicht zugänglich waren. Prompt-Anweisungen lassen sich umgehen. Berechtigungsgrenzen nicht.
Dieser Unterschied wiegt schwerer, als es zunächst scheint. „Sollte nicht nutzen“ und „kann nicht zugreifen“ sind nicht dasselbe Schutzniveau. Bei hohem Volumen, in komplexen Umgebungen und mit echten Edge Cases hält nur Letzteres stand.
Was das in der Praxis bedeutet
Plattformen, die das richtig machen, bauen keine restriktiveren Agenten – sie bauen besser strukturierte. Die Denkfähigkeit des Agenten bleibt unverändert; was sich ändert, ist die Grundlage, auf der er arbeitet.
Das Ergebnis ist kein weniger leistungsfähiger Agent, sondern einer, dem alle Teilnehmergruppen gleichzeitig vertrauen können. Auf Multi-Sided-Plattformen ist genau das die Fähigkeit, die skaliert.
Relevanz führt Sie zu einer guten Antwort. Berechtigung führt Sie zu einer vertrauenswürdigen.
Testen Sie es mit Ihren eigenen Konversationen.
Fordern Sie eine kostenlose, individuelle Demo an.


