
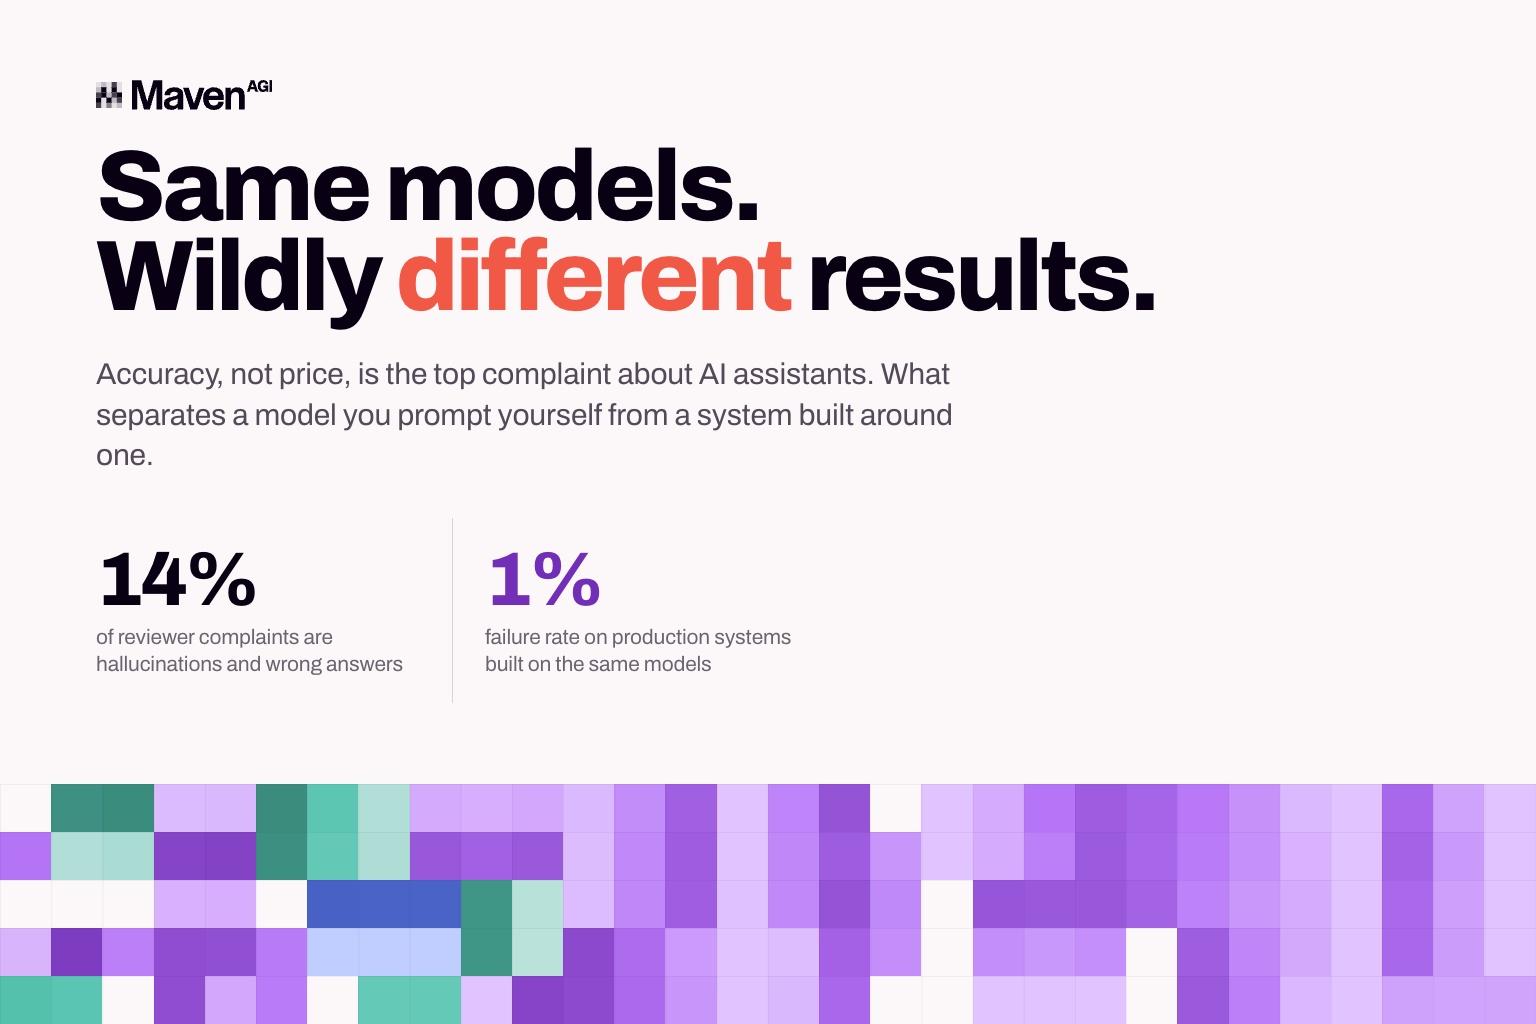
G2 läste igenom mer än 2 950 verifierade recensioner från januari till mitten av juli och undersökte vad användarna klagar mest på. Det största klagomålet gällde träffsäkerheten, inte priset. Hallucinationer och felaktiga svar stod för 14 % av allt som recensenterna ogillade. Det placerade problemet före kostnaden, ett år då kostnaden är det enda alla vill diskutera.
Det är värt att veta vilka recensenterna är, eftersom det ändrar vad siffran betyder. De flesta pratar om de allmänna assistenter som alla har öppna i en webbläsarflik. Det är inte CX-team som beskriver en supportagent i produktion. Det är personer som frågar en modell något, får ett självsäkert svar tillbaka och sedan själva måste lista ut om det stämmer.
Sedan vände sig G2 till fyra leverantörer som bygger produktionssystem på samma modeller och frågade hur stor andel fel de faktiskt har. Så lite som 1 %.
Det som jämförs är alltså inte en modell mot en annan. Det är en modell du promptar själv mot ett system som någon har byggt runt en modell. Samma teknik i grunden, helt olika resultat. Maven var en av de fyra leverantörer som G2 tillfrågade.
Vad som ligger bakom skillnaden
Inget av det de fyra beskrev hade att göra med vilken modell de valt. Alla sa ungefär samma sak. Deras system arbetar i steg i stället för i ett enda svep. Svaren hämtas från aktuell data i stället för från det modellen råkar minnas från träningen. De mäter hur ofta en uppgift faktiskt slutförs, och de skriver om promptar och logik minst en gång i veckan. En av dem gör det dagligen. Allt det arbetet sker runt modellen, inte i den.
Det mer användbara de var överens om är var insatsen läggs. Alla fyra sa att det svåra inte är vardagsfrågan utan specialfallen och uppgifterna i flera steg. Därför bygger de system som märker när de är utanför sin kompetens och lämnar över samtalet till en människa i stället för att gissa. Mavens formulering i undersökningen var att ”autonomi utan pålitlig fallback-logik är ingen funktion, det är en risk.”
Där har du det mesta av skillnaden. När du promptar en modell själv är det du som kontrollerar dess arbete. Ett produktionssystem är byggt så att den uppgiften aldrig hamnar hos kunden. G2 sa det rakt ut: de här leverantörerna har inte färre fel, de fångar upp dem innan någon märker något.
Debatten om agent kontra chattbot handlar mest om ord
G2 frågade sina fyra leverantörer rakt ut om AI-agenter är mer tillförlitliga än det som kategorin fortfarande kallar chattbotar. Alla svarade ungefär likadant, och det är inga goda nyheter för den som säljer på ordet. I produktion skiljer sig de två inte alls så mycket som marknadsföringen antyder, och att byta den ena etiketten mot den andra löser ingenting i sig.
Det spelar större roll för köpare än för leverantörer. Om du letar efter ordet ”agent” köper du en etikett snarare än en förmåga. Att en leverantör kallar sin produkt för agent och en annan kallar den något annat säger ingenting om huruvida någon av dem slår upp information i din aktuella kunskapsbas, märker när den är osäker eller kontrolleras mot verkliga samtal efter lanseringen. Det är egenskaper hos agentisk AI i kundservice, och ingen av dem följer med etiketten.
De frågor som faktiskt säger något handlar om hur lösningen är byggd, och du kan ställa alla fem under ett första samtal.
- Var kommer svaren ifrån? Slår den upp information i din aktuella kunskapsbas, eller utgår den från det modellen lärde sig under träningen?
- Vad händer när den är osäker? Lämnar den över, eller gissar den med samma självsäkra ton som när den har rätt?
- Hur ofta kontrollerar någon dess svar mot verkliga samtal, och vad mäter de?
- Kan ditt team ändra hur agenten beter sig, eller måste varje justering gå via leverantören?
- Kan den faktiskt utföra något i dina system, eller kan den bara tala om för kunden vad hen ska göra?
Om en leverantör kan besvara alla fem har någon gjort jobbet. Om de klarar den första men blir vaga efter det har de köpt en modell och lagt en widget runt den. Det finns en längre version av listan i vår guide om att utvärdera AI-agenter för kundservice i storföretag.
Delarna köparna hoppar över
Det de fyra leverantörerna beskrev är samma stack som Mavens arkitektur i fem lager bygger på. Modellen är ett lager. Allt som gör den tillförlitlig finns runt den: vad agenten vet, vad den får göra, hur du kontrollerar dess arbete när den är i drift och vem som ansvarar för skyddsräckena. Köpare väljer oftast utifrån modellen, eftersom det är det lagret som har de kända namnen. Allt som G2:s data pekar på finns i de andra fyra, och det är därför autonom lösning är något annat än ett bra svar.
Det är också därför snabb driftsättning och tillförlitlighet inte står i motsats till varandra, vad kategorin än antar. Att bygga de lagren är riktig ingenjörskonst, men det görs en gång, inne i plattformen, i stället för att bli ett sexmånadersprojekt i varje kunds stack.
Så ser det ut när jobbet är gjort
Mastermind nådde 93 % autonom lösning på sex veckor. K1x nådde 80 % redan första veckan. Rho behöll 95 % CSAT samtidigt som de hanterade 12 % fler kontakter per månad utan att anställa någon. Quest byggde AskQ på Maven, kopplade det till en befintlig kunskapsbas och ett befintligt ärendesystem utan datamigrering, och utvärderar det utifrån kundnöjdhet snarare än avledning.
Mavens egna recensioner pekar åt samma håll. 4,8 av 5 baserat på 20 verifierade recensioner, och det är värt att läsa vad folk faktiskt tar upp: en motor som hanterar chatt, e-post och röst i stället för separata botar som måste hållas synkade; kunskapshämtning som flaggar inaktuella, dubblerade och motstridiga artiklar i stället för att svara utifrån den första den hittar; en uppsättning som tar dagar ovanpå Salesforce eller Zendesk. Allt det är det som finns runt modellen.
I G2:s Fall 2026-rapporter, som publicerades den 25 augusti, placerade sig Maven i Mid-Market Grid for Customer Service Automation, Mid-Market Results Index for AI Customer Support Agents och Implementation Index for AI Customer Support Agents. Indexrapporterna bygger på vad kunderna säger om resultaten de fick och hur införandet gick, inte på hur stort eller känt ett företag är. De mäter just det som G2:s bredare data visar går fel överallt annars.
Skillnaden är själva poängen
Siffran att lägga märke till är avståndet mellan 14 % och 1 %, eftersom båda bygger på samma fåtal modeller. Inget i tekniken förklarar en så stor skillnad. Det som förklarar den är om någon har brytt sig om att bygga de delar som fångar upp ett dåligt svar innan kunden ser det. Därför betyder en lösningsgrad något först när du vet hur den har mätts.
De flesta köpare jämför fortfarande modellnamn. De fyra leverantörer som G2 pratade med slutade med det för länge sedan.
Om du vill se lagren i stället för att läsa om dem kan du boka en demo.
Se det på dina egna konversationer.
Begär en kostnadsfri, personlig demo.


