
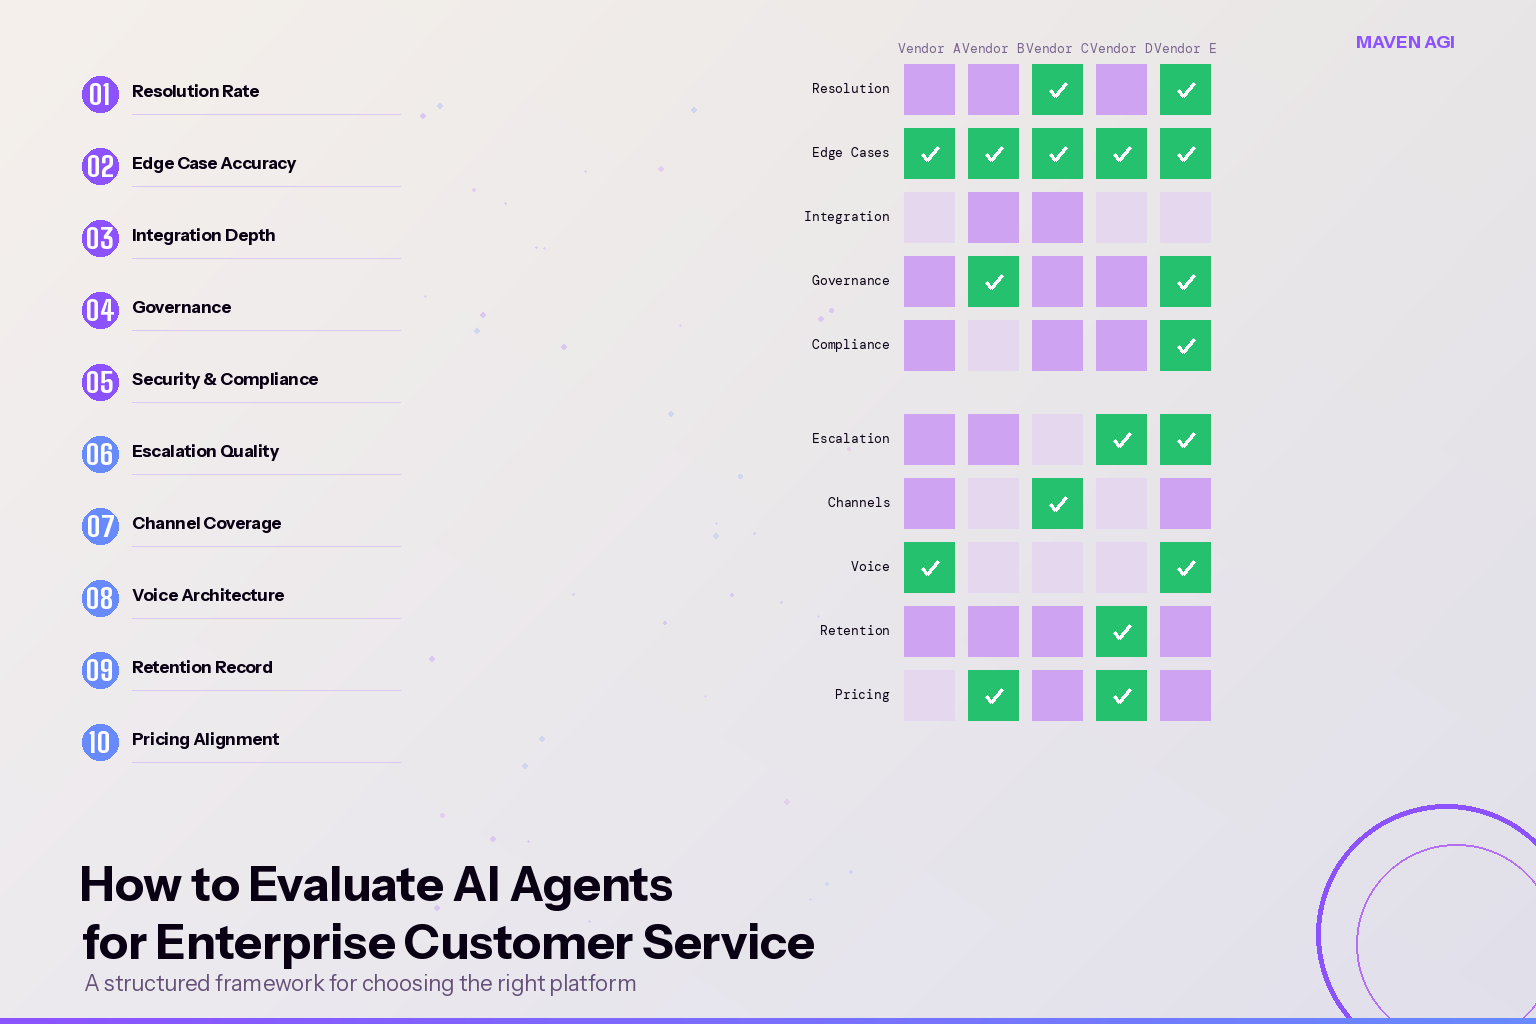
Marknaden för AI-agenter i företagsklass har mognat så pass att det inte råder någon brist på leverantörer som utlovar starka resultat. Proof of concept-miljöer levererar regelbundet de imponerande siffrorna, 80 % eller 90 % automatiseringsgrad, men driftsättningar som håller de resultaten i produktion är betydligt ovanligare. Gapet är förutsägbart om du vet vad du ska leta efter, och nästan osynligt om du gör en standardutvärdering.
Skillnaden mellan de team som lyckas och alla andra är inte demon. Det är om de stresstestade plattformen på de variabler som avgör prestandan i produktion. Den här guiden är ett praktiskt svar på hur du utvärderar AI-plattformar för kundtjänst utan att luras av ett polerat första intryck, och hur du väljer den bästa plattformen för en företagsdriftsättning som måste klara verklig volym. Den bygger på de frågor som skiljer plattformar byggda för produktion från plattformar byggda för att se bra ut i en demo. Om det hjälper att utgå från de kundtjänst-användningsfall du faktiskt har, börja där och arbeta dig bakåt till kriterierna.
Börja med att förstå vad du faktiskt utvärderar
De flesta leverantörsutvärderingar börjar med en demoförfrågan och slutar med ett referenssamtal. Den processen utformades för mjukvara som gör det den är konfigurerad att göra. AI-agenter är annorlunda: hur de presterar i en kontrollerad demonstration säger ofta lite om hur de presterar i produktion. De variabler som betyder mest i produktion – fördelningen av frågor, hur ofta specialfall uppstår, integrationernas tillförlitlighet och beteendet under belastning – är exakt de variabler som demos är upplagda för att undvika.
Innan du genomför någon utvärdering är det värt att reda ut 3 saker.
Vad betyder lösning för ditt användningsfall? Inte avledning, inte containment. Autonom lösning betyder att kundens problem löstes, att kunden inte återkom om samma sak och att AI:n vidtog åtgärden utan att en människa behövde slutföra den. Om du inte kan definiera detta specifikt för din produkt innan utvärderingen börjar blir alla benchmarks som leverantören visar svåra att tolka.
Hur ser ett misslyckande ut? En AI-agent som hanterar 80 % av interaktionerna väl men misshanterar de övriga 20 % på sätt som skadar förtroendet är ingen framgångsrik driftsättning. När du känner till dina felscenarier – felaktiga återbetalningar, felaktiga kontoändringar, eskaleringar där kontext går förlorad – kan du bygga in dem i utvärderingen i stället för att upptäcka dem efter lansering.
Hur ser din integrationsverklighet ut? Prestandagapet mellan sandlåda och produktion kan nästan alltid härledas till integrationen. En agent som utvärderas på ett urval av din kunskapsbas beter sig annorlunda än en som är kopplad till ditt live-CRM, ditt ärendesystem och din faktureringsplattform. Ju tidigare du kan testa med riktig systemåtkomst, desto mer förutsägbara blir resultaten.
Frågorna som avslöjar verklig produktionsförmåga
Standardutvärderingar av leverantörer kretsar ofta kring funktioner och pris. De här frågorna är utformade för att avslöja något mer specifikt: om plattformen är byggd för hur kundtjänst i stora företag faktiskt fungerar.
Hur definierar ni autonom lösning, och hur mäter ni den? Svaret säger mer än någon benchmark. Leverantörer med verklig produktionserfarenhet har specifika definitioner och specifika mätmetoder. De skiljer mellan ärenden som stängts av AI:n, ärenden som avletts till självbetjäning och ärenden som nått en människa. Leverantörer som optimerar för demoprestanda tenderar att blanda ihop dessa. Be dem gå igenom hur ett löst ärende klassificeras jämfört med ett avlett i deras system.
Hur stor är er återkontaktfrekvens inom 72 timmar? Det här är måttet som avslöjar falska lösningar. Om en betydande andel av de interaktioner som markerats som lösta leder till att samma kund kontaktar supporten igen inom 3 dagar, är den faktiska lösningsgraden lägre än rubriksiffran. Det är samma skillnad som skiljer avledning från lösning. Produktionsfokuserade leverantörer följer upp det. De som inte gör det mäter fel sak.
Kan agenten utföra åtgärder i mina backend-system, eller kan den bara visa information? Läsåtkomst kontra läs- och skrivåtkomst är den arkitektoniska skiljelinjen. En agent som kan berätta för en kund att ordern är försenad men inte kan boka om leveransen löser inte problemet – den besvarar en fråga. För de flesta kundtjänstscenarier i stora företag kräver verklig lösning skrivåtkomst till minst 2 eller 3 backend-system. Fråga vilka integrationer som finns som färdiga kopplingar och vilka som kräver egenutveckling.
Hur fungerar eskalering, och vad händer med kontexten? Eskaleringsögonblicket är där de flesta AI-driftsättningar skapar friktion i stället för att ta bort den. När agenten lämnar över till en människa – får medarbetaren en sammanfattning av konversationen och kundens kontohistorik, eller måste kunden börja om? Testa detta specifikt under utvärderingen. Det är den interaktion som oftast leder till klagomål, och den som oftast glöms bort i demos.
Vad gör agenten när den inte vet svaret? Att misslyckas på ett kontrollerat sätt är lika viktigt som att prestera bra. Se hur systemet hanterar frågor utanför sin träning, tvetydiga förfrågningar och avsiktliga försök att framkalla dåliga svar. Leverantörer som är trygga i hur de hanterar sådana fall låter dig testa dem under utvärderingen. De som styr bort från dessa tester har oftast en anledning.
Hur lång tid tar integrationen? Om det ärliga svaret är månader är det värdefull information. Företagsdriftsättningar som kräver omfattande konsultinsatser innan de kan gå live innebär betydande kostnader och risker. En overlay-arkitektur som ansluter till befintliga helpdesksystem utan datamigrering kan ofta gå live på några veckor. Be om konkreta tidslinjer från signerat avtal till de första live-interaktionerna.
POC-fällan
POC:er förekommer i nästan alla AI-utvärderingar i stora företag, och de ger nästan alltid bättre resultat än driftsättningar i produktion. Det är ingen slump. POC:er körs på ren data, ett begränsat urval av frågor och med stöd från leverantören. De är finjusterade för utvärderingen. Produktionsdriftsättningar hanterar hela bredden av kundfrågor, är kopplade till system som aldrig utformats för att fungera med AI och förvaltas av team som har andra arbetsuppgifter.
För att sluta det gapet bör du kräva POC-villkor som faktiskt liknar produktion. Kör den på live-frågor från din faktiska kundbas, inte ett urval. Koppla den till produktionslika system, inte en sandlåda. Kör den tillräckligt länge för att se prestandan stabiliseras, inte bara under det inledande, finjusterade fönstret. Fråga hur stor andel av frågorna under POC:n som låg inom det förkonfigurerade omfånget jämfört med utanför. De flesta piloter som ser bra ut i en demo når aldrig produktion, och orsakerna är tillräckligt konsekventa för att planera efter. Genomgången av gapet mellan pilot och produktion visar vad som skiljer de två åt.
De leverantörer som är villiga att köra en POC under sådana villkor är de som bygger för produktion. De som insisterar på att noggrant styra villkoren optimerar för själva POC:n.
Hur en rigorös utvärdering ser ut i praktiken
De starkaste utvärderingarna kommer från team som behandlar leverantörsvalet som ett tekniskt beslut, inte en upphandlingsformalitet. När Clio, plattformen för juridisk teknik, skulle ersätta en äldre skriptbaserad bot utvärderade teamet 32 leverantörer och lät sedan fler än 10 tävla mot varandra innan de valde Maven. De testade mot sina verkliga krav: korrekta svar på chattfrågor i appen, djup integration med deras befintliga stack inklusive Salesforce och prestanda i de specialfall som får skriptbaserade system att fallera.
Resultatet höll i produktion, inte bara i en demo: 80 % autonom lösning och 4 gånger snabbare livesupport för de tekniska frågor som fortfarande når en människa. Den kombinationen – hög autonom lösningsgrad i kombination med snabbare hantering av undantagen – är kännetecknet för en utvärdering som testats för produktion snarare än för ett polerat första intryck. Det är också vad de starkaste CX-teamen har gemensamt. De utformar utvärderingen för att hitta svagheterna innan avtalet skrivs, inte efteråt.
Regelefterlevnad är inget tillval
För de flesta företagsdriftsättningar går vägen från POC till produktion via din säkerhetsgranskning. Det är här många utvärderingar av AI-agenter stannar av eller faller helt. Kraven på regelefterlevnad för en AI-agent som självständigt hanterar kunddata, genomför transaktioner och utför åtgärder i produktionssystem är omfattande, och de flesta organisationer är inte så förberedda som de tror. I en undersökning från Grant Thornton 2026 uppgav 78 % av cheferna att de inte är säkra på att de skulle klara en AI-revision inom 90 dagar.
Utvärdera regelefterlevnaden tidigt, inte som en sista kontrollpunkt. Konkret: om leverantören har SOC 2 Type II, om HIPAA BAA finns tillgängligt, om det finns personuppgiftsbiträdesavtal enligt GDPR och PCI DSS-efterlevnad för betalningsnära arbetsflöden. Om revisionsloggar finns och är sökbara för varje åtgärd agenten utför. Om leverantörens underbiträden har utvärderats och redovisats. Om plattformen kan uppfylla dina krav på datalagringsplats.
Leverantörer med verklig infrastruktur för regelefterlevnad i företagsklass svarar på dessa frågor med dokumentation, inte försäkringar. De som ser regelefterlevnad som en bock i kanten sent i processen är de som mest sannolikt fäller säkerhetsgranskningen efter att du redan har investerat i utvärderingen.
Referenssamtalet du borde be om
De flesta referenssamtal är upplagda för att bekräfta positiva erfarenheter. Be i stället om ett referenssamtal med en kund som hade en svår driftsättning, en som krävde omfattande felsökning innan den fungerade väl. Hur leverantören hanterade den driftsättningen säger mer än 3 smidiga.
Fråga specifikt referensen vad som gick fel, hur lång tid det tog att lösa och om de fick det stöd de behövde. Svaren avgör om du kommer att vilja arbeta med den här leverantören 18 månader in i en produktionsdriftsättning.
Gör den utvärdering som förutsäger produktion
Varje leverantör klarar en demo. Betydligt färre klarar en utvärdering som är utformad för att avslöja vad som händer vid verklig volym, i verkliga system och under en verklig säkerhetsgranskning. Använd de här frågorna som bedömningsmall, kör POC:n på dina svåraste frågor och väg produktionsreferenser tyngre än analytikerutmärkelser. De team som konsekvent gör detta är de vars driftsättningar fortfarande levererar ett år senare.
Se hur ramverket står sig mot din egen ärendevolym. Boka en demo och ta med de frågor du tror kommer att få det att fallera.
Se det på dina egna konversationer.
Begär en kostnadsfri, personlig demo.


