

I dag lanserar vi Intelligent Fields, Maven AGI:s lösning för att fånga och organisera den data som uppstår i varje kundinteraktion – data som kan driva affärsbeslut, merförsäljning, produktförbättringar och andra strategiskt viktiga områden i din organisation.
Din AI-agent läser redan varje konversation. Den löser ärenden, besvarar frågor och hanterar volymen. Men när konversationen är slut försvinner allt den lärt sig. Ingen anteckning om varför kunden var frustrerad. Ingen flagga om att kunden nämnde att hen funderar på att lämna. Ingen signal om att samma problem har dykt upp 11 gånger den här veckan.
Transkriptionen finns. Datan gör det inte.
Den vanliga lösningen är manuell taggning: anpassade fält i helpdesken som agenterna fyller i. Det fungerar tills volymen ökar kraftigt, nya agenter börjar eller kategoriseringen glider isär. Då sjunker efterlevnaden och datan blir opålitlig.
Här är varför manuell taggning, den lösning de flesta team landar i, inte faktiskt löser problemet.
Fällan med manuell taggning
Manuell taggning har en avgörande brist: den förutsätter att människor gör det konsekvent i stor skala. Det gör de inte. Volymen ökar, nya agenter börjar, specialfall hoppas över. Efterlevnaden sjunker och datan blir i det tysta opålitlig, ofta utan att någon märker det förrän rapporterna ser konstiga ut.
Men även perfekt taggning slår i ett tak. Rullgardinsmenyer fångar kategorier. De fångar inte kontext. Skillnaden mellan en frustrerad kund och en kund som är på väg att lämna är ingen tagg. Det är 4 meningar begravda mitt i en transkription.
Vad som faktiskt behöver hända
Strukturerad konversationsdata måste extraheras automatiskt, ur hela transkriptionen, med något som förstår språk – inte matchar nyckelord.
Det är precis vad Intelligent Fields gör.
Du definierar ett fält: ett namn, en typ (text, ja/nej, val, nummer eller flerval) och instruktioner i vanligt språk som beskriver vad fältet ska fånga. Maven-agenten utvärderar fältet i varje konversation, automatiskt. Resultatet sparas, blir sökbart och kopplas till konversationen, tillsammans med en konfidenspoäng och en motivering till klassificeringen.
Ett konkret exempel: churnrisk
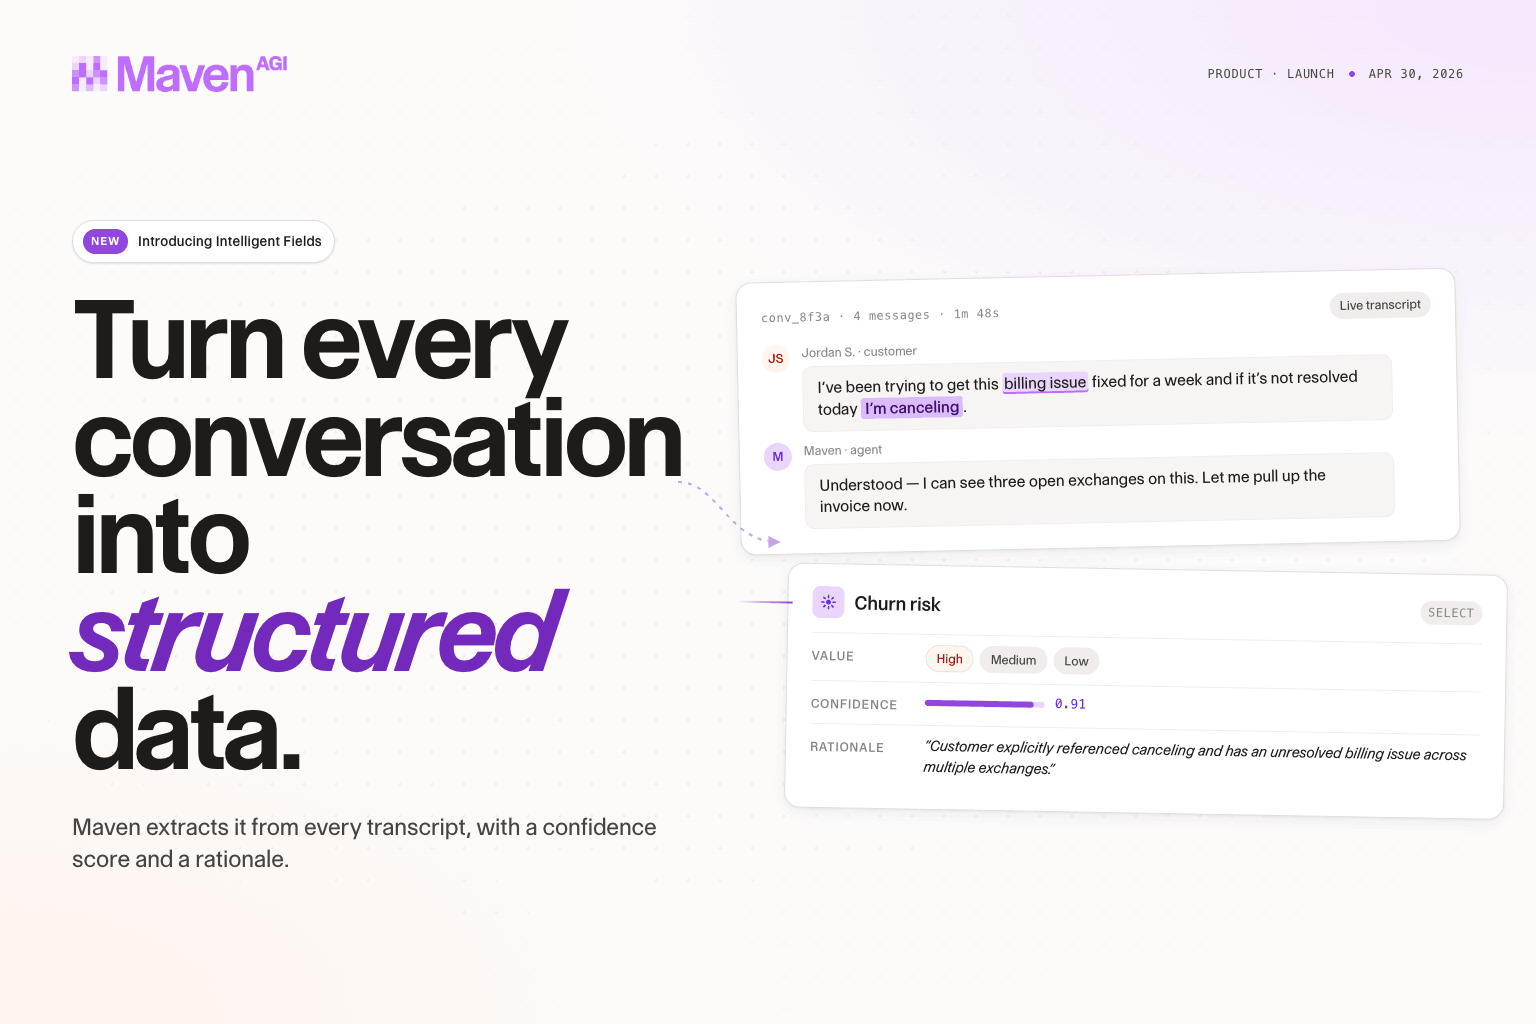
Så här ser det ut i praktiken. Du skapar fältet Churnrisk av typen Val med 3 alternativ: Hög, Medel och Låg. Instruktionerna är skrivna i vanligt språk: välj Hög om kunden nämner uppsägning, uttrycker frustration över fakturering eller har ett olöst problem över flera kontakter.
Det är hela konfigurationen. När fältet har publicerats utvärderar agenten det i varje konversation.
För en kund som skrev ”Jag har försökt få det här fixat i en vecka, och om det inte är löst i dag säger jag upp avtalet” returnerar fältet Hög, konfidens 0,91, med motiveringen: ”Kunden nämnde uttryckligen uppsägning och har ett olöst faktureringsproblem över flera kontakter.”
Den posten går nu att söka i. Alla konversationer där Churnrisk = Hög de senaste 30 dagarna. Skicka dem till en specialist på kundlojalitet i realtid. För över dem till ditt CRM.
Konfigurationen tar minuter, inte sprintar
Allt finns i Agent Designer. Definiera ett fält i vanligt språk, välj typ och publicera. Ingen kod krävs. Ett fullständigt REST-API finns för team som vill hantera fälten programmatiskt.
Vad det här gör möjligt
De supportteam som får ut mest av sina AI-agenter använder dem inte bara för att lösa ärenden snabbare. De använder dem för att förstå vad som händer i varje konversation, i en skala som ingen manuell granskning skulle klara.
Intelligent Fields gör det möjligt. Varje konversation som din agent hanterar blir en strukturerad datapost. Varje post är sökbar. Varje trend blir synlig.
Se det på dina egna konversationer.
Begär en kostnadsfri, personlig demo.


