
כל פלטפורמת סוכני AI ארגונית בשוק מדווחת על שיעור פתרון גבוה. קראו מספיק מצגות של ספקים והמספרים מתחילים להיטשטש. זו הבעיה השקטה של הקטגוריה כרגע: כשכולם טוענים לאותו סוג של תוצאה, הקונים מפסיקים להאמין לכולן, והמדד שאמור להיות החשוב ביותר הופך לרעש רקע.
יש חריג אחד. מספר מפסיק להיות שיווק ברגע שהלקוח מפיק אותו בעצמו, בתנאים שלו, מול הלקוחות שלו. זה ההבדל בין ספק שאומר שהסוכנים שלו פותרים את רוב הבעיות, לבין קונה שמריץ את המבחן ורואה את רוב הבעיות נפתרות.
Thumbtack הריצה את המבחן בעצמה
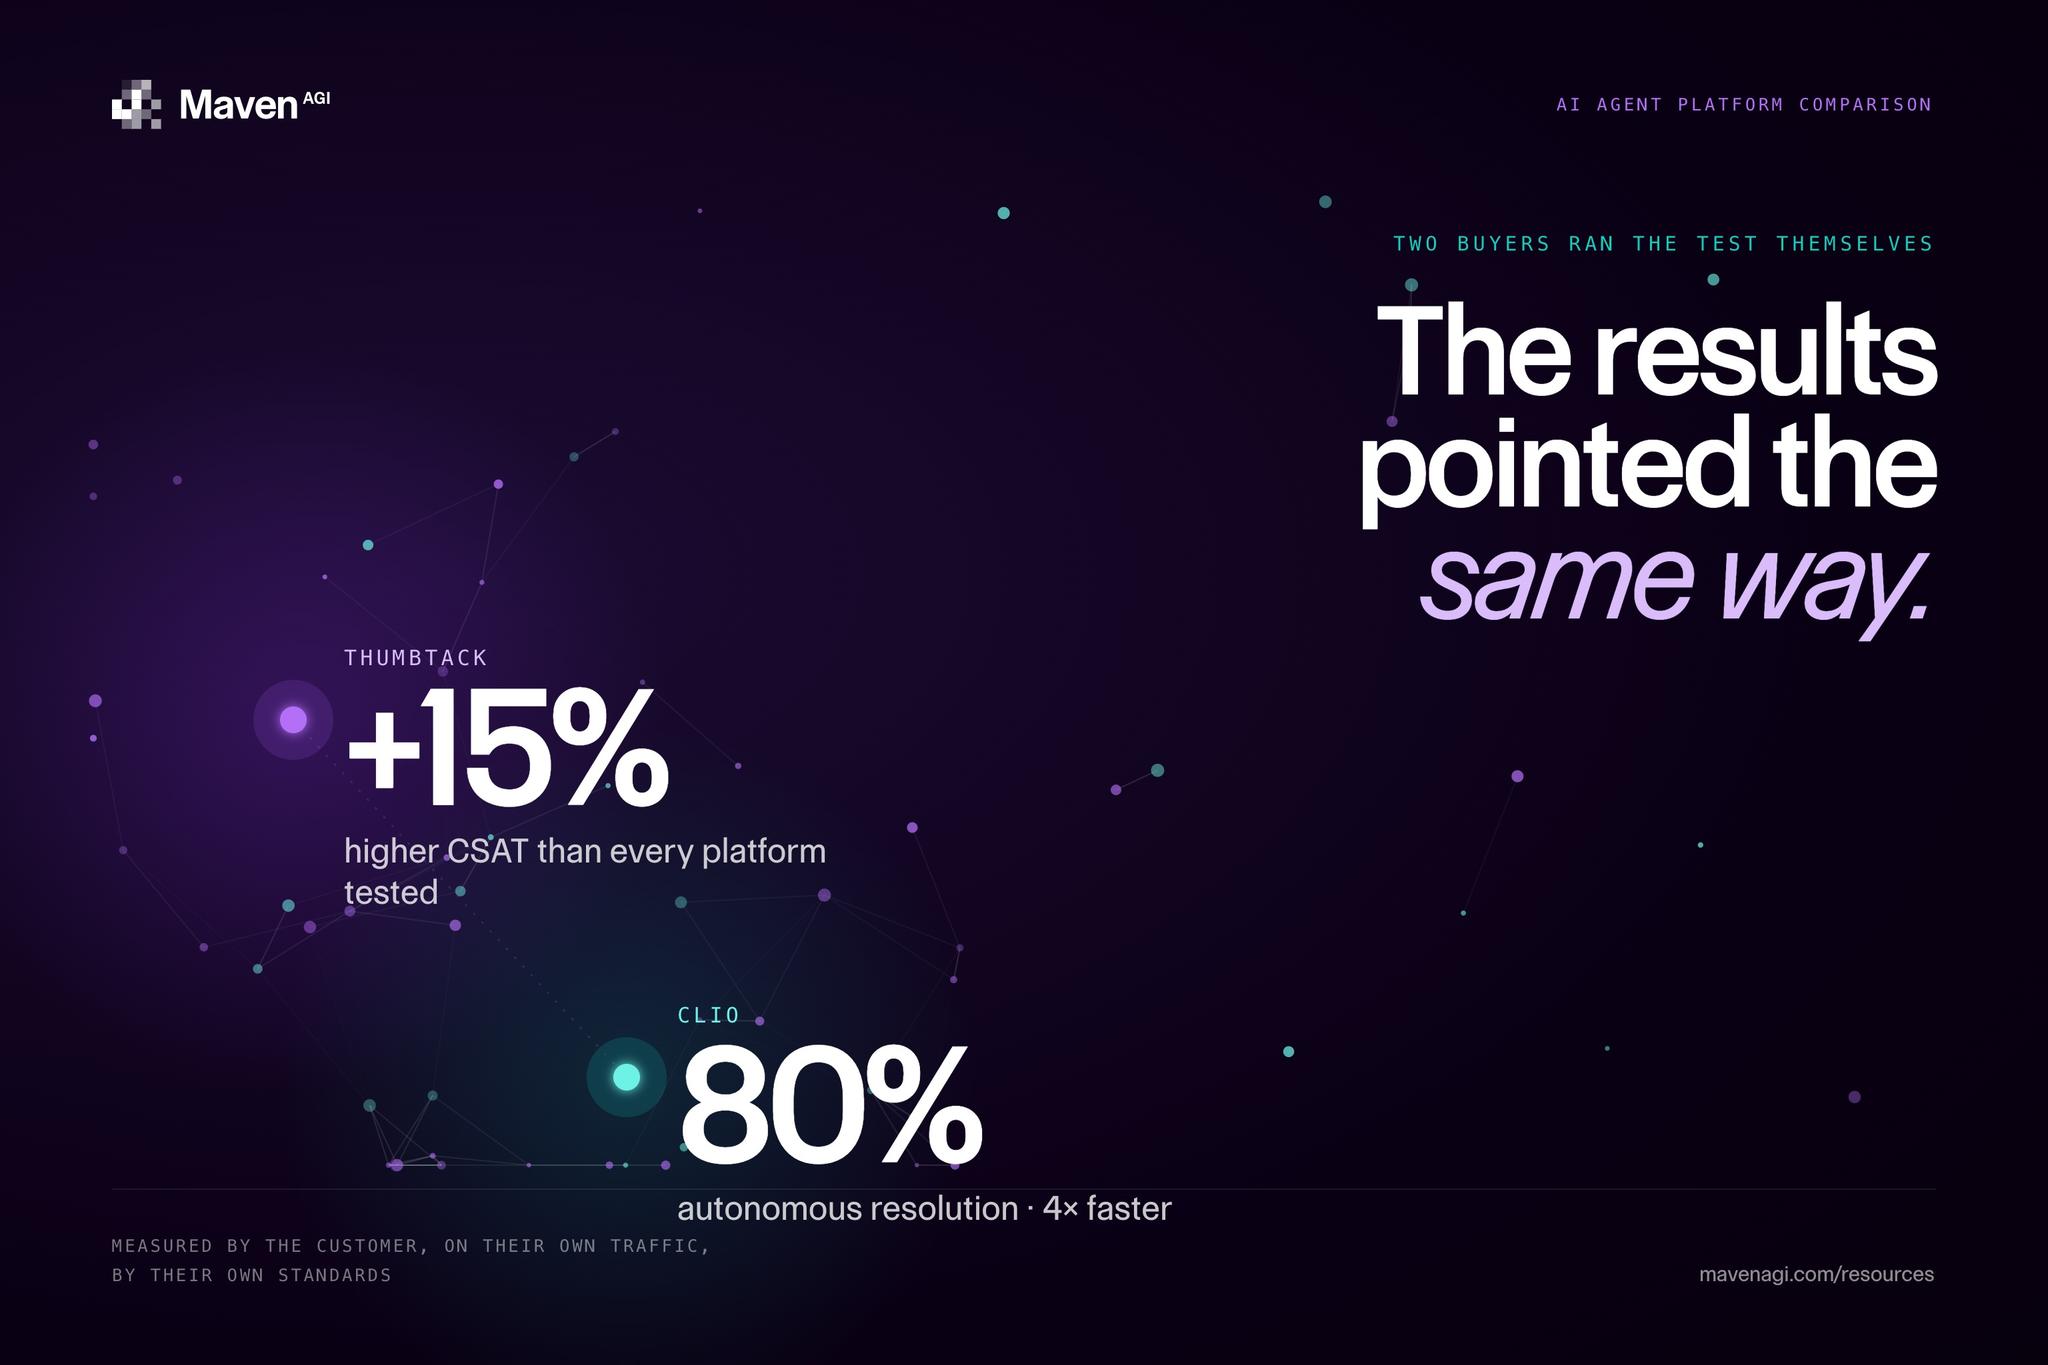
לפני שהתחייב, צוות Thumbtack הריץ בנצ'מרק השוואתי של פלטפורמות סוכני ה-AI המובילות, ומדד כל אחת מהן מול אותה תעבורת תמיכה חיה. Maven השיגה ציוני CSAT גבוהים ביותר מ-15 אחוז מכל מתחרה בהשוואה.
הפרט שכדאי להתעכב עליו הוא מי הריץ את המבחן. זה לא היה מספר ש-Maven דיווחה על עצמה, אלא תוצאה ש-Thumbtack מדדה, על הנפח של Thumbtack, מול רף שביעות הרצון של Thumbtack עצמה. הפלטפורמות שנבחנו לא קבעו את התנאים. הקונה קבע.
למה מבחן שהקונה מריץ שוקל יותר
הדגמה של ספק היא סביבה מבוקרת. השאלות ידועות מראש, הנתונים נקיים, ומקרי הקצה המביכים מושמטים בשקט. שום דבר מזה לא מלמד איך הפלטפורמה מתנהגת כשלקוח מתוסכל שואל משהו שהתסריט לא צפה, ב-11 בלילה בסוף שבוע של חג.
בנצ'מרק של לקוח מסיר את השליטה הזו. פניות אמיתיות מגיעות בכל צורה שהלקוחות שולחים אותן. שביעות הרצון נמדדת על ידי אנשים שלא אכפת להם איזה ספק ינצח. הפלטפורמה או פותרת את הבעיה ומשאירה את הלקוח מרוצה, או שלא.
זה גם מה שמבדיל את צוותי ה-CX החזקים ביותר מכל השאר. הם לא בוחרים סוכן AI ארגוני רק לפי רשימות פיצ'רים או טבלאות של אנליסטים. הם מגדירים את התוצאה שחשובה להם, פתרון אוטונומי ושביעות רצון לקוחות, ואז מודדים אותה על התעבורה שלהם לפני שהם חותמים על משהו.
הדפוס חוזר אצל Clio
Thumbtack היא לא הקונה היחידה שעובדת כך. Clio, חברת טכנולוגיה משפטית, בחנה 32 ספקים, צמצמה את הרשימה להתמודדות ישירה בין יותר מ-10 מהם, ואז בחרה ב-Maven. ההטמעה הגיעה ל-80 אחוז פתרון אוטונומי והפכה את התמיכה החיה למהירה פי 4.
2 חברות, בתעשיות שונות, עם פרופילי תמיכה שונים מאוד, הריצו הערכות עצמאיות והגיעו לאותה מסקנה. תוצאה בודדת היא מקרה. 2 תוצאות הן כבר דפוס. אף אחת מהן לא נשענה על המילה של הספק.
מה זה אומר על ההערכה שלכם
אם אתם מעריכים פלטפורמות סוכני AI עכשיו, המסקנה נוגעת פחות ל-Maven ויותר לשיטה. הקונים שעושים את זה נכון חולקים 4 דברים.
- הגדירו את המדד לפני ההדגמה. החילו על כל ספק את אותה הגדרה. שיעור פתרון שסופר בשקט גם הסטה הוא לא אותו מספר.
- בדקו על תעבורה חיה, לא על דגימות נבחרות. האופן שבו פלטפורמה מטפלת בפניות הכי מבולגנות שלכם הוא ההתנהגות היחידה שמנבאת את הביצועים בייצור.
- מדדו שביעות רצון מול הרף האמיתי שלכם. שיפור ב-CSAT משמעותי רק ביחס למה שהלקוחות שלכם חווים היום.
- תנו משקל להשוואה מדודה יותר מאשר להצגה מלוטשת. הספק עם המצגת הטובה ביותר והספק עם התוצאות הטובות ביותר הם לא תמיד אותה חברה.
הריצו הערכה כזו, והטענות השיווקיות יתבררו מעצמן. פלטפורמות שמצליחות רק בתנאים מבוקרים חושפות את זה מהר ברגע שתעבורת תמיכת לקוחות אמיתית מתחילה להגיע אליהן.
המדד שהלקוחות באמת מרגישים
מה ש-Thumbtack ו-Clio מדדו לא היה כמה שיחות אפשר להרחיק מנציג אנושי. הן מדדו כמה בעיות של לקוחות נפתרו בפועל, ואיך האנשים הרגישו אחר כך. מספר כזה מחזיק מעמד כי הלקוחות מרגישים אותו ישירות. טעות בו גובה מחיר אמיתי: בציוני שביעות הרצון, ברכישות חוזרות, ובאמון שקשה לבנות מחדש אחרי שנפגע.
עבור מנהלי CX שמנסים לסנן את הטענות של הספקים, הלקח משתי החברות זהה. הפלטפורמות ששוות מקום ברשימה הקצרה הן אלה שמוכנות להימדד על התעבורה שלכם, לפי הסטנדרטים שלכם, כשהלקוחות שלכם הם שנותנים את הציון. כל השאר הוא עדיין רק טענה.
ראו את זה על השיחות שלכם.
בקשו הדגמה מותאמת אישית ללא עלות.


