
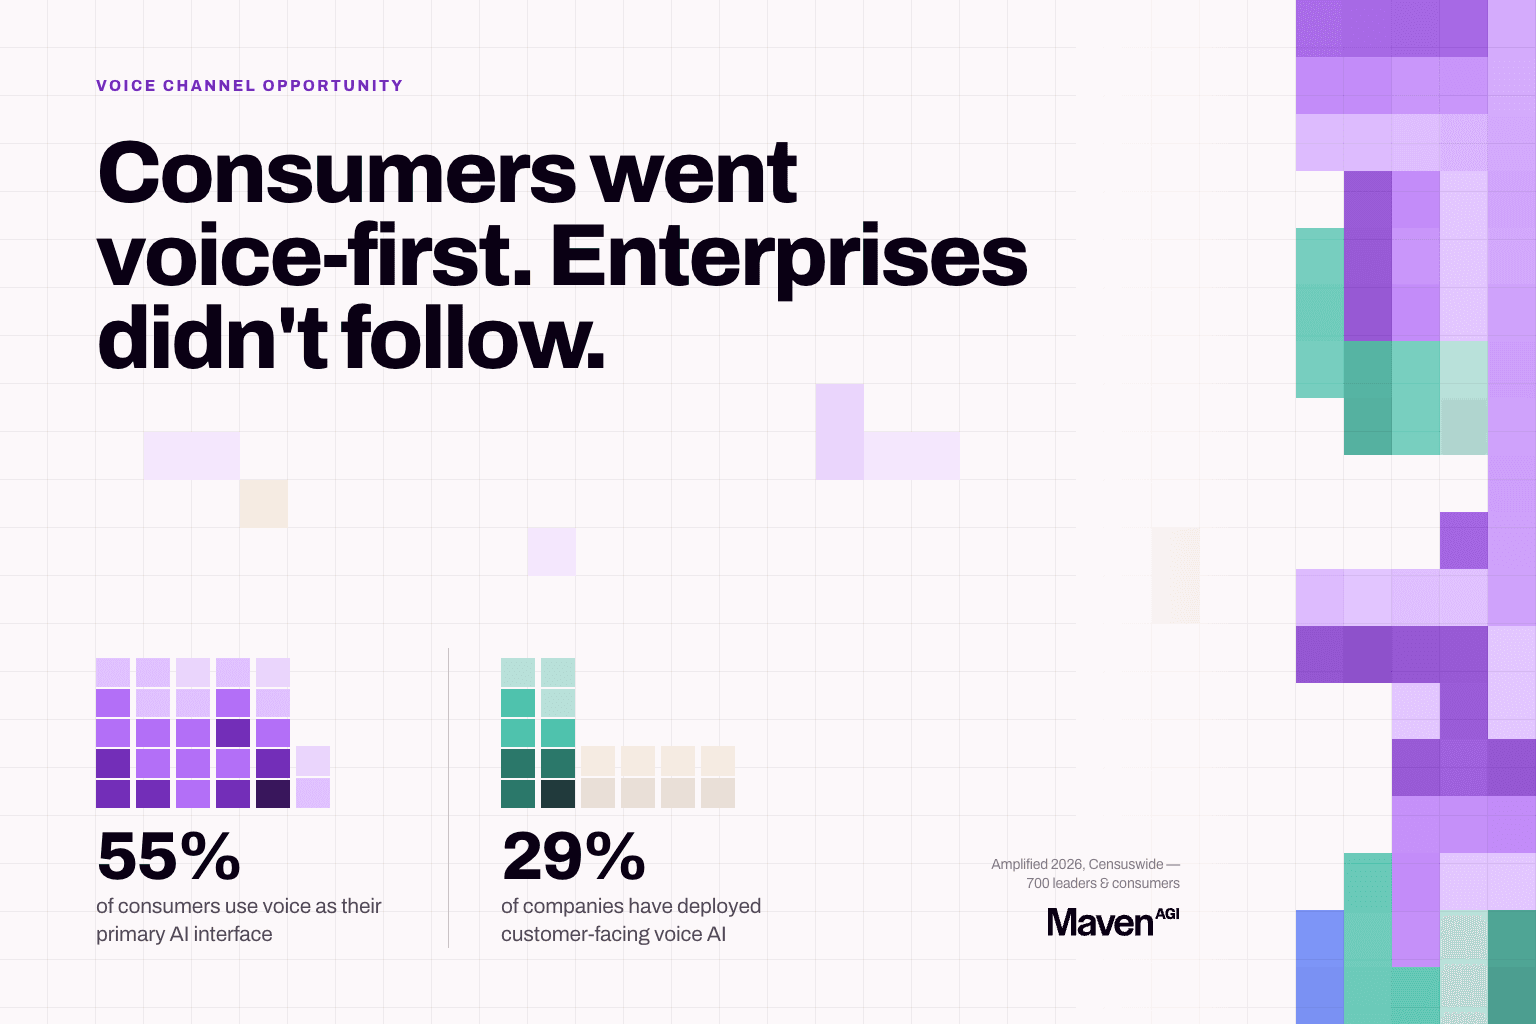
Les usages vocaux des consommateurs ont évolué plus vite que la maturité des entreprises. Selon Amplified 2026, une enquête Censuswide menée auprès de 700 dirigeants et consommateurs, 55 % des consommateurs utilisent désormais la voix comme interface principale pour interagir avec l'IA, alors que seulement 29 % des entreprises ont déployé une IA vocale face aux clients.
La voix est à la fois le canal le plus volumineux, le plus coûteux et le plus exigeant techniquement du service client, et celui où l'adoption de l'IA accuse le plus de retard. Cette combinaison est inhabituelle : le canal où il y a le plus de coûts à éliminer est aussi celui où la concurrence pour cet avantage est la plus faible.
Trois obstacles rendaient la voix difficile, et tous trois étaient réels : la latence, la précision et la conformité. Ce qui a changé, c'est qu'ils sont devenus des problèmes d'ingénierie avec des solutions, et non plus des questions de recherche ouvertes.
Pourquoi la latence était le plus difficile
La méthode classique pour construire un agent vocal enchaîne trois systèmes. La parole est transcrite en texte, un modèle de langage lit ce texte et rédige une réponse, et un troisième système la restitue à voix haute. Chaque étape fonctionne bien isolément. Le problème, c'est ce qui s'accumule entre elles.
Chaque passage ajoute du délai, et le client subit le total. Un temps de réponse inférieur à 300 ms est à peu près le seuil pour qu'un appel paraisse naturel, et au-delà d'environ une seconde de silence, les gens se remettent à parler. Un pipeline qui traite encore le premier énoncé se retrouve alors avec deux entrées qui se chevauchent et aucun moyen propre de les concilier.
La chaîne ne fait pas que perdre du temps. La transcription produit du texte : le ton, l'hésitation, le volume et le son audible de quelqu'un qui perd patience ne survivent pas au premier passage. Le modèle lit une phrase neutre, sans aucun indice que son auteur est sur le point de raccrocher. La reprise est fragile elle aussi : quand un client interrompt ou que deux personnes parlent en même temps, le pipeline doit détecter le problème à une étape et faire remonter l'information à travers des étapes qui n'ont jamais été conçues pour la recevoir.
Voilà pourquoi tant de déploiements vocaux brillent en démo et peinent un mardi après-midi. Les démos sont calmes, scénarisées et sans interruption.
Ce que change le voice-to-voice à modèle unique
Une autre architecture supprime ces passages. Un seul modèle reçoit de l'audio et produit de l'audio, sans conversion intermédiaire en texte puis en voix.
Comme le modèle travaille sur le son et non sur une transcription, ce que le pipeline éliminait reste disponible. Les interruptions arrivent en tant qu'interruptions. Les voix qui se chevauchent, le bruit de fond et les accents inhabituels deviennent des situations que le modèle gère, et non des cas d'échec qui cassent un passage de relais. Sans étapes intermédiaires, le délai de réponse se réduit suffisamment pour que les clients cessent de parler en même temps que le système.
C'est le mécanisme qui permet d'affirmer que la latence et la précision sont aujourd'hui résolues en production. Maven est la première plateforme d'IA d'entreprise à avoir mis des agents voice-to-voice pleinement en production, une distinction validée par Ibex, et prend en charge 57 langues en voice-to-voice et 54 en chat. Dans les déploiements mesurés par Maven, des agents vocaux bien conçus atteignent des taux de résolution comparables au chat sur des intentions similaires.
Pour être précis sur la stack : la voix en temps réel repose sur l'API OpenAI Realtime associée aux modèles vocaux de Cartesia, et l'agent vocal utilise le même moteur que le chat et l'e-mail : un client qui appelle après avoir envoyé un e-mail n'a pas à tout recommencer.
Les trois décisions qui déterminent désormais votre calendrier
Les obstacles techniques étant levés, la vitesse de déploiement se joue sur quelques choix, et dans chaque cas, l'option la plus rapide est généralement aussi la plus sûre.
- Téléphonie. Intégrez-vous à votre opérateur et à votre stack existants plutôt que de changer d'opérateur. Une migration vaut rarement la peine d'être menée en premier, et le voice-to-voice se connecte à ce que vous utilisez déjà, notamment Twilio, Vonage, Cisco, Zendesk Talk et Genesys.
- SVI. Superposez-vous au SVI existant et enrichissez-le plutôt que de le remplacer entièrement. Le remplacement offre un potentiel plus élevé, mais un chemin bien plus long.
- Escalade. Privilégiez un transfert accompagné qui transmet tout le contexte au conseiller. Un transfert à froid sans contexte est pire que l'absence d'automatisation, car le client doit tout réexpliquer.
La question de conformité que soulève immédiatement la voix
Au téléphone, les clients disent des choses que vous ne pouvez pas conserver. Numéros de carte, informations de santé, identifiants de compte, tout est prononcé à voix haute pendant qu'ils demandent de l'aide.
La conformité est plus stricte en vocal qu'à l'écrit, et elle se règle quand la plateforme est conçue pour cela plutôt qu'adaptée après coup. La question décisive est celle du moment. Le masquage des données personnelles en temps réel pendant l'appel et le traitement a posteriori créent des fenêtres d'exposition différentes, et seul le premier empêche la donnée sensible d'entrer dans le pipeline. Demandez laquelle de ces approches vous achetez avant la revue de sécurité, pas pendant.
Le multilingue se complique à l'oral
La traduction de texte est suffisamment maîtrisée pour que la plupart des entreprises ne s'en inquiètent plus. La voix, c'est autre chose. La langue parlée comporte des variations d'accent, des tournures régionales, des changements de langue en pleine phrase et des différences de débit qu'une transcription efface. Un pipeline en chaîne aggrave le problème, car la transcription doit deviner la langue avant que le modèle ne voie quoi que ce soit, et une erreur se propage à chaque étape suivante.
Les chiffres de couverture méritent d'être vérifiés. La bonne question à poser à tout éditeur : les langues annoncées ont-elles été testées en production, ou figurent-elles simplement dans la fiche technique d'un modèle ?
La preuve par le volume
Une entreprise de jeux du Fortune 500 opérant sur un marché réglementé atteint 80 % de résolution sur plus de 330 000 interactions mensuelles, dont 13 000 interactions résolues en une seule journée de pic d'activité.
Les jours de pic sont le vrai test. C'est lors des hausses de volume que les files d'attente explosent, qu'un système tient ou se dégrade visiblement, et que les clients se forgent une opinion durable sur l'utilité de vous appeler.
Évaluer la voix sans se laisser séduire par une démo
Une démo enregistrée ne prouve rien. Demandez un appel en direct et, pendant celui-ci, comportez-vous comme vos clients.
- Interrompez l'agent en pleine phrase et voyez s'il s'arrête ou continue de parler
- Changez d'avis au milieu d'une demande
- Ajoutez du bruit de fond
- Parlez avec un accent que l'éditeur n'a pas anticipé
- Demandez-lui de faire quelque chose, pas seulement de vous dire quelque chose
Le dernier point est le plus important. Répondre à une question et réaliser une transaction sont deux capacités différentes, et la résolution autonome exige la seconde.
Les trois décisions sont résumées dans L'arbre de décision de l'IA vocale , à associer à Cadrer un pilote de 90 jours pour les équipes qui envisagent la voix comme premier canal automatisé. Tous deux s'appuient sur le chapitre « L'opportunité du canal vocal » du rapport State of AI in CX 2026 .
Voyez-le à l’œuvre sur vos propres conversations.
Demandez une démo personnalisée gratuite.


