
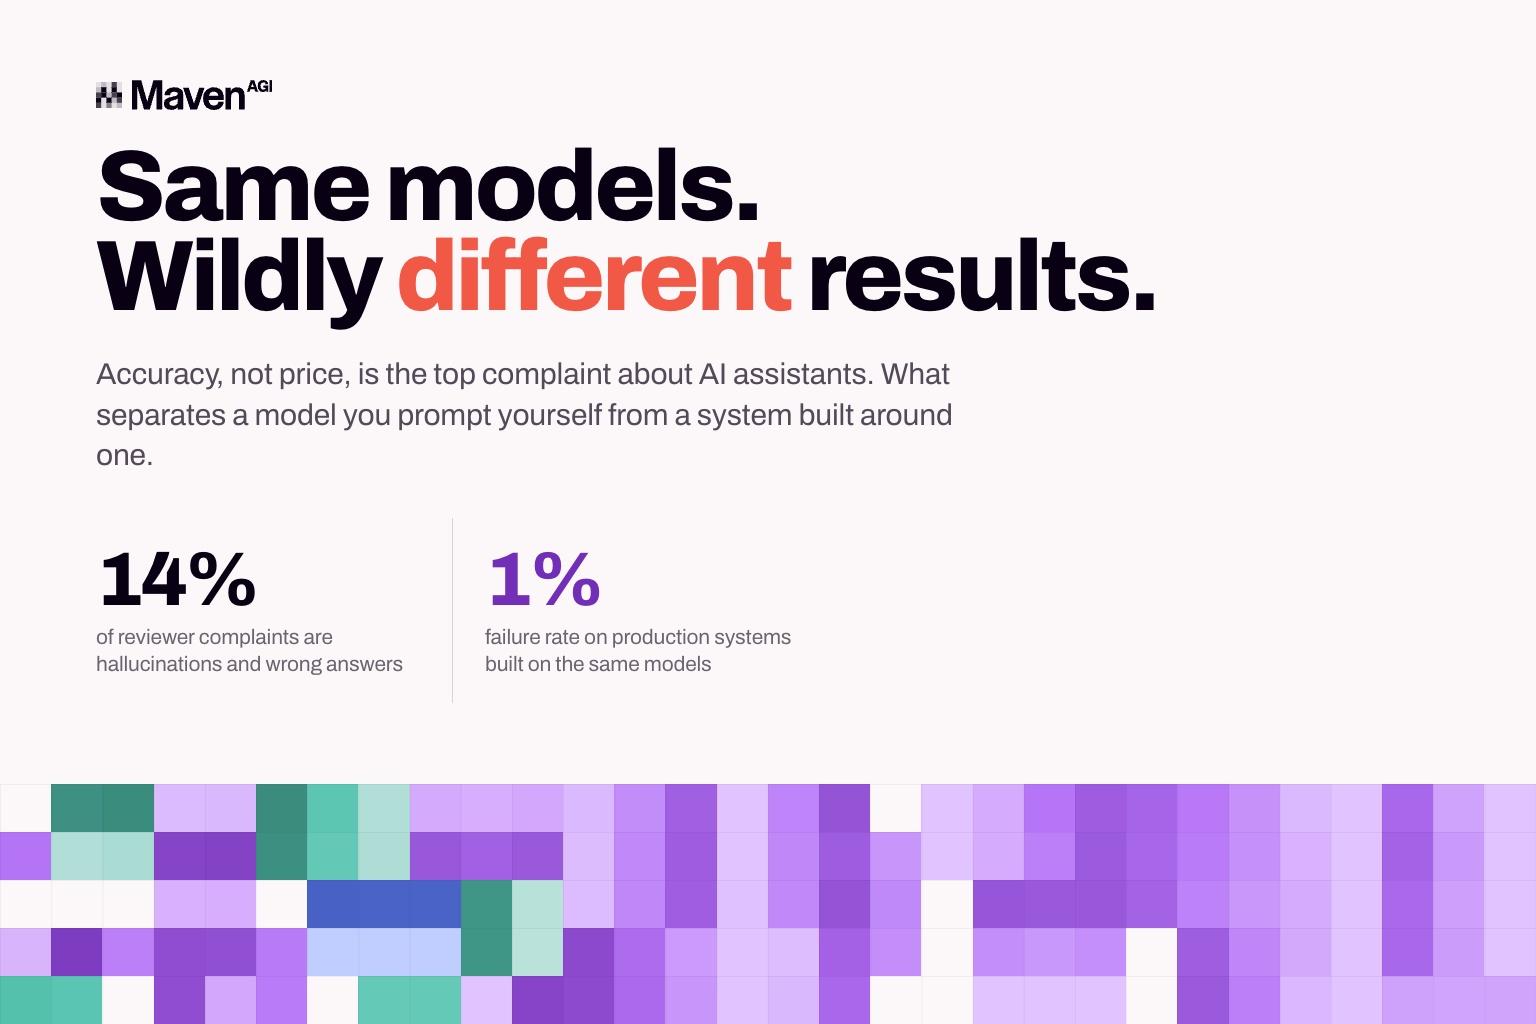
G2 analizó más de 2950 reseñas verificadas publicadas entre enero y mediados de julio y se preguntó de qué se queja más la gente. La principal queja fue la precisión, no el precio. Las alucinaciones y las respuestas incorrectas representaron el 14 % de todo lo que los usuarios dijeron que no les gustaba, por encima del coste, en un año en el que el coste parece ser lo único de lo que todos quieren discutir.
Conviene saber quiénes escribieron esas reseñas, porque eso cambia lo que significa la cifra. La mayoría habla de los asistentes de uso general que todo el mundo tiene abiertos en una pestaña del navegador. No son equipos de CX describiendo un agente de soporte en producción. Son personas que le preguntan algo a un modelo, reciben una respuesta segura y luego tienen que averiguar por su cuenta si es cierta.
Después, G2 consultó a 4 proveedores que crean sistemas en producción sobre esos mismos modelos y les preguntó cuáles son realmente sus tasas de fallo. Pueden bajar hasta el 1 %.
Así que lo que realmente se compara no es un modelo frente a otro. Es un modelo al que tú mismo le escribes prompts frente a un sistema que alguien construyó alrededor de un modelo: la misma tecnología de fondo, resultados radicalmente distintos. Maven fue uno de los 4 proveedores consultados por G2.
Qué explica la diferencia
Nada de lo que describieron esos 4 proveedores tenía que ver con el modelo que habían elegido. Todos dijeron más o menos lo mismo. Sus sistemas funcionan por pasos, no de una sola vez. Las respuestas se obtienen de datos en tiempo real, no de lo que el modelo recuerde de su entrenamiento. Miden con qué frecuencia se completa realmente una tarea y reescriben prompts y lógica al menos una vez por semana. Uno de ellos lo hace a diario. Todo ese trabajo se hace alrededor del modelo, no sobre él.
Lo más útil en lo que coincidieron es dónde se concentra el esfuerzo. Los 4 dijeron que lo difícil no es la pregunta cotidiana, sino los casos límite y las tareas de varios pasos, así que crean sistemas que detectan cuándo algo los supera y transfieren la conversación a una persona en lugar de adivinar. La frase de Maven en la encuesta fue que «la autonomía sin una lógica de respaldo fiable no es una funcionalidad; es un riesgo».
Ahí está la mayor parte de la diferencia. Cuando le escribes prompts a un modelo, eres tú quien revisa su trabajo. Un sistema en producción está diseñado para que esa tarea nunca recaiga en el cliente. G2 lo dijo sin rodeos: estos proveedores no tienen menos fallos, los detectan antes de que nadie se dé cuenta.
El debate entre agentes y chatbots es, sobre todo, de palabras
G2 preguntó directamente a sus 4 proveedores si los agentes de IA son más fiables que lo que la categoría sigue llamando chatbots. Todos respondieron más o menos lo mismo, y no es una buena noticia para quien vende apoyándose en la palabra. En producción, los dos no son tan distintos como sugiere el marketing, y cambiar una etiqueta por otra no resuelve nada por sí solo.
Esto importa más a los compradores que a los proveedores. Si buscas la palabra «agente», estás comprando una etiqueta, no una capacidad. Que un proveedor llame agente a su producto y otro lo llame de otra forma no te dice nada sobre si alguno de ellos consulta tu conocimiento actual, detecta cuándo no está seguro o se evalúa con conversaciones reales después del lanzamiento. Esas son propiedades de la IA agéntica en el servicio al cliente, y ninguna viene incluida con la etiqueta.
Las preguntas que sí te dicen algo tratan sobre cómo está construido, y puedes hacer las 5 en una primera llamada.
- ¿De dónde salen las respuestas? ¿Consulta tu conocimiento en tiempo real o se basa en lo que el modelo absorbió durante el entrenamiento?
- ¿Qué pasa cuando no está seguro? ¿Transfiere la conversación o adivina con el mismo tono seguro que usa cuando acierta?
- ¿Con qué frecuencia alguien contrasta sus respuestas con conversaciones reales y qué se mide?
- ¿Tu equipo puede cambiar el comportamiento del agente o cada ajuste tiene que pasar por el proveedor?
- ¿Puede hacer cosas de verdad en tus sistemas o solo puede decirle al cliente qué hacer?
Si un proveedor puede responder a las 5, alguien hizo el trabajo. Si acierta con la primera y luego se vuelve impreciso, compró un modelo y le puso un widget encima. Hay una versión más extensa de esta lista en nuestra guía para evaluar agentes de IA para el servicio al cliente empresarial.
Lo que los compradores pasan por alto
Lo que describieron esos 4 proveedores es la misma base sobre la que se construye la arquitectura de 5 capas de Maven. El modelo es una capa. Todo lo que lo hace fiable está a su alrededor: lo que sabe el agente, lo que tiene permitido hacer, cómo revisas su trabajo una vez en producción y quién controla las salvaguardas. Los compradores suelen elegir por el modelo, porque es la capa que lleva los nombres conocidos. Todo lo que señalan los datos de G2 está en las otras 4, y es la razón por la que la resolución autónoma es algo distinto a una buena respuesta.
Por eso, además, implementar rápido y ser fiable no son opuestos, por mucho que la categoría lo dé por hecho. Construir esas capas es ingeniería de verdad, pero se hace una vez, dentro de la plataforma, en lugar de convertirse en un proyecto de 6 meses dentro de la infraestructura de cada cliente.
Cómo se ve cuando el trabajo está hecho
Mastermind alcanzó un 93 % de resolución autónoma en 6 semanas. K1x llegó al 80 % en su primera semana. Rho mantuvo un 95 % de CSAT mientras asumía un 12 % más de contactos al mes sin contratar a nadie. Quest creó AskQ sobre Maven, lo conectó a una base de conocimiento y un sistema de casos que ya tenía, sin migrar datos, y lo evalúa por la satisfacción del cliente, no por la deflexión.
Las reseñas de Maven apuntan en la misma dirección. 4,8 de 5 en 20 reseñas verificadas, y vale la pena leer lo que la gente destaca: un único motor que gestiona chat, correo electrónico y voz en lugar de bots separados que hay que mantener sincronizados; una recuperación de conocimiento que señala artículos obsoletos, duplicados y contradictorios en lugar de responder con el primero que encuentra; una configuración que se mide en días sobre Salesforce o Zendesk. Todo eso es lo que rodea al modelo.
En los informes Fall 2026 de G2, publicados el 25 de agosto, Maven apareció en el Mid-Market Grid de Customer Service Automation, el Mid-Market Results Index de AI Customer Support Agents y el Implementation Index de AI Customer Support Agents. Los informes de índice se basan en lo que dicen los clientes sobre los resultados obtenidos y cómo fue la implementación, no en el tamaño o la notoriedad de una empresa. Miden exactamente lo que, según los datos más amplios de G2, está fallando en todas partes.
La diferencia es lo importante
La cifra en la que fijarse es la distancia entre el 14 % y el 1 %, porque ambas se apoyan en el mismo puñado de modelos. Nada en la tecnología explica una diferencia tan grande. Lo que la explica es si alguien se molestó en construir las piezas que detectan una mala respuesta antes de que la vea un cliente, y por eso una tasa de resolución solo significa algo cuando sabes cómo se midió.
La mayoría de los compradores sigue comparando nombres de modelos. Los 4 proveedores con los que habló G2 dejaron de hacerlo hace tiempo.
Si quieres ver las capas en lugar de leer sobre ellas, reserva una demo.
Míralo con tus propias conversaciones.
Solicita una demo personalizada gratuita.


