
多數 AI 代理的設計中,都內建了一個鮮少被檢視的假設:只要資料與回答問題相關,代理就應該可以使用。
聽起來合理,但其實是錯的。
對於經營多方參與者群體平台的組織來說,例如顧客與商家、乘客與司機、客戶與服務供應商,正是這個假設讓 AI 導入在不知不覺間演變成信任問題。
相關性陷阱
一位顧客因外送延遲聯絡客服,想知道發生了什麼事,並要求退款。
最相關的資訊包括:餐廳的平均備餐時間、該筆訂單的實際備餐時段、司機的路線紀錄,以及履約過程中出現的任何異常標記。這些資訊全都直接有用,能產生更好、更準確的回答。
但這也會讓顧客看到餐廳的營運績效資料,而這根本不是顧客該看到的。它會在未經正當程序的情況下,將問題歸咎於司機的行為。它會在雙方都不知情、也未同意的情況下,把一方的結果與另一方的資料直接連結起來。
代理並沒有犯錯,它完全依照設計行事:找出相關資訊並加以使用。真正的錯誤在於假設相關性與權限是同一回事。
為什麼這個區分比想像中更困難
在單邊產品中,相關性與權限大致一致。提出問題的使用者,同時也是資料範圍內的當事人。「有用」與「被允許」之間的落差很小,多數代理都能順利應對而不出問題。
多邊平台則完全打破了這個假設。
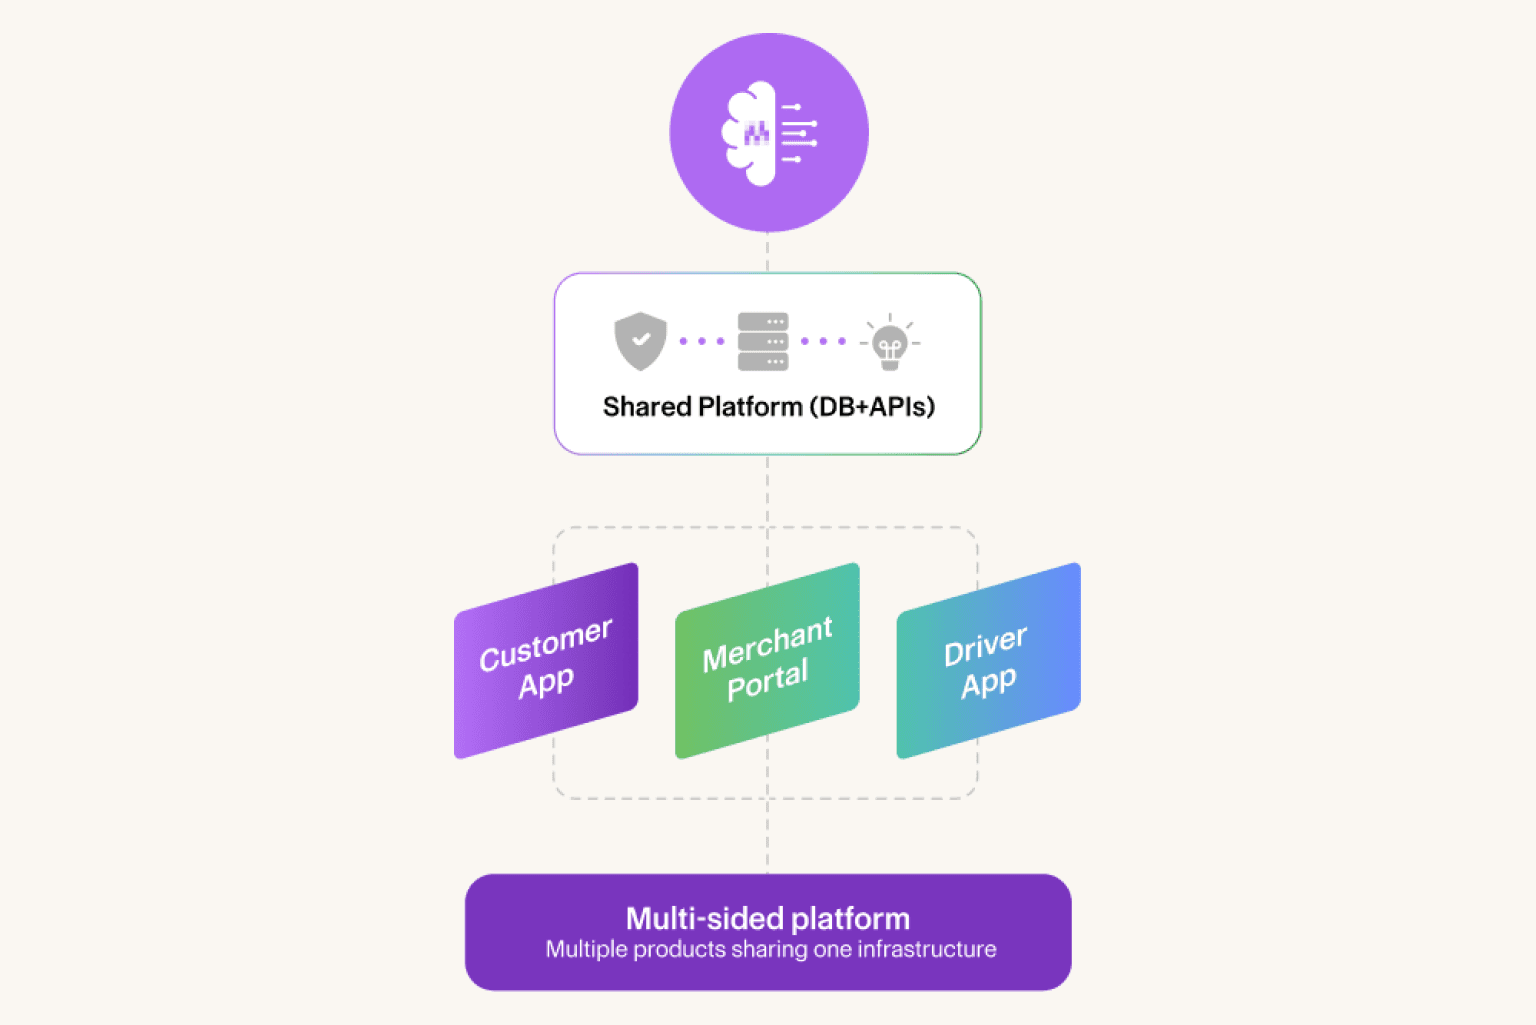
每個參與者群體都有各自的資料、工作流程、隱私期待,以及對公平結果的定義。當 AI 代理透過共用知識庫橫跨所有群體運作時,它面對的不是單一資料環境,而是同時面對多個彼此之間缺乏明確界線的環境。
以下 3 種失敗模式一再出現:
跨介面的資料外洩。 在某個介面上相關的資訊,其實屬於另一個介面上的參與者。例如顧客端代理能看到商家的爭議紀錄、商家入口網站顯示顧客投訴細節,或司機介面引用平台層級的執法資料。
在其他地方造成未經審查後果的動作。 在顧客端發出的退款,會觸發商家端的撥款扣除。若 AI 代理能執行前一個動作,卻看不到後續影響,它就會做出看似合理、卻引發它從未接觸到之問題的決策。回饋迴圈無法閉合。
不同參與者群體受到不一致的對待。 同樣的根本問題——「為什麼我的款項被扣減?」——由商家或司機提出時,意義截然不同。可使用的資料、適當的回應與允許的動作全都不同。缺乏明確介面界線的代理,產生的答案在技術上正確,在情境上卻是錯的。
這些都不是 AI 代理的錯,而是架構上的失敗。從來沒有人告訴代理界線在哪裡。
相關性是起點,而非授權
關鍵的觀念轉換在於:相關性應決定代理要尋找什麼,而資格(eligibility)則應決定它實際能存取什麼。
這是兩個不同的問題,必須依序回答。
資格優先。在代理擷取任何資料之前,平台必須已經回答:這次互動來自哪個介面?哪個參與者群體已通過驗證?在這個介面、這個角色、這個政策情境下,哪些資料與動作在範圍內?無論多麼相關,哪些內容一律禁止存取?
這些不是交給模型推理的問題,而是平台在代理啟動前就以確定性方式強制執行的限制。相關性只能在這些限制之內運作,而不能取而代之。
實際效果相當顯著。限定於顧客端介面的代理,不可能意外揭露商家資料。原因不是它被指示不要這麼做,而是那些資料從一開始就不在可存取範圍內。提示指令可能被推理繞過,資格限制則不會。
這個差異比表面上更重要。「不應該使用」與「無法存取」並不是同等級的保護。在大規模、複雜且充滿真實邊緣案例的環境中,只有後者站得住腳。
這在實務上代表什麼
做對這件事的平台,並不是打造限制更多的代理,而是打造架構更完善的代理。代理的推理能力不變,改變的是它推理時所依據的介面。
結果並不是能力較弱的代理,而是能同時獲得所有參與者群體信任的代理。在多邊平台上,這才是能夠規模化的能力。
相關性讓您得到好的答案,資格讓您得到值得信任的答案。
用您自己的對話實際體驗。
申請免費的專屬展示。


