
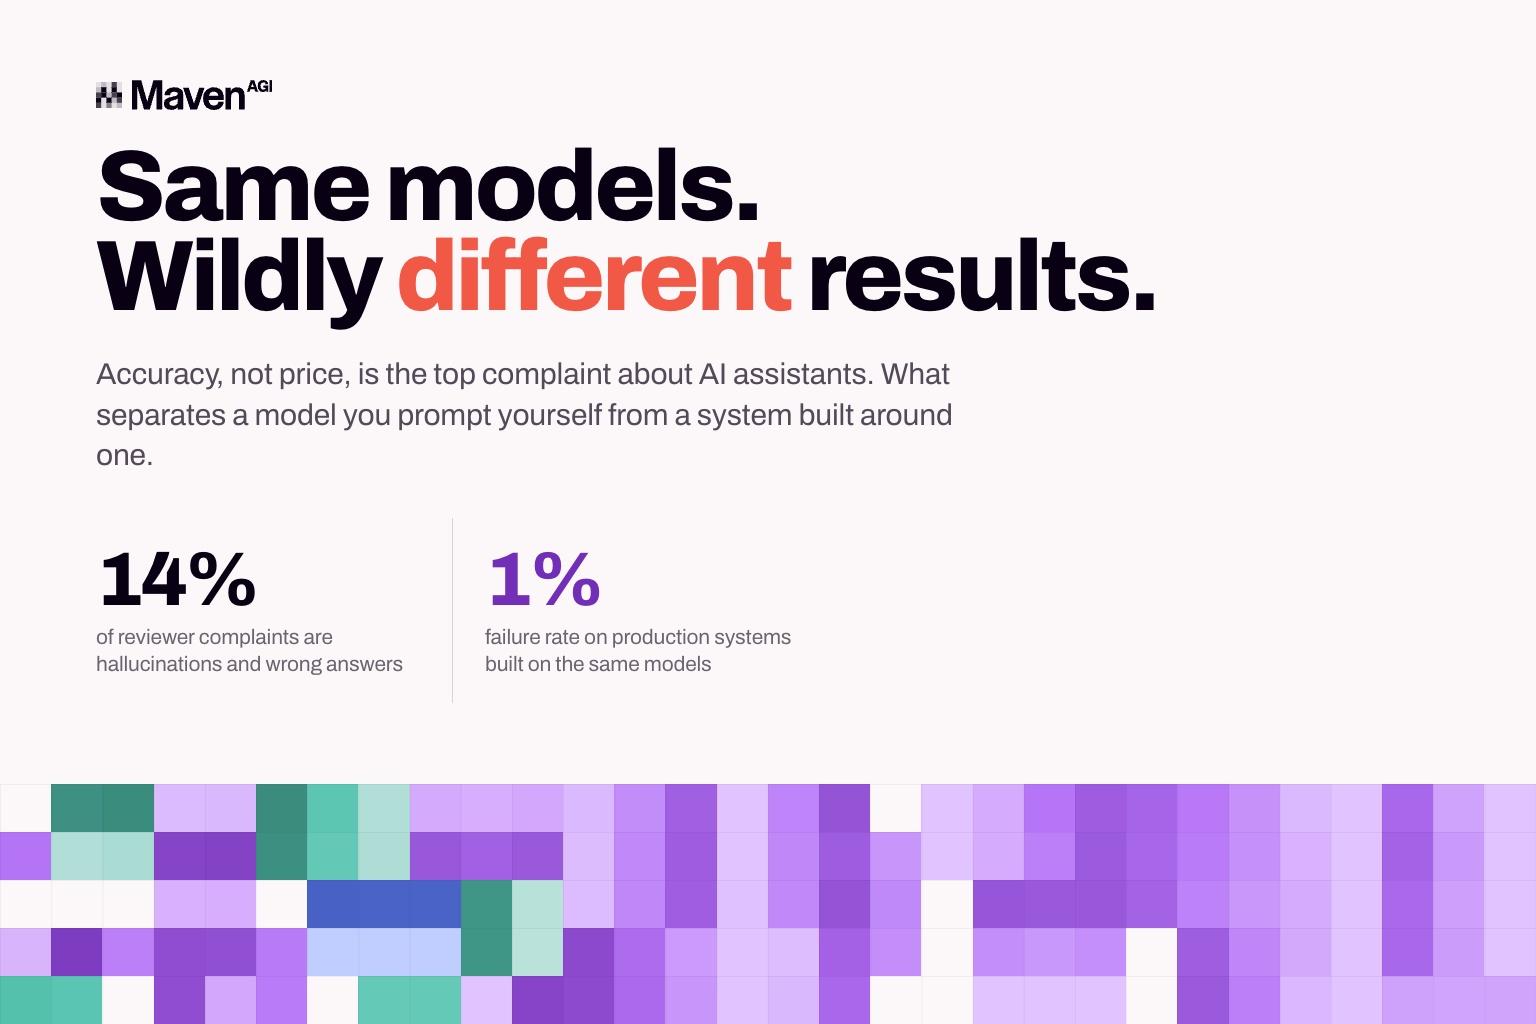
G2 przeanalizowało ponad 2 950 zweryfikowanych recenzji z okresu od stycznia do połowy lipca i sprawdziło, na co użytkownicy skarżą się najczęściej. Największym problemem okazała się dokładność, a nie cena. Halucynacje i błędne odpowiedzi stanowiły 14% wszystkich uwag krytycznych. Wyprzedziły tym samym koszty, i to w roku, w którym o kosztach dyskutuje się najwięcej.
Warto wiedzieć, kim są ci recenzenci, bo od tego zależy, co ta liczba oznacza. Większość z nich pisze o asystentach ogólnego przeznaczenia, które każdy ma otwarte w karcie przeglądarki. Nie są to zespoły CX opisujące agenta obsługi działającego produkcyjnie. To osoby, które zadają modelowi pytanie, dostają pewną siebie odpowiedź, a potem same muszą ustalić, czy jest prawdziwa.
Następnie G2 zapytało 4 dostawców budujących systemy produkcyjne na tych samych modelach, jak naprawdę wyglądają ich wskaźniki błędów. Odpowiedź: nawet 1%.
W rzeczywistości nie porównujemy więc jednego modelu z drugim. Porównujemy model, któremu samodzielnie wpisuje się prompty, z systemem zbudowanym wokół modelu. Pod spodem ta sama technologia, a wyniki zupełnie inne. Maven był jednym z 4 dostawców, których zapytało G2.
Skąd bierze się ta różnica
Nic z tego, co opisali ci 4 dostawcy, nie wiązało się z wyborem modelu. Wszyscy mówili mniej więcej to samo. Ich systemy działają etapami, a nie w jednym podejściu. Odpowiedzi pochodzą z bieżących danych, a nie z tego, co model akurat zapamiętał z treningu. Dostawcy mierzą, jak często zadanie zostaje faktycznie zrealizowane, i przepisują prompty oraz logikę co najmniej raz w tygodniu. Jeden z nich robi to codziennie. To praca wykonywana wokół modelu, a nie na samym modelu.
Ważniejsze jest to, w czym byli zgodni co do rozłożenia wysiłku. Wszyscy 4 stwierdzili, że trudność nie leży w codziennych pytaniach, lecz w przypadkach brzegowych i zadaniach wieloetapowych. Dlatego budują systemy, które rozpoznają, kiedy wychodzą poza swoje kompetencje, i zamiast zgadywać, przekazują rozmowę człowiekowi. Maven ujął to w badaniu tak: „autonomia bez wiarygodnej logiki awaryjnej nie jest funkcją; jest ryzykiem”.
To wyjaśnia większą część różnicy. Gdy korzysta się z modelu samodzielnie, to użytkownik musi weryfikować jego pracę. System produkcyjny jest zbudowany tak, aby to zadanie nigdy nie spadało na klienta. G2 ujęło to wprost: ci dostawcy nie mają mniej błędów, tylko wychwytują je, zanim ktokolwiek je zauważy.
Spór „agent kontra chatbot” to głównie kwestia słów
G2 zapytało swoich 4 dostawców wprost, czy agenci AI są bardziej niezawodni niż rozwiązania, które w tej kategorii wciąż nazywa się chatbotami. Wszyscy odpowiedzieli podobnie i nie jest to dobra wiadomość dla tych, którzy sprzedają samą nazwę. W środowisku produkcyjnym te dwa rozwiązania różnią się znacznie mniej, niż sugeruje marketing, a zamiana jednej etykiety na drugą sama w sobie niczego nie naprawia.
Ma to większe znaczenie dla kupujących niż dla dostawców. Kto szuka słowa „agent”, kupuje etykietę, a nie możliwości. To, że jeden dostawca nazywa swój produkt agentem, a inny inaczej, nic nie mówi o tym, czy którykolwiek z nich korzysta z aktualnej bazy wiedzy firmy, rozpoznaje, kiedy nie ma pewności, i czy po wdrożeniu jest weryfikowany na podstawie rzeczywistych rozmów. To cechy agentowej AI w obsłudze klienta i żadna z nich nie przychodzi razem z etykietą.
Pytania, które naprawdę coś mówią, dotyczą sposobu budowy rozwiązania. Wszystkie 5 można zadać już podczas pierwszej rozmowy.
- Skąd pochodzą odpowiedzi? Czy system sięga do aktualnej wiedzy firmy, czy opiera się na tym, co model przyswoił podczas treningu?
- Co się dzieje, gdy system nie ma pewności? Przekazuje rozmowę dalej czy zgaduje tym samym pewnym tonem, którego używa, gdy ma rację?
- Jak często ktoś weryfikuje jego odpowiedzi na podstawie rzeczywistych rozmów i co dokładnie jest mierzone?
- Czy Państwa zespół może zmienić sposób działania agenta, czy każda poprawka musi przechodzić przez dostawcę?
- Czy agent może faktycznie wykonać działanie w Państwa systemach, czy tylko mówi klientowi, co ma zrobić?
Jeśli dostawca potrafi odpowiedzieć na wszystkie 5 pytań, ktoś wykonał tę pracę. Jeśli świetnie odpowiada na pierwsze, a potem robi się mgliście, to kupił model i opakował go widżetem. Dłuższą wersję tej listy znajdą Państwo w naszym przewodniku jak oceniać agentów AI do obsługi klienta w przedsiębiorstwie.
Elementy, które kupujący pomijają
To, co opisali ci 4 dostawcy, to ten sam stos, na którym opiera się 5-warstwowa architektura Maven. Model to tylko jedna warstwa. Wszystko, co zapewnia niezawodność, znajduje się wokół niego: co agent wie, co wolno mu robić, jak weryfikuje się jego pracę po uruchomieniu i kto kontroluje zabezpieczenia. Kupujący zwykle wybierają model, bo to warstwa ze znanymi nazwami. Tymczasem wszystko, na co wskazują dane G2, leży w pozostałych 4 warstwach. Właśnie dlatego autonomiczne rozwiązywanie spraw to coś innego niż dobra odpowiedź.
Z tego samego powodu szybkie wdrożenie i niezawodność nie wykluczają się, wbrew temu, co zakłada branża. Zbudowanie tych warstw to prawdziwa praca inżynierska, ale wykonuje się ją raz, wewnątrz platformy, a nie jako 6-miesięczny projekt w środowisku każdego klienta.
Jak to wygląda, gdy praca została wykonana
Mastermind osiągnął 93% autonomicznie rozwiązanych spraw w 6 tygodni. K1x uzyskał 80% już w pierwszym tygodniu. Rho utrzymał CSAT na poziomie 95%, obsługując o 12% więcej kontaktów miesięcznie bez zatrudniania nowych osób. Quest zbudował AskQ na platformie Maven, podłączył go bez migracji danych do istniejącej bazy wiedzy i systemu obsługi spraw, a ocenia go na podstawie satysfakcji klientów, a nie wskaźnika deflekcji.
Recenzje samego Maven wskazują w tym samym kierunku. 4,8 na 5 w 20 zweryfikowanych recenzjach. Warto przeczytać, o czym użytkownicy faktycznie piszą: jeden silnik obsługujący czat, e-mail i głos zamiast osobnych botów, które trzeba synchronizować; wyszukiwanie wiedzy, które oznacza nieaktualne, zduplikowane i sprzeczne artykuły, zamiast odpowiadać na podstawie pierwszego znalezionego; konfiguracja liczona w dniach na bazie Salesforce lub Zendesk. Wszystko to są elementy wokół modelu.
W jesiennych raportach G2 za 2026 rok, opublikowanych 25 sierpnia, Maven znalazł się w zestawieniach Mid-Market Grid for Customer Service Automation, Mid-Market Results Index for AI Customer Support Agents oraz Implementation Index for AI Customer Support Agents. Raporty indeksowe powstają na podstawie opinii klientów o osiągniętych wynikach i przebiegu wdrożenia, a nie wielkości czy rozpoznawalności firmy. Mierzą dokładnie to, co według szerszych danych G2 zawodzi wszędzie indziej.
Sednem jest różnica
Liczba, na którą warto zwrócić uwagę, to odległość między 14% a 1%, bo obie wartości opierają się na tej samej garstce modeli. Technologia nie tłumaczy tak dużej różnicy. Tłumaczy ją to, czy ktoś zadał sobie trud zbudowania elementów, które wychwytują złą odpowiedź, zanim zobaczy ją klient. Dlatego wskaźnik rozwiązywania spraw ma znaczenie dopiero wtedy, gdy wiadomo, jak został zmierzony.
Większość kupujących wciąż porównuje nazwy modeli. Dostawcy, z którymi rozmawiało G2, dawno już z tego zrezygnowali.
Jeśli chcą Państwo zobaczyć te warstwy w działaniu, zamiast o nich czytać, umów demo.
Przekonaj się na własnych rozmowach.
Poproś o bezpłatne, spersonalizowane demo.


