

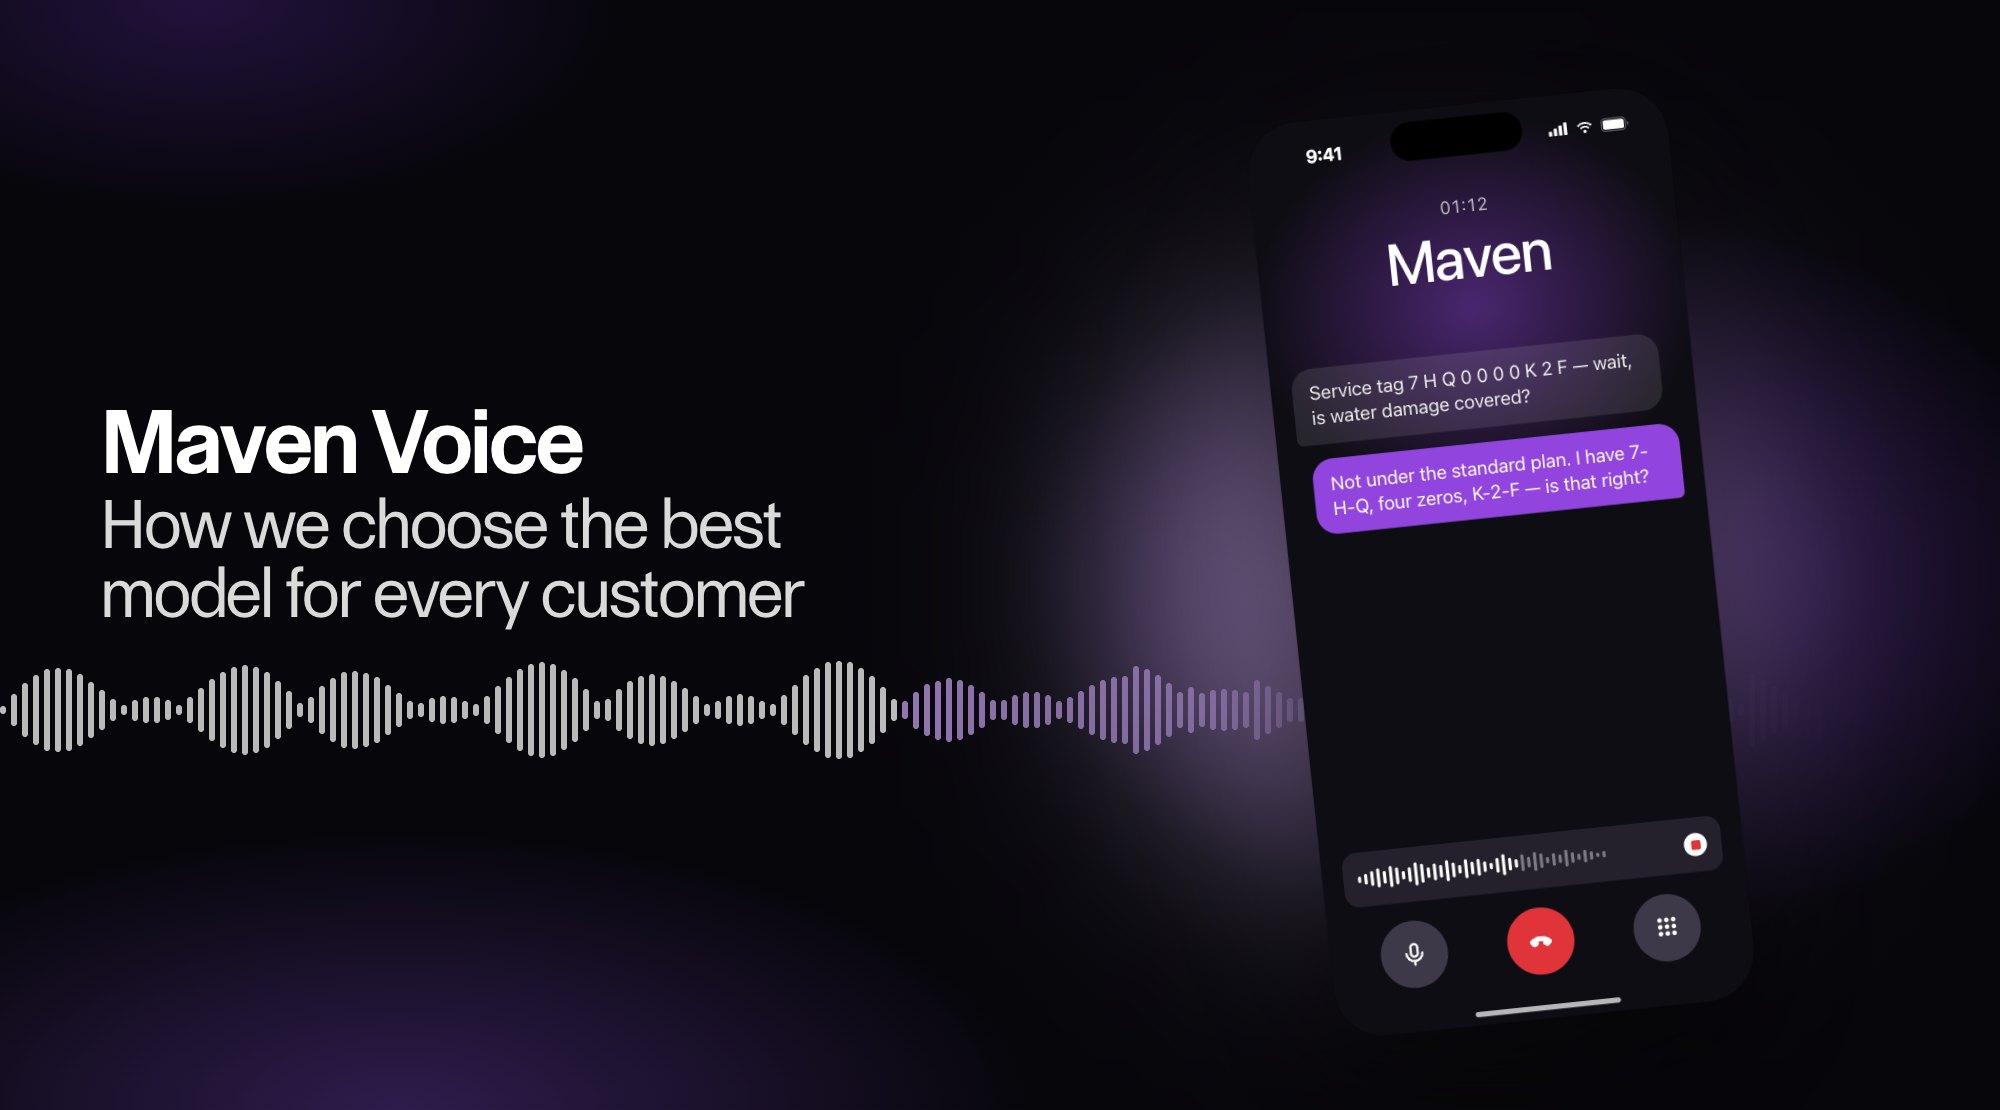
Najlepsze doświadczenia głosowe są budowane na miarę
Każde demo voice AI brzmi świetnie z głośnika laptopa. Szerokopasmowy dźwięk, cichy pokój, prezenter, który nikomu nie przerywa. Potem ten sam model trafia na produkcyjną linię telefoniczną: dźwięk zostaje ściśnięty do 8 kHz, sieć dodaje kolejne 100–200 ms opóźnienia, a prawdziwy rozmówca odczytuje 22-znakowy numer seryjny z 4 zerami z rzędu i przerywa w połowie odpowiedzi.
Ta różnica to główny powód, dla którego kanał głosowy pozostaje kanałem, którego większość przedsiębiorstw wciąż nie zautomatyzowała. Trudność nie polega na tym, by model głosowy dobrze brzmiał podczas demo, lecz na tym, by działał, gdy rozmówca przerywa, odczytuje długi identyfikator, zmienia język albo potrzebuje, by agent wykonał działanie na jego koncie. Dlatego przestaliśmy ufać publikowanym benchmarkom, w tym mierzonym we własnej aplikacji dostawcy, i opracowaliśmy sposób testowania modeli głosowych w takich warunkach, w jakich doświadczają ich klienci: podczas rozmowy telefonicznej. Najnowszym modelem, który przeszedł ten test, jest GPT-Live-1 od OpenAI.
Jak Maven podchodzi do wyboru modelu
Maven wykorzystuje zestaw najnowocześniejszych modeli do obsługi doświadczeń głosowych swoich klientów. Przypadki użycia bywają bardzo różne: wyszukiwanie kont, złożone identyfikatory, wieloetapowa diagnostyka, przerwania, wymagania językowe, specyfikacje wdrożenia czy prośby wymagające wykonania działania – dlatego model, który działa bezbłędnie u danego klienta, u innego może dawać przeciętne wyniki. Testujemy więc modele, aby wskazać najlepszy dla konkretnych przypadków użycia i kryteriów każdego klienta. Na podstawie wyników decydujemy, który model powinien prowadzić rozmowę na żywo, gdzie powinien pomóc inny model i jakie zabezpieczenia należy wbudować w dane doświadczenie.
Wybór modelu to dopiero pierwsza decyzja. Te same ramy oceny pokazują nam, gdzie dodać potwierdzanie złożonych identyfikatorów, jak zapobiegać ciszy w rozmowie i kiedy przekazać trudniejsze zadanie do silniejszej warstwy rozumowania. Celem nie jest wybór pojedynczego modelu do wszystkich zastosowań, lecz zapewnienie jak najlepszego doświadczenia klientom naszych klientów.
Ocena najlepszych modeli w Arenie
Voice Arena to powtarzalne ramy oceny modeli opracowane przez Maven. Modele kandydujące przechodzą przez prawdziwe połączenia wychodzące w publicznej sieci telefonicznej, a następnie oceniamy przebieg rozmowy z perspektywy klienta. Korzystamy z metodyki ślepej oceny parami i dostosowujemy ją do telefonii.
Każda ocena zaczyna się od tej samej karty wyników:
- Płynność konwersacji: na ile naturalnie i wyraźnie brzmi agent.
- Powrót po przerwaniu: czy agent przerywa wypowiedź, rozumie nową prośbę i na nią odpowiada.
- Rozpoznawanie identyfikatorów: czy potrafi usłyszeć i potwierdzić ciągi znaków, które rozmówcy faktycznie odczytują na głos.
- Czas do użytecznej odpowiedzi: jak długo trzeba czekać na merytoryczną odpowiedź, a nie tylko na pierwsze potwierdzenie.
- Niezawodność połączenia: czy agent kończy interakcję bez pominiętych próśb i niepotrzebnych przekazań.
Następnie dodajemy scenariusze istotne dla doświadczenia głosowego danego klienta. Firma, której infolinia obsługuje złożone numery seryjne produktów, potrzebuje innego testu obciążeniowego niż firma zajmująca się zwrotami, wizytami czy pytaniami o rozliczenia. Ramy pozostają spójne, a karty wyników są dopasowane do konkretnego wdrożenia.
W czym wyróżnił się GPT-Live-1 od OpenAI
GPT-Live-1 był szczególnie mocny w obszarze, który większość osób zauważa najpierw: w zabieraniu głosu na zmianę. Model przetwarza mowę w sposób ciągły, dzięki czemu może zareagować, gdy rozmówca wejdzie agentowi w słowo, zamiast czekać na osobny detektor zmiany tury.
Najnowszy model głosowy OpenAI przetestowaliśmy dla jednego z naszych klientów z listy Fortune 50, obsługującego miliony połączeń rocznie, na jego przypadkach użycia z obszaru wsparcia i sprzedaży. Ocena koncentrowała się na tym, jak modele radzą sobie ze złożonymi identyfikatorami produktów i długą diagnostyką, a GPT-Live-1 prowadził wśród testowanych modeli w kilku kluczowych miarach:
- 90% dokładnych powtórzeń numerów service tag – najwyższy wynik w teście.
- 100% skuteczności po przerwaniu – po każdym przerwaniu model odpowiadał na nowe pytanie.
- Mediana 1 257 ms do reakcji na nową prośbę – najszybciej spośród testowanych modeli.
- Mediana czasu odpowiedzi 1,7 s, przy czym 81% odpowiedzi pojawiało się w ciągu 2 sekund.
Model nie prowadził we wszystkich kategoriach. Dokładność powtórzeń długich numerów seryjnych wyniosła 60%, a główną słabością okazały się powtarzające się zera. Ponadto w 38% odpowiedzi rozmówcy czekali ponad 5 sekund na merytoryczną treść po wstępnym „Jasne”. To nie są powody, by odrzucić model. To właśnie te produkcyjne słabe punkty, które Arena ma ujawniać.
GPT-Live-1 jako model wiodący – lepiej niż pojedynczy model do każdej rozmowy
W tym przypadku GPT-Live-1 to przekonujący wybór do prowadzenia rozmowy: jest szybki, responsywny i wyjątkowo niezawodny, gdy rozmówca przerywa. W momentach wymagających wielu identyfikatorów lub intensywnego rozumowania system może potrzebować dodatkowej warstwy. Właśnie dlatego ten klient wybrał Maven. Budujemy doświadczenie głosowe w oparciu o dowody, zamiast wymagać od każdego klienta, by przejmował kompromisy pojedynczego modelu.
Podnieśmy razem poprzeczkę dla voice AI
Klienci: prosimy o rozmowy, które położyłyby każde demo: złożone identyfikatory, wielokrotne przerwania, wieloetapowe zadania lub wszystko, co nie może skończyć się deflekcją. Ocenimy każdy model w warunkach, z którymi faktycznie mierzą się Państwa rozmówcy.
Dostawcy modeli: jeśli chcą Państwo sprawdzić, jak Państwa model radzi sobie w prawdziwych rozmowach w przedsiębiorstwach, chętnie przetestujemy go w Arenie. Im lepsza cała branża, tym lepsze doświadczenia głosowe każdego klienta.
Przekonaj się na własnych rozmowach.
Poproś o bezpłatne, spersonalizowane demo.


