
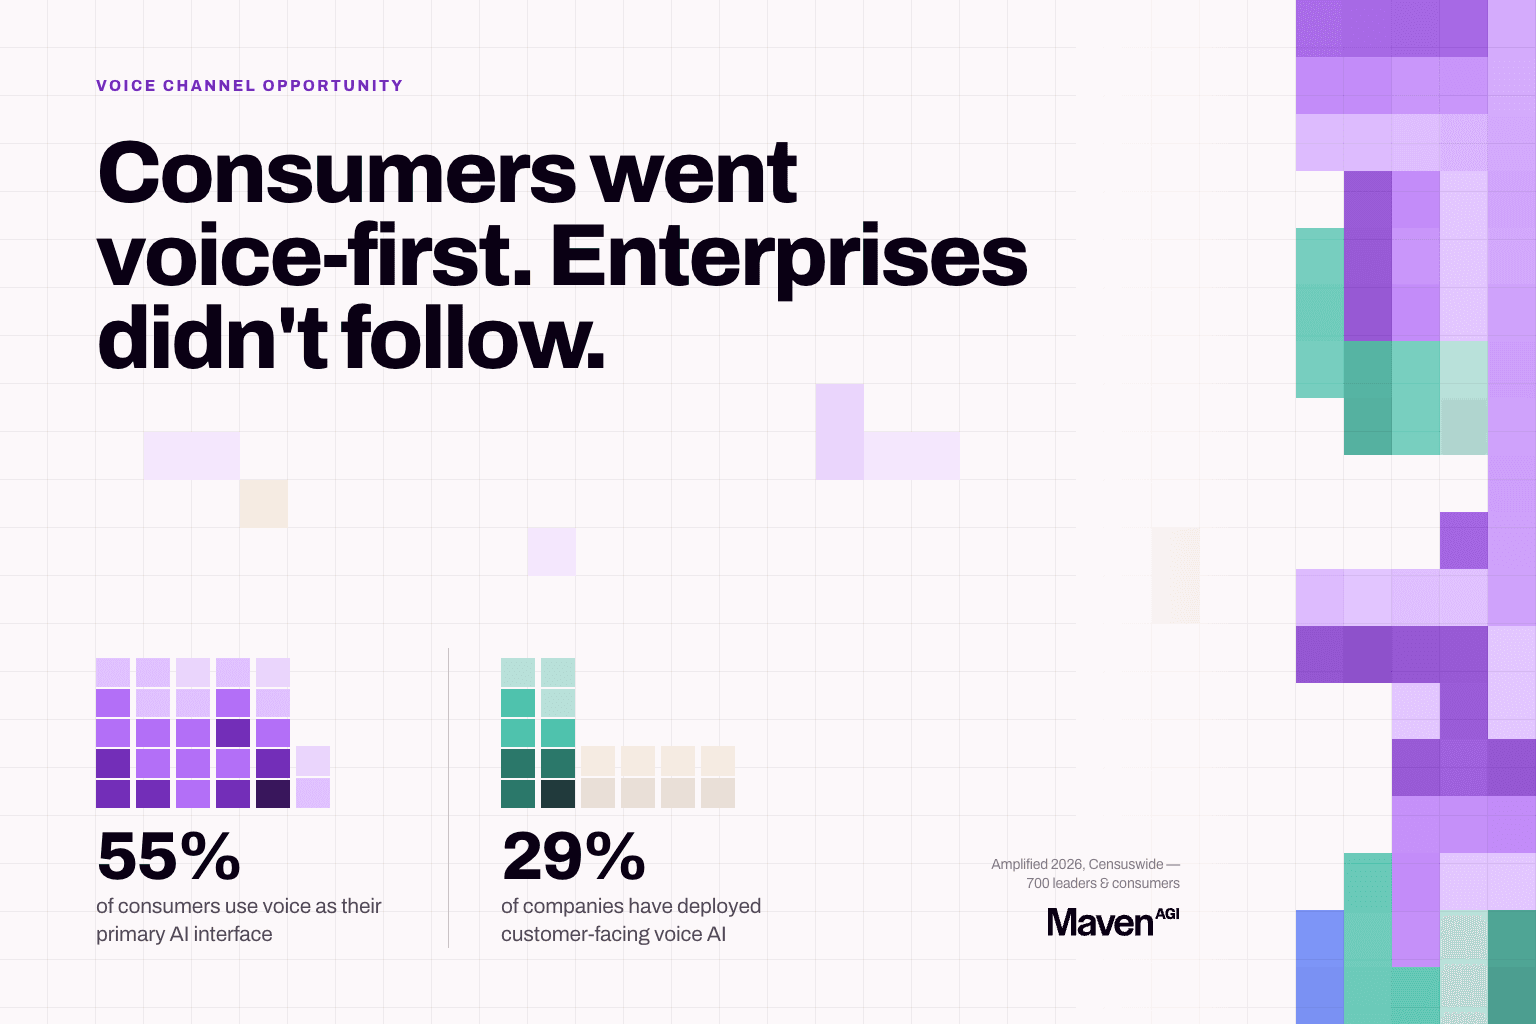
Zachowania konsumentów związane z głosem zmieniły się szybciej, niż przygotowały się na to firmy. Badanie Amplified 2026, przeprowadzone przez Censuswide wśród 700 liderów biznesu i konsumentów, wykazało, że 55% konsumentów korzysta dziś z głosu jako głównego sposobu interakcji z AI, podczas gdy tylko 29% firm wdrożyło głosową AI w kontakcie z klientem.
Głos to jednocześnie kanał o największym wolumenie, najwyższych kosztach i największych wymaganiach technicznych w obsłudze klienta – i ten, w którym wdrażanie AI pozostaje najbardziej w tyle. To nietypowe połączenie. Kanał, w którym można zaoszczędzić najwięcej, ma najmniejszą konkurencję o tę przewagę.
Głos był trudny z 3 powodów i wszystkie były realne: opóźnienia, dokładność i zgodność z przepisami. Zmieniło się to, że stały się one problemami inżynieryjnymi z gotowymi rozwiązaniami, a nie otwartymi pytaniami badawczymi.
Dlaczego opóźnienia były największym wyzwaniem
Standardowy agent głosowy łączy 3 systemy w łańcuch. Mowa jest transkrybowana na tekst, model językowy czyta tekst i pisze odpowiedź, a trzeci system ją wypowiada. Każdy etap działa dobrze osobno. Problem stanowi to, co narasta między nimi.
Każde przejście dodaje opóźnienie, a klient odczuwa ich sumę. Odpowiedź poniżej 300 ms to mniej więcej próg, przy którym rozmowa wydaje się naturalna, a po około sekundzie ciszy ludzie zaczynają znowu mówić. Łańcuch, który wciąż przetwarza pierwszą wypowiedź, ma wtedy 2 nakładające się sygnały wejściowe i żadnego dobrego sposobu, by je pogodzić.
Łańcuch traci nie tylko czas. Transkrypcja daje tekst, więc ton, wahanie, głośność i słyszalne zniecierpliwienie nie przetrwają pierwszego przejścia. Model czyta płaskie zdanie, bez żadnej wskazówki, że osoba, która je wypowiedziała, zaraz się rozłączy. Odzyskiwanie kontroli nad rozmową też jest zawodne: gdy klient przerywa albo 2 osoby mówią jednocześnie, łańcuch musi wykryć problem na jednym etapie i przekazać tę informację wstecz przez etapy, które nie zostały do tego zaprojektowane.
Dlatego tak wiele wdrożeń głosowych dobrze wypada na demo, a ma problemy we wtorkowe popołudnie. Prezentacje odbywają się w ciszy, według scenariusza i bez przerywania.
Co zmienia voice-to-voice oparte na jednym modelu
Inna architektura eliminuje przejścia. Jeden model przyjmuje dźwięk i generuje dźwięk, bez pośredniej transkrypcji na tekst i z powrotem.
Ponieważ model pracuje na dźwięku, a nie na transkrypcji, to, co łańcuch odrzucał, pozostaje dostępne. Przerwania docierają jako przerwania. Nakładająca się mowa, hałas w tle i nietypowe akcenty stają się warunkami, z którymi model sobie radzi, a nie awariami przerywającymi przekazanie danych między etapami. Bez etapów pośrednich czas reakcji skraca się na tyle, że klienci przestają mówić jednocześnie z systemem.
To właśnie mechanizm stojący za stwierdzeniem, że problem opóźnień i dokładności jest dziś rozwiązany w produkcji. Maven to pierwsza korporacyjna platforma AI, która wprowadziła agentów voice-to-voice do pełnej produkcji – co potwierdziła firma Ibex – i obsługuje 57 języków w trybie voice-to-voice oraz 54 na czacie. We wdrożeniach zmierzonych przez Maven dobrze zbudowani agenci głosowi rozwiązują porównywalne intencje na poziomie zbliżonym do czatu.
Ściślej o technologii: głos w czasie rzeczywistym działa na OpenAI Realtime API wraz z modelami głosowymi Cartesia, a agent głosowy korzysta z tego samego silnika co czat i e-mail, więc klient, który dzwoni po wysłaniu e-maila, nie musi zaczynać od nowa.
3 decyzje, które dziś wyznaczają harmonogram
Po usunięciu barier technicznych tempo wdrożenia zależy od kilku wyborów, a w każdym z nich szybsza opcja domyślna jest zwykle także bezpieczniejsza.
- Telefonia. Integracja z obecnym operatorem i infrastrukturą zamiast zmiany operatora. Migracja rzadko opłaca się na początek, a voice-to-voice łączy się z tym, z czego już Państwo korzystają, w tym z Twilio, Vonage, Cisco, Zendesk Talk i Genesys.
- IVR. Nakładka na istniejący IVR i jego rozbudowa zamiast wymiany. Wymiana daje większe możliwości, ale droga do niej jest znacznie dłuższa.
- Eskalacja. Przekazanie z pełnym kontekstem do konsultanta. Przekazanie bez kontekstu jest gorsze niż brak automatyzacji, bo klient musi wszystko wyjaśniać dwukrotnie.
Kwestia zgodności, którą głos od razu wywołuje
Podczas rozmowy klienci mówią rzeczy, których nie wolno przechowywać. Numery kart, informacje o zdrowiu, dane logowania – wszystko wypowiadane na głos podczas prośby o pomoc.
Wymogi zgodności w kanale głosowym są surowsze niż w tekście i spełnia się je wtedy, gdy platforma jest do tego zbudowana, a nie dostosowana. Kluczowa jest kwestia czasu. Redagowanie danych osobowych (PII) w czasie rzeczywistym podczas rozmowy i przetwarzanie ich po fakcie tworzą różne okna ryzyka, a tylko pierwsze rozwiązanie sprawia, że wrażliwe dane w ogóle nie trafiają do systemu. Warto ustalić, które z nich Państwo kupują, przed przeglądem bezpieczeństwa, a nie w jego trakcie.
Wielojęzyczność w głosie jest trudniejsza
Tłumaczenie tekstu działa na tyle dobrze, że większość przedsiębiorstw przestała się nim martwić. Z głosem jest inaczej. Mowa niesie różnice w akcentach, regionalne zwroty, przełączanie się między językami w połowie zdania i różne tempo mówienia, które transkrypcja spłaszcza. Łańcuch systemów potęguje ten problem, bo transkrypcja musi odgadnąć język, zanim model cokolwiek zobaczy, a błędne założenie przenosi się na każdy kolejny etap.
Deklarowany zasięg językowy warto weryfikować. Przydatne pytanie do każdego dostawcy: czy wymienione języki przetestowano w produkcji, czy po prostu figurują w opisie modelu?
Dowód przy dużym wolumenie
Przedsiębiorstwo z branży gier z listy Fortune 500, działające na rynku regulowanym, osiąga 80% rozwiązanych zgłoszeń przy ponad 330 000 interakcji miesięcznie, w tym 13 000 interakcji rozwiązanych w jednym dniu szczytowego wydarzenia.
Dni szczytowe to prawdziwy test. Przy skokach wolumenu kolejki się wydłużają, system albo wytrzymuje, albo wyraźnie słabnie, a klienci wyrabiają sobie trwałą opinię o tym, czy dzwonienie do firmy ma sens.
Jak ocenić głosową AI, nie dając się zwieść prezentacji
Nagrane demo nie jest dowodem. Warto poprosić o rozmowę na żywo i zachowywać się w niej tak, jak zachowują się Państwa klienci.
- Przerwać w pół zdania i sprawdzić, czy agent przestaje mówić
- Zmienić zdanie w połowie prośby
- Wprowadzić hałas w tle
- Mówić z akcentem, którego dostawca nie przewidział
- Poprosić o wykonanie czegoś, a nie tylko o informację
Ostatni punkt jest najważniejszy. Odpowiedź na pytanie i przeprowadzenie transakcji to różne umiejętności, a autonomiczne rozwiązywanie zgłoszeń wymaga tej drugiej.
Skrócony opis 3 decyzji zawiera Drzewo decyzyjne głosowej AI , które uzupełnia Zakres 90-dniowego pilotażu dla zespołów rozważających głos jako pierwszy automatyzowany kanał. Oba materiały opierają się na rozdziale „Szansa w kanale głosowym” z raportu State of AI in CX 2026 .
Przekonaj się na własnych rozmowach.
Poproś o bezpłatne, spersonalizowane demo.


