
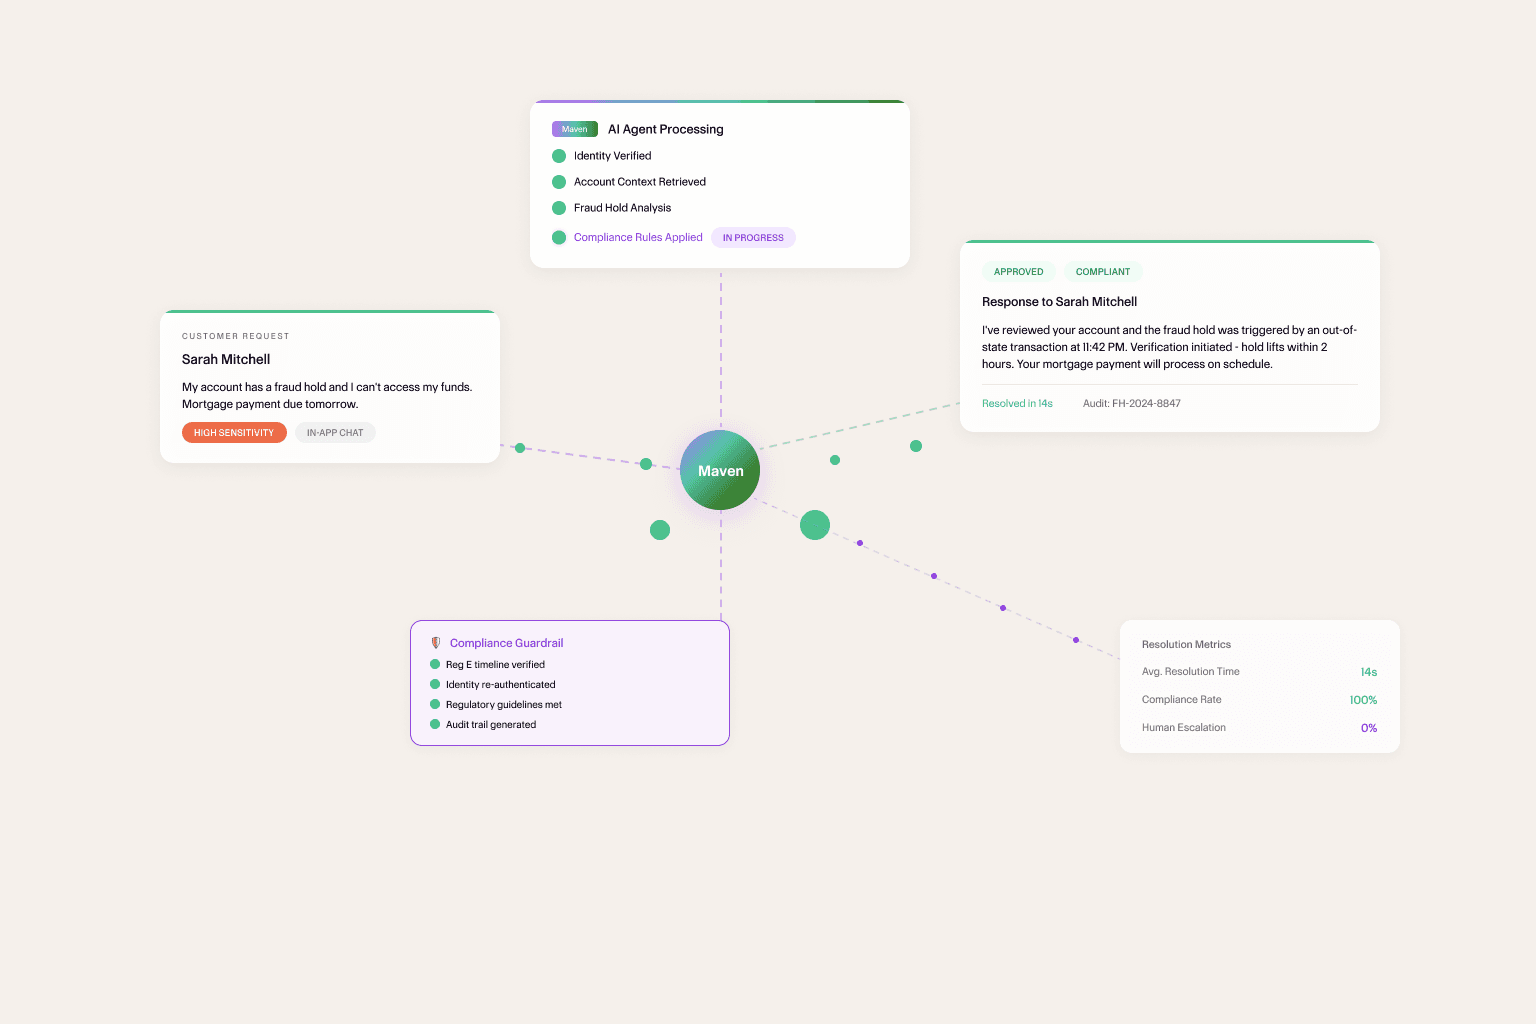
Les données financières comptent parmi les informations les plus sensibles que l'on confie à une plateforme. Les erreurs ont des conséquences réglementaires. Une mauvaise réponse sur un blocage pour suspicion de fraude ou un litige de compte mal géré ne se contente pas d'agacer un client : elle crée un risque juridique, fragilise votre conformité et génère le genre de couverture médiatique qu'il faut des années pour effacer.
Pendant la majeure partie de la dernière décennie, les équipes de support FinTech ont traité les demandes de la même manière : automatiser les cas simples, confier tout ce qui est sensible à des humains, et accepter la structure de coûts qui en découle.
Ce modèle est aujourd'hui remis en question. Non pas parce que les enjeux ont changé, mais parce que les agents IA ont suffisamment mûri pour que l'intervention humaine ne soit plus le seul moyen de traiter en toute sécurité des interactions complexes et très sensibles. La question n'est plus de savoir s'il faut automatiser, mais comment concevoir l'automatisation pour qu'elle soit réellement digne de confiance.
Le problème des données FinTech est structurel
Tous les secteurs manipulent des données sensibles. Dans la FinTech, le problème est particulièrement aigu en raison de la structure même des données et du nombre d'acteurs qui y ont des droits légitimes mais distincts.
Prenons une plateforme qui sert à la fois des titulaires de comptes professionnels et leurs employés. Le dirigeant de l'entreprise a une visibilité complète. Un employé titulaire d'une carte ne voit que l'activité de sa propre carte. Tous deux sont des utilisateurs authentifiés de la même plateforme. Tous deux peuvent poser des questions similaires — pourquoi cette transaction a-t-elle été refusée ? — mais les données que chacun est autorisé à consulter, et les actions que chacun est autorisé à effectuer, sont fondamentalement différentes.
Ajoutez un troisième niveau : la plateforme elle-même, avec ses équipes opérationnelles internes, ses fonctions conformité et ses analystes fraude, qui ont chacun besoin d'accéder aux données de compte selon des règles totalement différentes.
Il ne s'agit pas d'un cas limite théorique. C'est le mode de fonctionnement standard des plateformes de banque professionnelle, des plateformes de crédit, des outils de gestion des dépenses et des fournisseurs d'infrastructures de paiement. L'environnement de données est partagé. Les règles d'accès, elles, ne le sont pas.
Lorsque des agents IA arrivent dans cet environnement avec un accès étendu et sans règles d'éligibilité strictes au niveau de chaque participant, le risque de contamination croisée est considérable. Non pas parce que l'agent est malveillant, mais parce qu'il fait exactement ce pour quoi il a été conçu : trouver l'information la plus pertinente et l'utiliser pour répondre à la question.
Le problème, c'est que pertinent et autorisé ne veulent pas dire la même chose.
Quand l'IA FinTech se trompe
Dans la FinTech, les défaillances sont des versions plus lourdes de conséquences des schémas que l'on retrouve sur toute plateforme multi-acteurs.
Risque réglementaire. L'accès aux données financières est encadré par des réglementations qui imposent la minimisation des données, la limitation des finalités, le consentement et l'auditabilité. Un agent qui expose des données de compte à un utilisateur non autorisé ne crée pas seulement un incident de support, mais un potentiel manquement à la conformité. « Le modèle a jugé l'information pertinente » n'est pas une réponse qui satisfait un régulateur.
Confiance des titulaires de comptes. Les services financiers reposent sur la confiance plus que la plupart des secteurs. Dès qu'un utilisateur commence à se demander ce que la plateforme sait d'autre sur lui, et qui d'autre peut le voir, vous avez créé un problème qu'aucun score CSAT ne mesure.
Violations du contrôle d'accès interne. Les analystes fraude obéissent à des règles d'accès différentes de celles du support client. Les équipes conformité n'ont pas le même périmètre que les chargés de compte. Un agent IA qui intervient sur l'ensemble de ces fonctions sans contrôles d'éligibilité explicites fondés sur les rôles devient un vecteur de violations d'accès internes.
Erreurs sur des décisions à fort enjeu. Les interactions où les agents IA sont les plus utiles — litiges pour fraude, échecs de paiement, restrictions de compte — sont aussi celles où une erreur a le plus de conséquences. Un client qui agit sur la base d'informations erronées concernant la procédure de résolution d'un litige pour fraude crée en aval une responsabilité que la plateforme doit ensuite assumer.
La remise à plat en cours
Les plateformes FinTech qui mènent ce changement d'architecture ne renoncent pas à l'automatisation. Elles dissocient deux éléments historiquement liés : la capacité de raisonnement de l'agent IA et son accès aux données.
Le constat est simple. La capacité d'un agent IA à comprendre le contexte, à saisir les nuances et à gérer des interactions complexes ne dépend pas d'un accès à tout. Elle dépend d'un accès aux bonnes informations pour le contexte dans lequel il opère.
Cela conduit à un principe d'architecture qui paraît évident a posteriori : définir ce qui est éligible avant que l'agent ne récupère quoi que ce soit.
Concrètement, chaque interaction commence par l'établissement du contexte — canal, utilisateur authentifié, rôle et cadre de règles applicables. À partir de ces éléments, la plateforme détermine quelles données sont dans le périmètre et quelles actions sont autorisées. L'agent opère ensuite dans ce périmètre avec toute sa capacité de raisonnement.
Un titulaire de compte professionnel qui s'interroge sur l'activité de la carte d'un collaborateur voit ce qu'il est autorisé à voir. Un employé titulaire d'une carte qui pose la même question ne voit que ses propres données. Un analyste conformité qui mène une revue opère selon des règles d'accès adaptées à la conformité. Même agent IA. Mêmes capacités sous-jacentes. Des contextes d'éligibilité différents, appliqués au niveau de l'architecture, avant que l'agent ne raisonne sur quoi que ce soit.
Cette approche apporte trois bénéfices concrets qui comptent dans la FinTech.
Auditabilité. Lorsque chaque interaction est délimitée par des règles d'éligibilité explicites, vous disposez d'une trace claire des données accessibles à l'agent pour chaque interaction. « À quelles données l'agent a-t-il accédé ? » devient une question à laquelle vous pouvez répondre avec précision, et non approximativement — exactement ce qu'exige une enquête réglementaire.
Application cohérente du contrôle d'accès. La couche d'éligibilité ne dépend pas de la capacité de l'agent à se souvenir de ses instructions ou à déduire correctement le contexte. Elle est appliquée de façon structurelle, et donc de manière cohérente à chaque interaction, à chaque cas limite, à chaque requête inhabituelle.
Une conformité qui passe à l'échelle. Lorsque de nouvelles réglementations arrivent — et dans la FinTech, elles arrivent toujours —, la mise à jour des règles d'éligibilité dans la couche d'architecture se propage immédiatement à toutes les interactions IA. Pas besoin de réécrire les prompts ni de réentraîner les systèmes. Les règles s'appliquent partout, automatiquement.
Le jugement humain ne disparaît pas
Une chose ne change pas avec cette nouvelle architecture : certaines interactions appellent un jugement humain, et un système d'IA bien conçu permet d'y parvenir facilement.
Dans la FinTech, ces moments sont prévisibles. Un client qui conteste une décision de fraude déjà examinée par la plateforme. Un titulaire de compte professionnel qui remet en cause un blocage pour raisons de conformité. Un client à forte valeur avec une question complexe portant sur plusieurs produits et nécessitant des arbitrages sur les règles d'exception.
Dans ces interactions, Agent Maven prend en charge la recherche d'informations et la reconstitution du contexte : il met rapidement le conseiller au courant, fait remonter l'historique pertinent et signale les questions clés à trancher, tout en laissant la décision finale et la communication entre des mains humaines.
L'escalade n'est pas une défaillance. C'est une fonctionnalité prévue d'une architecture de support IA mature. La concevoir de façon délibérée, avec des déclencheurs clairs, des transferts fluides et un contexte complet transmis au conseiller, c'est ce qui distingue les déploiements d'IA qui résistent à l'examen de ceux qui provoquent des incidents précisément quand les enjeux sont les plus élevés.
De la réduction des coûts à une infrastructure de confiance
Au départ, l'IA dans le support FinTech était presque entièrement envisagée sous l'angle des coûts — taux de déflexion, réduction des tickets, heures de conseillers économisées. Ces indicateurs sont réels et importants, mais ils ne reflètent qu'une partie des enjeux.
Les plateformes FinTech qui tirent la valeur la plus durable de l'IA ne cherchent pas avant tout à réduire leurs coûts. Elles construisent quelque chose de plus difficile à reproduire : une infrastructure de support à laquelle chaque groupe de participants — clients, titulaires de comptes, clients professionnels, équipes internes — peut faire confiance pour traiter ses données de manière appropriée et ses interactions de manière cohérente.
C'est un objectif de conception différent de la déflexion, qui exige une architecture différente. Une architecture où le contrôle d'accès n'est pas ajouté après coup à un modèle performant, mais constitue une couche fondatrice sur laquelle reposent les capacités du modèle.
Les plateformes qui investissent dès maintenant dans cette architecture ne se contentent pas de résoudre le problème actuel de gouvernance de l'IA. Elles bâtissent une infrastructure qui rend chaque future capacité d'IA digne de confiance par défaut, car la couche d'éligibilité qui encadre l'agent de support d'aujourd'hui encadrera aussi celui, plus performant, de demain.
Dans la FinTech, la confiance n'est pas une fonctionnalité. C'est le produit.
Voyez-le à l’œuvre sur vos propres conversations.
Demandez une démo personnalisée gratuite.


