
La conception de la plupart des agents IA repose sur un postulat rarement remis en question : si une donnée est pertinente pour répondre à une question, l'agent doit pouvoir l'utiliser.
Cela semble logique, mais c'est faux.
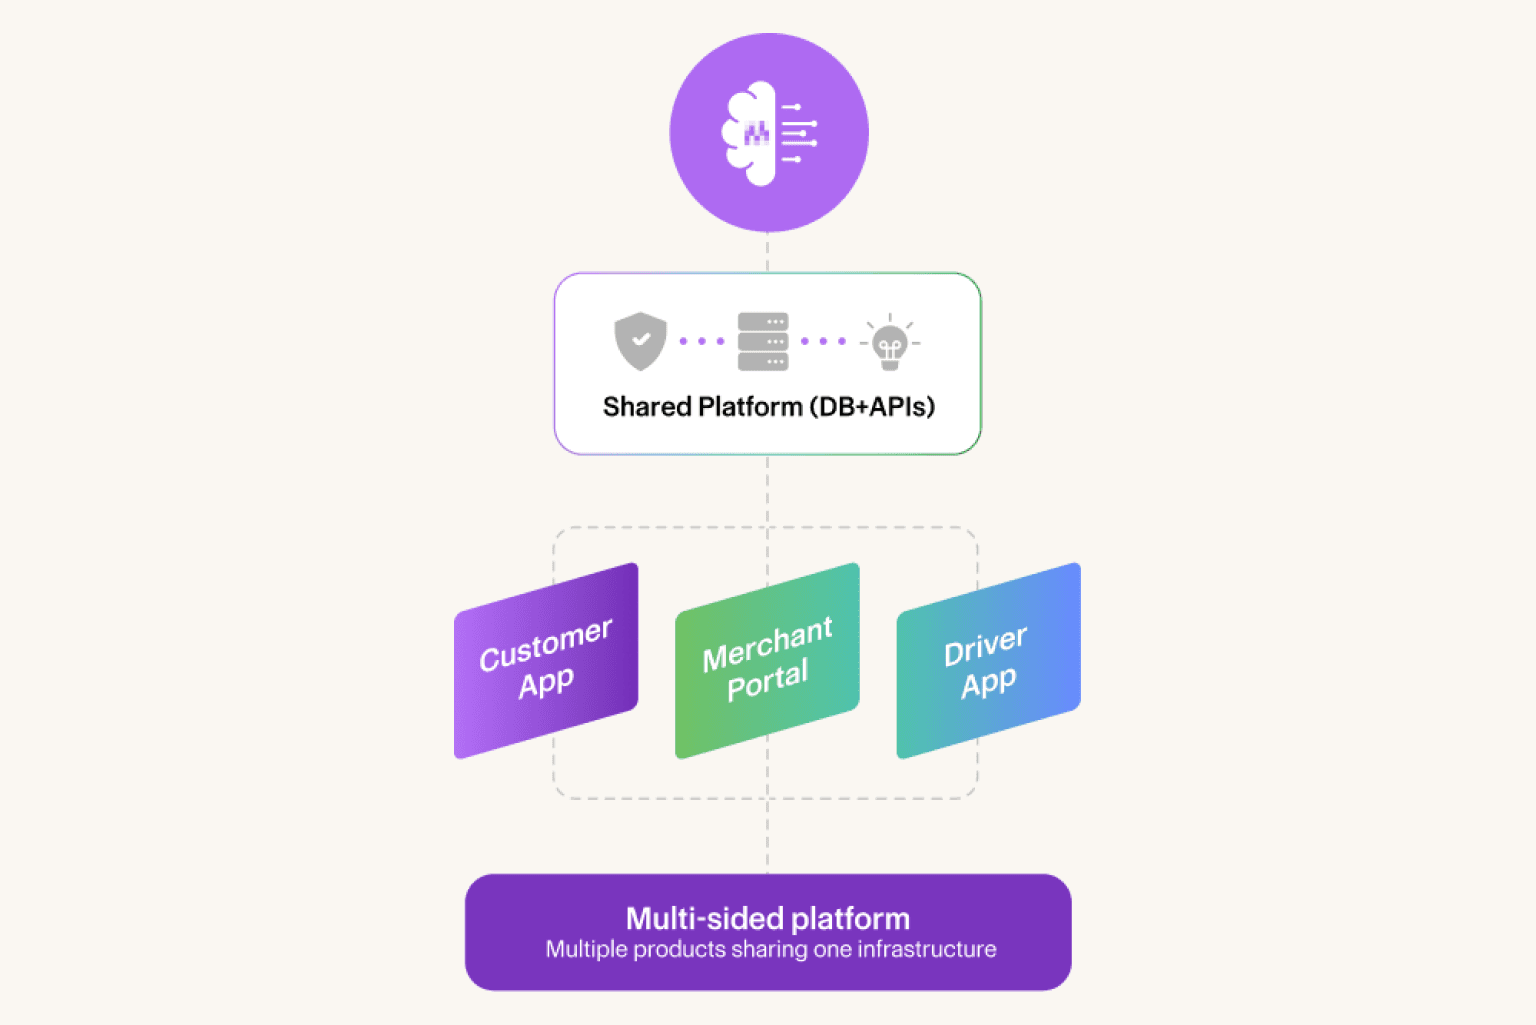
Pour les organisations qui exploitent des plateformes réunissant plusieurs groupes de participants (clients et marchands, passagers et chauffeurs, clients et prestataires), c'est précisément ce postulat qui transforme insidieusement les déploiements d'IA en problèmes de confiance.
Le piège de la pertinence
Un client contacte le support au sujet d'une livraison en retard. Il veut savoir ce qui s'est passé et demande un remboursement.
Les informations les plus pertinentes comprennent les temps de préparation moyens du restaurant, le délai de préparation de cette commande précise, l'historique d'itinéraire du livreur et les alertes éventuellement apparues pendant l'exécution. Tout cela est directement utile et permet une réponse meilleure et plus précise.
Mais cela exposerait aussi les données de performance opérationnelle d'un restaurant à un client qui n'a aucune raison de les voir. Cela mettrait en cause le comportement d'un livreur sans procédure contradictoire. Cela établirait un lien direct entre le résultat obtenu par une partie et les données d'une autre, à l'insu et sans le consentement de l'une comme de l'autre.
L'agent n'a commis aucune erreur : il a fait exactement ce pour quoi il a été conçu, trouver ce qui est pertinent et l'utiliser. L'erreur a été de supposer que pertinence et autorisation sont une seule et même chose.
Pourquoi cette distinction est plus délicate qu'il n'y paraît
Sur un produit à une seule face, pertinence et autorisation coïncident en grande partie. L'utilisateur qui pose la question est aussi la personne dont les données sont concernées. L'écart entre ce qui est utile et ce qui est autorisé est suffisamment étroit pour que la plupart des agents s'en accommodent sans incident.
Les plateformes multifaces font totalement voler ce postulat en éclats.
Chaque groupe de participants a ses propres données, workflows, attentes en matière de confidentialité et sa propre définition d'un résultat équitable. Lorsqu'un agent IA intervient auprès de tous à partir d'une base de connaissances commune, il n'évolue pas dans un seul environnement de données, mais dans plusieurs à la fois, sans frontières étanches entre eux.
Trois modes de défaillance apparaissent systématiquement :
Fuite de données entre interfaces. Une information pertinente sur une interface appartient à un participant d'une autre interface. Un agent côté client qui a accès à l'historique des litiges d'un marchand, un portail marchand qui affiche le détail des réclamations des clients, ou une interface chauffeur qui fait référence à des données de sanctions propres à la plateforme.
Des actions aux conséquences non contrôlées ailleurs. Un remboursement accordé sur l'interface client déclenche une retenue sur le versement côté marchand. Un agent IA capable d'effectuer la première action sans voir la seconde conséquence prendra des décisions apparemment raisonnables qui créent des problèmes auxquels il ne sera jamais confronté. La boucle de rétroaction ne se referme pas.
Un traitement incohérent selon le groupe de participants. La même question de fond (pourquoi mon paiement a-t-il été réduit ?) n'a pas du tout le même sens selon qu'elle est posée par un marchand ou par un chauffeur. Les données accessibles, la réponse appropriée et les actions autorisées diffèrent. Un agent sans frontières strictes entre interfaces produit des réponses techniquement exactes mais inadaptées au contexte.
Aucune de ces défaillances n'est imputable à l'agent IA : ce sont des défaillances d'architecture. Personne n'a jamais indiqué à l'agent où se trouvaient les limites.
La pertinence est un point de départ, pas une autorisation
Voici le changement de perspective essentiel : la pertinence doit orienter ce que l'agent recherche, mais l'éligibilité doit déterminer ce à quoi il peut réellement accéder.
Deux questions distinctes, traitées l'une après l'autre.
L'éligibilité vient en premier. Avant que l'agent ne récupère quoi que ce soit, la plateforme doit déjà avoir répondu à plusieurs questions : de quelle interface provient cette interaction ? Quel groupe de participants est authentifié ? Quelles données et quelles actions sont accessibles pour cette interface, ce rôle, ce contexte de règles ? Qu'est-ce qui est strictement interdit, quelle que soit sa pertinence ?
Ce ne sont pas des questions que le modèle doit trancher par raisonnement. Ce sont des contraintes que la plateforme applique de façon déterministe, avant même que l'agent ne démarre. La pertinence s'exerce ensuite à l'intérieur de ces contraintes, et non à leur place.
L'effet concret est considérable. Un agent cantonné à l'interface client ne peut pas exposer par inadvertance des données marchands. Non pas parce qu'on lui a demandé de ne pas le faire, mais parce que ces données n'ont jamais été éligibles. Une instruction dans un prompt peut être contournée par le raisonnement. Une contrainte d'éligibilité, non.
Cette distinction compte plus qu'il n'y paraît. « Ne devrait pas utiliser » et « ne peut pas accéder » n'offrent pas le même niveau de protection. À grande échelle, dans des environnements complexes, face à de vrais cas limites, seul le second tient.
Ce que cela signifie en pratique
Les plateformes qui font les bons choix ne conçoivent pas des agents plus restrictifs : elles conçoivent des agents mieux architecturés. La capacité de raisonnement de l'agent reste inchangée ; ce qui change, c'est le socle sur lequel il raisonne.
Le résultat n'est pas un agent moins performant. C'est un agent digne de confiance pour tous les groupes de participants à la fois. Sur les plateformes multifaces, c'est cette capacité-là qui permet de passer à l'échelle.
La pertinence vous mène à une bonne réponse. L'éligibilité vous mène à une réponse digne de confiance.
Voyez-le à l’œuvre sur vos propres conversations.
Demandez une démo personnalisée gratuite.


