
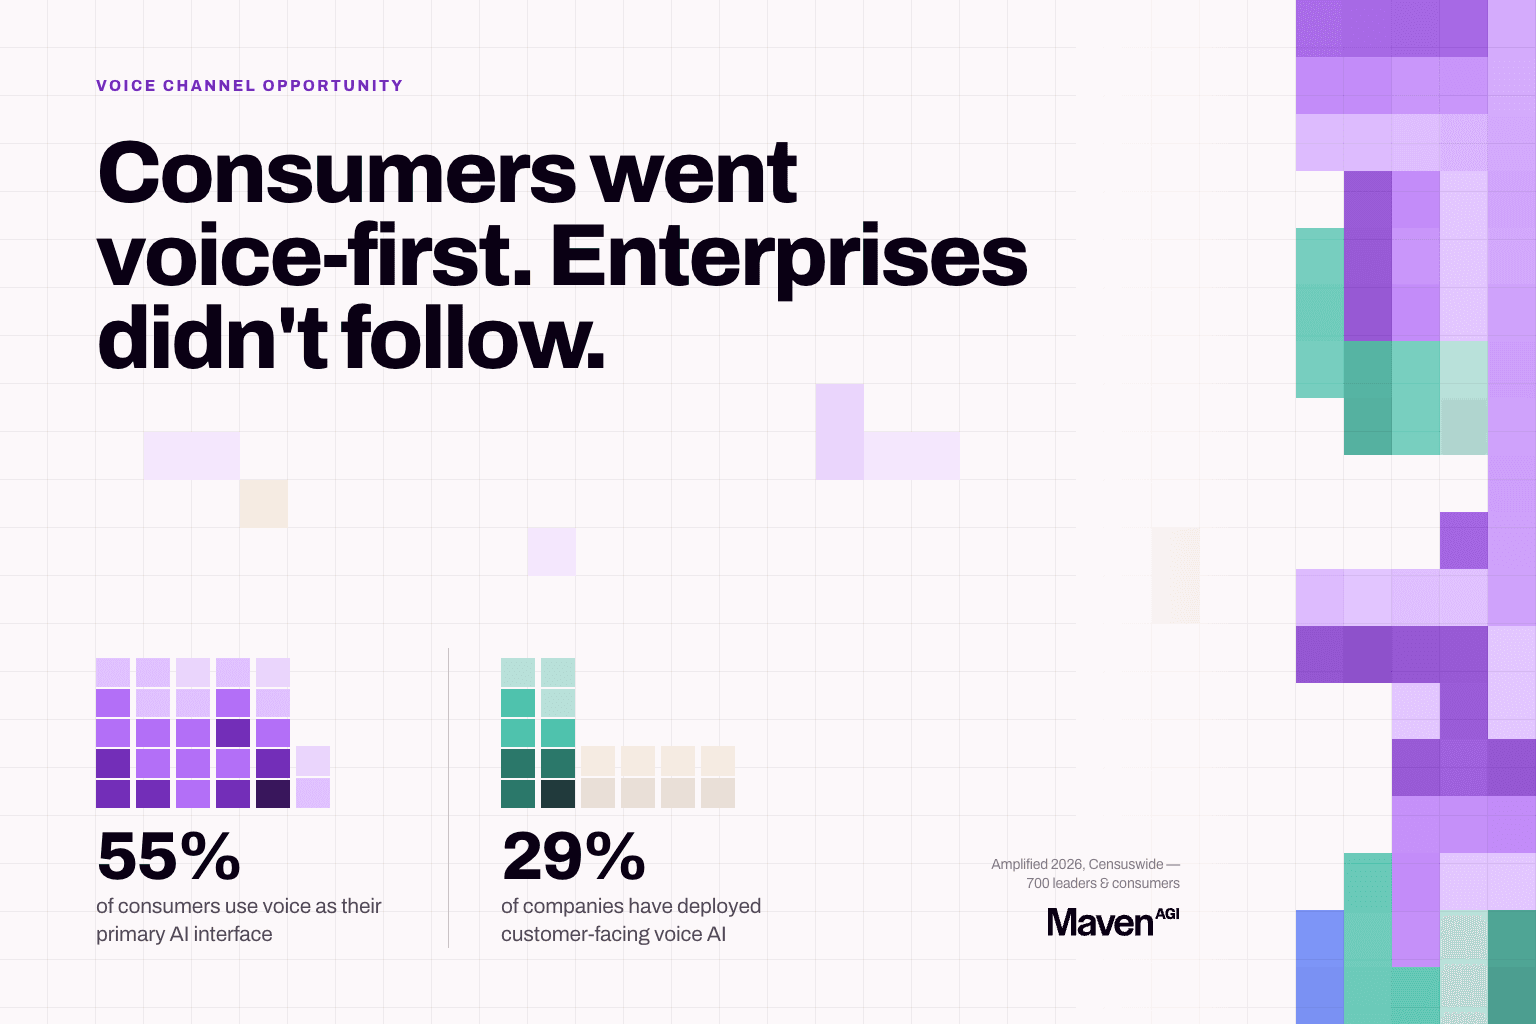
Konsumenternas beteende kring röst har förändrats snabbare än företagens beredskap. Amplified 2026, en Censuswide-undersökning bland 700 företagsledare och konsumenter, visade att 55 % av konsumenterna nu använder röst som sitt främsta gränssnitt för AI-interaktioner, medan bara 29 % av företagen har driftsatt kundnära röst-AI.
Röst är på samma gång den kanal inom kundservice som har störst volym, högst kostnad och högst tekniska krav – och den där AI-användningen ligger längst efter. Den kombinationen är ovanlig. Kanalen med mest kostnad att ta bort har minst konkurrens om fördelen.
Röst var svårt av 3 skäl, och alla 3 var verkliga: latens, precision och regelefterlevnad. Det som har förändrats är att de har blivit tekniska problem med kända lösningar snarare än öppna forskningsfrågor.
Varför latensen var det svåra
Standardsättet att bygga en röstagent kedjar ihop 3 system. Talet transkriberas till text, en språkmodell läser texten och skriver ett svar, och ett tredje system läser upp det. Varje steg fungerar bra för sig. Problemet är det som ackumuleras mellan dem.
Varje steg lägger till fördröjning, och det kunden upplever är summan. Svarstider under 300 ms är ungefär gränsen för att ett samtal ska kännas naturligt, och efter ungefär 1 sekunds tystnad börjar folk prata igen. En pipeline som fortfarande bearbetar det första yttrandet har då 2 överlappande indata och inget smidigt sätt att förena dem.
Kedjan förlorar mer än tid. Transkriberingen producerar text, så tonläge, tvekan, ljudnivå och det hörbara ljudet av någon som håller på att tappa tålamodet överlever inte det första steget. Modellen läser en platt mening utan någon antydan om att personen som sa den är på väg att lägga på. Återhämtningen är också skör: när en kund avbryter eller 2 personer pratar samtidigt måste pipelinen upptäcka problemet i ett steg och föra den kunskapen bakåt genom steg som aldrig utformats för att ta emot den.
Det är därför så många röstlösningar fungerar bra i en demo men får problem en vanlig tisdagseftermiddag. Demos är tysta, manusstyrda och fria från avbrott.
Vad voice-to-voice med en enda modell förändrar
En annan arkitektur tar bort stegen. En enda modell tar emot ljud och producerar ljud, utan transkribering till text och tillbaka däremellan.
Eftersom modellen arbetar med ljud i stället för en transkription finns det som pipelinen kastade bort kvar. Avbrott uppfattas som avbrott. Överlappande tal, bakgrundsljud och obekanta accenter blir förhållanden som modellen hanterar snarare än feltillstånd som bryter en överlämning. Utan mellanliggande steg krymper svarsglappet så mycket att kunderna slutar prata i mun på systemet.
Det är mekanismen bakom påståendet att latens och precision nu är lösta i produktion. Maven är den första AI-plattformen för storföretag som har tagit voice-to-voice-agenter i full produktion, något som bekräftats av Ibex, och kör 57 språk i voice-to-voice och 54 i chatt. I de driftsättningar Maven har mätt når välbyggda röstagenter en lösningsgrad i samma spann som chatt för jämförbara ärendetyper.
För att vara exakt om stacken: realtidsröst körs på OpenAI Realtime API tillsammans med röstmodeller från Cartesia, och röstagenten använder samma motor som chatt och e-post, så en kund som ringer efter att ha mejlat behöver inte börja om.
De 3 beslut som nu avgör din tidslinje
När de tekniska hindren är hanterade handlar driftsättningstakten om ett fåtal val, och i varje fall tenderar det snabbare standardvalet också att vara det säkrare.
- Telefoni. Integrera med din befintliga operatör och stack i stället för att byta operatör. En migrering är sällan värd att göra först, och voice-to-voice ansluter till det du redan kör, inklusive Twilio, Vonage, Cisco, Zendesk Talk och Genesys.
- IVR. Bygg ovanpå och komplettera den befintliga IVR:en i stället för att riva ut och ersätta den. Ett byte har ett högre tak men en mycket längre väg dit.
- Eskalering. Använd en varm överlämning som för över hela kontexten till den mänskliga handläggaren. En kall överlämning utan kontext är värre än ingen automatisering alls, eftersom kunden får förklara allt 2 gånger.
Efterlevnadsfrågan som röst väcker direkt
I ett samtal säger kunder saker du inte får lagra. Kortnummer, hälsouppgifter, inloggningsuppgifter – allt sagt högt medan de ber om hjälp.
Kraven på regelefterlevnad är striktare för röst än för text, och de uppfylls när plattformen är byggd för det snarare än anpassad i efterhand. Frågan som spelar roll är tidpunkten. Maskering av personuppgifter (PII) i realtid under samtalet och efterbearbetning i efterhand skapar olika exponeringsfönster, och bara det första håller den känsliga informationen borta från pipelinen. Fråga vilket av dem du köper före säkerhetsgranskningen, inte under den.
Flerspråkighet blir svårare i röst
Textöversättning är tillräckligt löst för att de flesta storföretag har slutat oroa sig för den. Röst är inte likvärdigt. Talat språk rymmer accentvariationer, regionala uttryck, språkväxling mitt i meningen och skillnader i tempo som en transkription plattar till. En kedjad pipeline förvärrar detta, eftersom transkriberingen måste gissa språket innan modellen ser något, och en felaktig gissning sprider sig genom varje efterföljande steg.
Det är värt att granska uppgifter om språktäckning. Den användbara följdfrågan till varje leverantör är om de listade språken har testats i produktion eller bara står i ett modellkort.
Bevis i stor skala
Ett Fortune 500-företag inom spel som verkar på en reglerad marknad har 80 % lösningsgrad över mer än 330 000 interaktioner per månad, inklusive 13 000 interaktioner som löstes under en enda toppdag i samband med ett evenemang.
Toppdagar är det ärliga testet. Det är vid volymtoppar som köerna sväller, som ett system antingen håller eller tydligt försämras, och som kunderna bildar sig en bestående uppfattning om huruvida det lönar sig att ringa dig.
Så utvärderar du röst utan att bländas av en demo
Inspelade demos är inga bevis. Be om ett livesamtal, och bete dig under samtalet som dina kunder gör.
- Avbryt mitt i en mening och se om agenten slutar prata eller fortsätter
- Ändra dig halvvägs genom en förfrågan
- Lägg till bakgrundsljud
- Prata med en accent som leverantören inte har planerat för
- Be den göra något, inte bara berätta något
Den sista väger tyngst. Att svara på en fråga och att slutföra en transaktion är olika förmågor, och autonom lösning kräver den andra.
De 3 besluten i kortform finns i The Voice AI Decision Tree , som kompletterar The 90-Day Pilot Scope för team som överväger röst som sin första automatiserade kanal. Båda bygger på kapitlet Voice Channel Opportunity i rapporten State of AI in CX 2026 .
Se det på dina egna konversationer.
Begär en kostnadsfri, personlig demo.


