
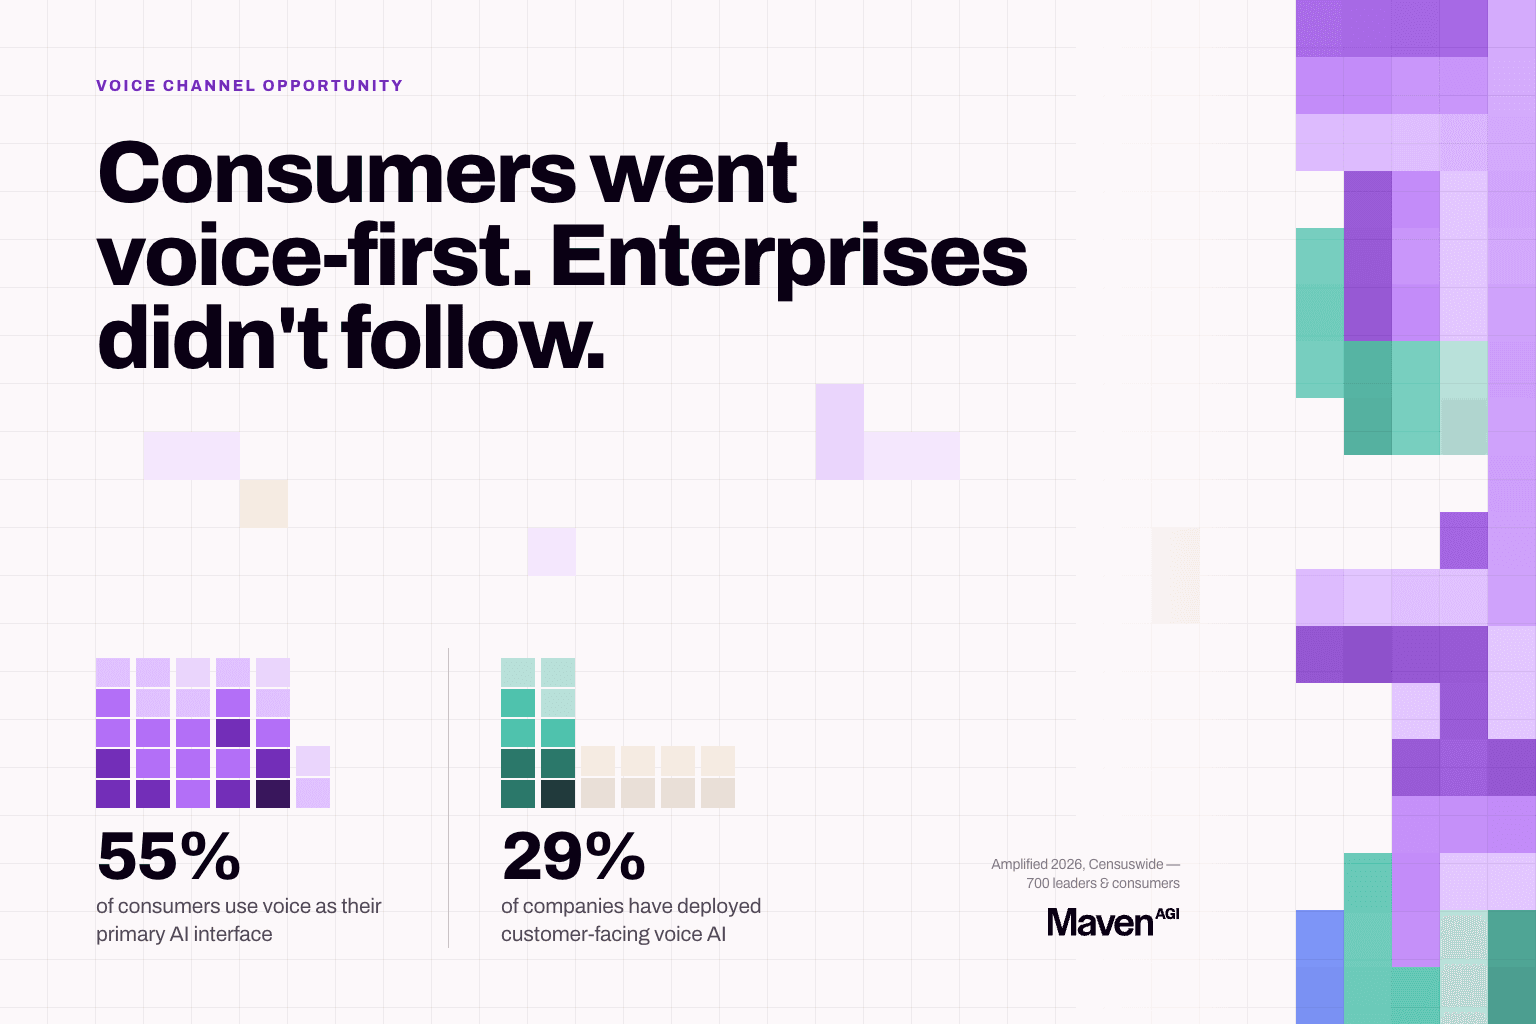
El comportamiento de los consumidores con la voz avanzó más rápido que la preparación de las empresas. Amplified 2026, una encuesta de Censuswide a 700 líderes empresariales y consumidores, reveló que el 55 % de los consumidores ya usa la voz como interfaz principal para interactuar con la IA, mientras que solo el 29 % de las empresas ha desplegado IA de voz de cara al cliente.
La voz es a la vez el canal con más volumen, más costo y más exigencia técnica de la atención al cliente, y también el que más retraso acumula en la adopción de IA. Esa combinación es poco habitual. El canal donde más costo se puede eliminar es el que menos competencia tiene por esa ventaja.
3 barreras hacían difícil la voz, y las 3 eran reales: latencia, precisión y cumplimiento normativo. Lo que ha cambiado es que se han convertido en problemas de ingeniería con solución, en lugar de preguntas de investigación abiertas.
Por qué la latencia era la más difícil
La forma habitual de crear un agente de voz encadena 3 sistemas. La voz se transcribe a texto, un modelo de lenguaje lee el texto y redacta una respuesta, y un tercer sistema la pronuncia en voz alta. Cada etapa funciona bien por separado. El problema es lo que se acumula entre ellas.
Cada salto añade retraso, y lo que percibe el cliente es el total. Una respuesta de menos de 300 ms es más o menos el umbral para que una llamada se sienta como una conversación, y a partir de 1 segundo de silencio la gente vuelve a hablar. Un pipeline que todavía procesa la primera intervención se encuentra entonces con 2 entradas solapadas y ninguna forma limpia de conciliarlas.
La cadena pierde algo más que tiempo. La transcripción genera texto, así que el tono, las dudas, el volumen y el sonido de alguien que pierde la paciencia no sobreviven al primer salto. El modelo lee una frase plana sin ningún indicio de que quien la dijo está a punto de colgar. La recuperación también es frágil, porque cuando un cliente interrumpe o 2 personas hablan a la vez, el pipeline tiene que detectar el problema en una etapa y transmitirlo hacia atrás a etapas que nunca se diseñaron para recibirlo.
Por eso tantos despliegues de voz funcionan bien en una demo y tienen problemas un martes por la tarde. Las demos son silenciosas, guionizadas y sin interrupciones.
Qué cambia la voz a voz con un solo modelo
Una arquitectura distinta elimina los saltos. Un único modelo recibe audio y produce audio, sin pasar por texto y volver.
Como el modelo trabaja con sonido y no con una transcripción, lo que el pipeline descartaba sigue disponible. Las interrupciones llegan como interrupciones. Las voces solapadas, el ruido de fondo y los acentos poco habituales pasan a ser condiciones que el modelo gestiona, no estados de fallo que rompen un traspaso. Sin etapas intermedias, el tiempo de respuesta se reduce lo suficiente como para que los clientes dejen de hablar por encima del sistema.
Ese es el mecanismo detrás de la afirmación de que la latencia y la precisión ya están resueltas en producción. Maven es la primera plataforma de IA empresarial en llevar agentes de voz a voz a plena producción, una distinción validada por Ibex, y opera en 57 idiomas en voz a voz y en 54 en chat. En los despliegues que Maven ha medido, los agentes de voz bien construidos resuelven en el mismo rango que el chat para intenciones comparables.
Para precisar el stack: la voz en tiempo real funciona con la OpenAI Realtime API junto con los modelos de voz de Cartesia, y el agente de voz usa el mismo motor que el chat y el email, así que un cliente que llama después de enviar un email no tiene que empezar de cero.
Las 3 decisiones que ahora determinan tu plazo
Con las barreras técnicas resueltas, la velocidad de despliegue depende de un número reducido de decisiones, y en cada caso la opción más rápida suele ser también la más segura.
- Telefonía. Intégrate con tu operador y tu stack actuales en lugar de cambiar de operador. Rara vez compensa empezar por una migración, y la voz a voz se conecta a lo que ya utilizas, incluidos Twilio, Vonage, Cisco, Zendesk Talk y Genesys.
- IVR. Superpón y amplía el IVR existente en lugar de desmontarlo y sustituirlo. La sustitución tiene un techo más alto y un camino mucho más largo.
- Escalado. Usa un traspaso con contexto que transmita toda la información al agente. Un traspaso sin contexto es peor que no automatizar nada, porque el cliente lo explica todo 2 veces.
La pregunta de cumplimiento que plantea la voz de inmediato
En una llamada, los clientes dicen cosas que no puedes almacenar. Números de tarjeta, datos de salud, credenciales de cuenta, todo dicho en voz alta mientras piden ayuda.
El cumplimiento normativo en voz es más estricto que en texto, y se resuelve cuando la plataforma está diseñada para ello, no adaptada a ello. La cuestión clave es el momento. La anonimización de datos personales en tiempo real durante la llamada y el posprocesamiento posterior crean ventanas de exposición distintas, y solo la primera mantiene la información sensible fuera del pipeline. Pregunta cuál de las 2 estás comprando antes de la revisión de seguridad, no durante ella.
El multilingüismo se complica en voz
La traducción de texto está lo bastante resuelta como para que la mayoría de las empresas haya dejado de preocuparse por ella. La voz no es equivalente. La lengua hablada incluye variaciones de acento, expresiones regionales, cambios de idioma a mitad de frase y diferencias de velocidad que una transcripción aplana. Un pipeline encadenado lo agrava, porque la transcripción tiene que adivinar el idioma antes de que el modelo vea nada, y un error se propaga por todas las etapas siguientes.
Conviene cuestionar las cifras de cobertura. La pregunta útil para cualquier proveedor es si los idiomas que anuncia se han probado en producción o simplemente aparecen en la ficha de un modelo.
Pruebas a gran volumen
Una empresa de juegos de la lista Fortune 500 que opera en un mercado regulado alcanza un 80 % de resolución en más de 330 000 interacciones mensuales, incluidas 13 000 interacciones resueltas en un solo día de evento de máxima demanda.
Los días pico son la prueba de verdad. Los picos de volumen son cuando las colas se desbordan, cuando un sistema aguanta o se degrada a la vista de todos, y cuando los clientes se forman una opinión duradera sobre si vale la pena llamarte.
Cómo evaluar la voz sin quedarte en la demo
Las demos grabadas no son pruebas. Pide una llamada en directo y, durante ella, compórtate como lo harían tus clientes.
- Interrumpe a mitad de frase y comprueba si el agente se detiene o sigue hablando
- Cambia de opinión a mitad de una solicitud
- Añade ruido de fondo
- Habla con un acento que el proveedor no haya previsto
- Pídele que haga algo, no solo que te diga algo
La última es la que más pesa. Responder una pregunta y completar una transacción son capacidades distintas, y la resolución autónoma requiere la segunda.
Las 3 decisiones, en formato resumido, están en El árbol de decisión de la IA de voz , que se complementa con El alcance del piloto de 90 días para los equipos que se plantean la voz como su primer canal automatizado. Ambos se basan en el capítulo «La oportunidad del canal de voz» del informe State of AI in CX 2026 .
Míralo con tus propias conversaciones.
Solicita una demo personalizada gratuita.


