
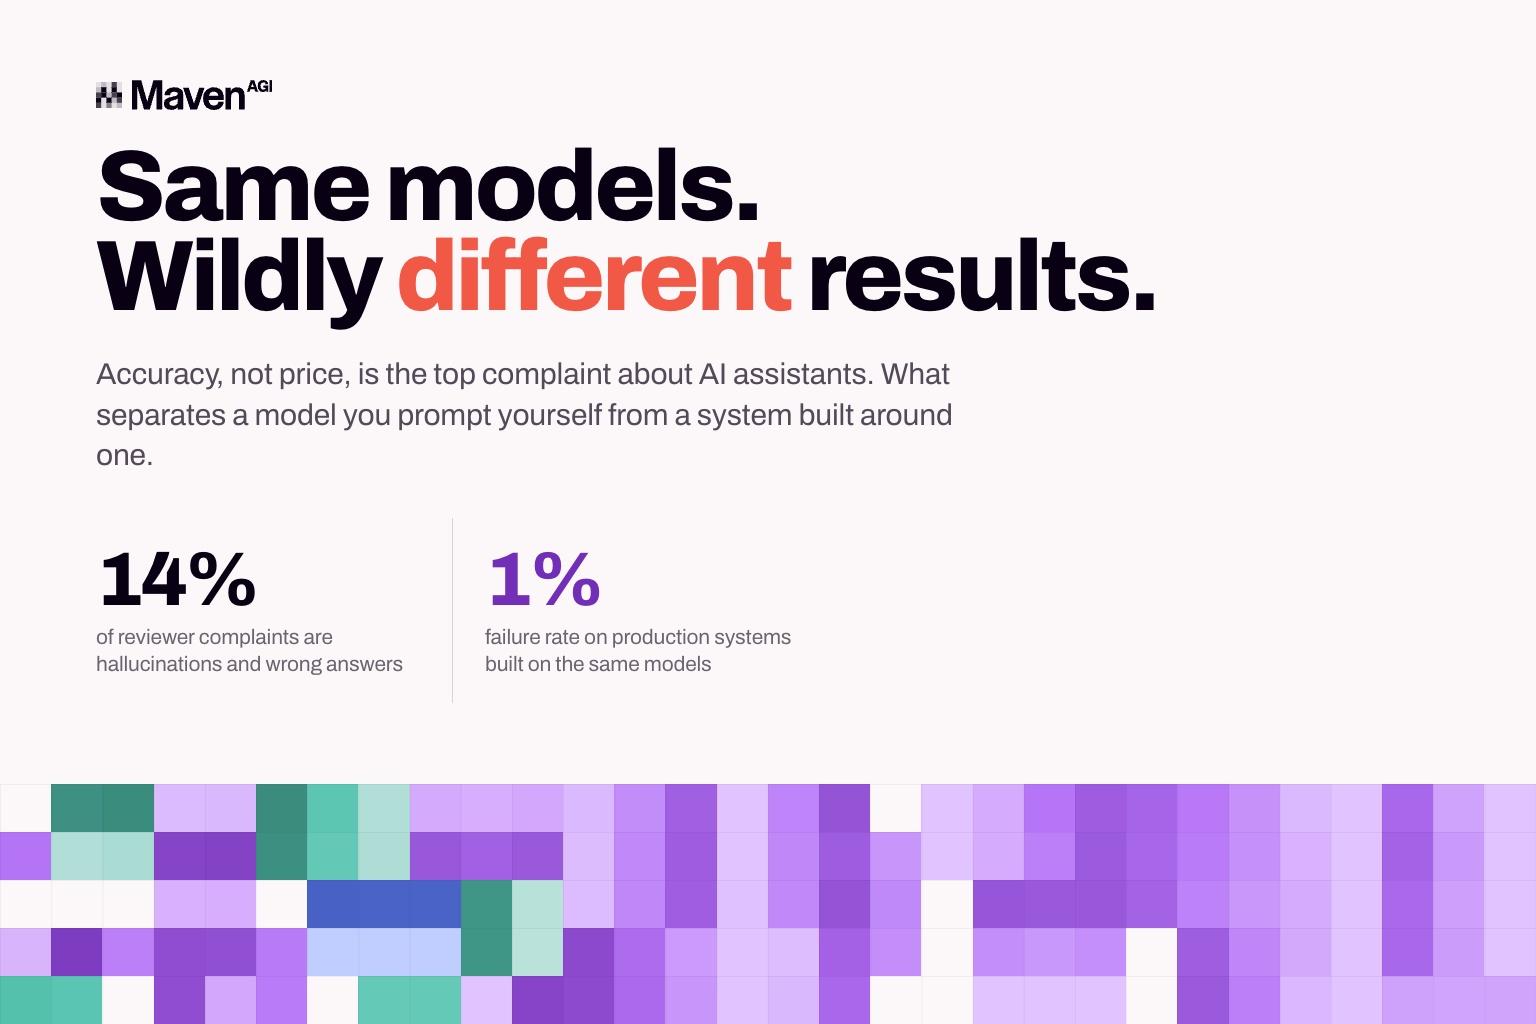
G2 研读了 2,950 多条经过验证的评价,时间跨度为 1 月至 7 月中旬,想看看用户最常抱怨的是什么。结果排在首位的是准确性,而非价格。在评价者列出的所有不满中,幻觉和错误答案占了 14%,超过了成本。要知道,今年大家争论最多的恰恰是成本。
值得了解这些评价者是谁,因为这会改变这个数字的含义。他们谈论的大多是人人都在浏览器标签页里开着的通用助手,而不是描述生产环境中客服智能体的 CX 团队。他们向模型提问,得到一个笃定的回答,然后得自己判断它是否属实。
随后,G2 找到 4 家基于同样模型构建生产系统的供应商,询问它们的实际失败率。最低仅为 1%。
所以,真正被比较的并不是一个模型和另一个模型,而是您自己提示的模型,与有人围绕模型搭建起来的系统:底层技术相同,结果却天差地别。Maven 正是 G2 调研的 4 家供应商之一。
差距从何而来
这 4 家供应商所描述的内容,与选用了哪个模型毫无关系。它们的说法大同小异:系统分步骤工作,而不是一步到位;答案取自实时数据,而不是模型碰巧从训练中记住的内容;它们衡量任务实际完成的频率,并且每周至少改写 1 次提示词和逻辑,其中 1 家更是每天都做。这些工作都是围绕模型展开的,而不是针对模型本身。
它们达成的更有价值的共识,是精力该投向何处。4 家都表示,难点不在日常问题,而在边缘情况和多步骤任务。因此,它们构建的系统能够察觉自己力所不及,并把对话转交给人工,而不是去猜。Maven 在调研中的说法是:“没有可靠兜底逻辑的自主性不是功能,而是隐患。”
差距的主要原因就在这里。当您自己提示模型时,检查其工作的人是您。而生产系统的设计目标,是让这份工作永远不会落到客户身上。G2 说得很直白:这些供应商并不是遇到的失败更少,而是在任何人察觉之前就把失败拦截了下来。
“智能体还是聊天机器人”之争,多半只是措辞之争
G2 直接问这 4 家供应商:AI 智能体是否比这一品类仍称之为聊天机器人的产品更可靠?它们的回答大致相同,而这对于靠这个词做营销的厂商来说并非好消息。在生产环境中,两者的差别远没有营销宣传的那么大,单纯换个标签本身解决不了任何问题。
这一点对买家比对供应商更重要。如果您冲着“智能体”这个词去选购,您买到的是标签,而不是能力。一家把产品称作智能体,另一家用别的叫法,这并不能告诉您其中任何一家是否会在您的最新知识中检索信息、是否能察觉自己没有把握、上线后是否会对照真实对话接受检验。这些才是客户服务中智能体 AI 的特性,而它们没有一项会随标签自动附带。
真正有参考价值的问题,关乎产品是如何构建的。以下 5 个问题,您都可以在首次沟通时提出。
- 答案从何而来?它是在您的实时知识中检索,还是依赖模型在训练中吸收的内容?
- 它没有把握时会怎样?是转交人工,还是用回答正确时同样笃定的语气去猜?
- 多久会有人对照真实对话检查它的答案?衡量的又是什么?
- 您的团队能否调整智能体的行为,还是每次微调都要回到供应商那里?
- 它能否真正在您的系统中执行操作,还是只能告诉客户该怎么做?
如果供应商能回答全部 5 个问题,说明有人真正下了功夫。如果第 1 个问题答得漂亮,之后就含糊其辞,那他们只是买了个模型,再套上一个小组件。更完整的清单请参阅我们的指南:如何评估面向企业客户服务的 AI 智能体。
买家容易忽略的部分
这 4 家供应商所描述的,正是 Maven 的 5 层架构所依托的技术栈。模型只是其中 1 层。让它变得可靠的一切都围绕在它周围:智能体知道什么、被允许做什么、上线后如何检验其工作,以及由谁掌握护栏。买家通常盯着模型挑选,因为那一层挂着响亮的名字。但 G2 数据所指向的一切都在其余 4 层,这也正是自主解决与“一个好答案”截然不同的原因。
这也是为什么快速部署与可靠并不矛盾,无论这个品类如何默认。构建这些层是实打实的工程,但只需在平台内部完成一次,而不必在每个客户的技术栈里变成一个 6 个月的项目。
功夫做到位之后是什么样子
Mastermind 在 6 周内实现了 93% 的自主解决率。K1x 在上线第 1 周就达到 80%。Rho 在每月咨询量增加 12% 且未新增人手的情况下,CSAT 仍保持在 95%。Quest 基于 Maven 打造了 AskQ,直接接入现有的知识库和案例系统,无需任何数据迁移,并以客户满意度而非分流率来评判其表现。
Maven 自身的评价也印证了这一点:20 条经验证评价中获得 4.8/5 分。值得细读用户实际提到的内容:单一引擎同时处理聊天、邮件和语音,无需维护多个机器人并保持同步;知识检索会标记过时、重复和相互冲突的文章,而不是拿最先找到的那篇来回答;在 Salesforce 或 Zendesk 之上,几天即可完成部署。这些都是模型之外的部分。
在 8 月 25 日发布的 G2 2026 年秋季报告中,Maven 入选了客户服务自动化中型市场网格(Mid-Market Grid)、AI 客户支持智能体中型市场成果指数(Mid-Market Results Index),以及 AI 客户支持智能体实施指数(Implementation Index)。指数类报告依据的是客户对所获成果和部署过程的评价,而不是公司的规模或知名度。它们衡量的,恰恰是 G2 更宏观的数据显示在其他地方普遍出问题的那件事。
差距本身就是答案
真正值得关注的数字,是 14% 与 1% 之间的距离,因为两者都建立在同样几个模型之上。技术本身解释不了如此大的差距。能解释它的,是有没有人愿意去构建那些在客户看到错误答案之前就将其拦截的部分。这也是为什么只有弄清解决率是如何衡量的,这个数字才有意义。
大多数买家仍在比较模型名称。而 G2 访谈的这 4 家供应商,早已不再这样做。
如果您想亲眼看看这些层,而不只是读文字介绍,欢迎预约演示。
用您自己的对话来验证。
申请免费的个性化演示。


