
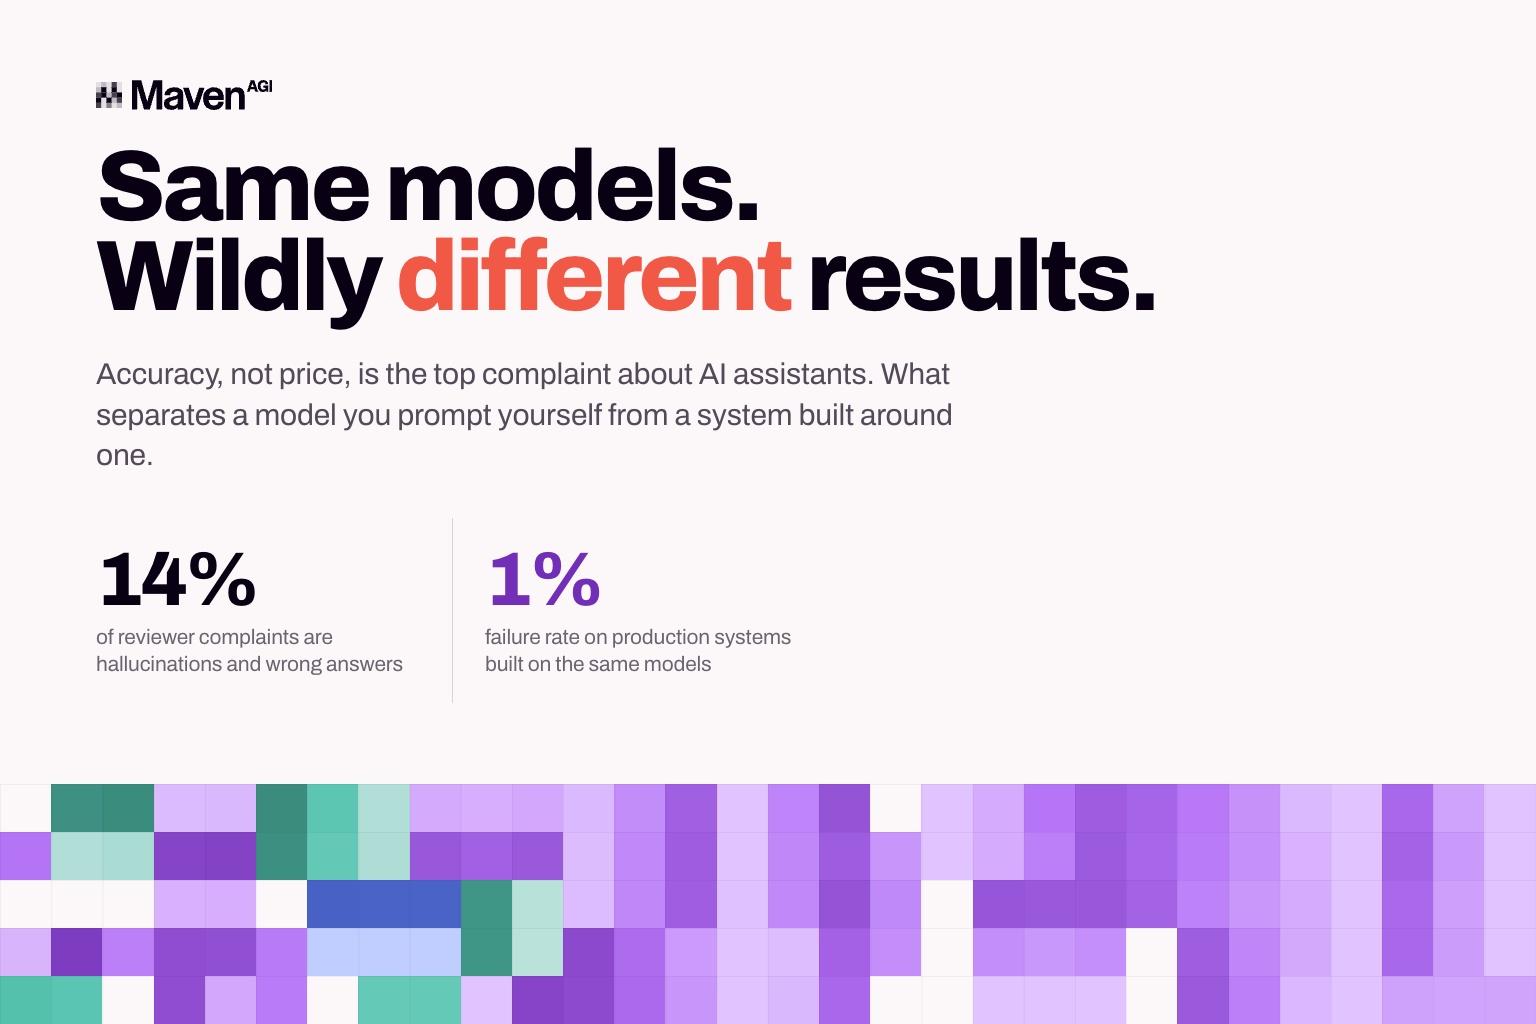
G2 ha analizzato oltre 2.950 recensioni verificate pubblicate tra gennaio e metà luglio per capire di cosa si lamentano di più gli utenti. Il problema principale non era il prezzo, ma l'accuratezza. Allucinazioni e risposte sbagliate rappresentavano il 14% di tutto ciò che ai recensori non piaceva: più dei costi, in un anno in cui tutti sembrano voler parlare solo di quelli.
Vale la pena sapere chi sono questi recensori, perché cambia il significato del dato. La maggior parte parla degli assistenti generici che tutti tengono aperti in una scheda del browser. Non sono team CX che descrivono un agente di supporto in produzione. Sono persone che fanno una domanda a un modello, ricevono una risposta sicura di sé e poi devono capire da sole se è vera.
Poi G2 si è rivolta a 4 fornitori che costruiscono sistemi di produzione su quegli stessi modelli e ha chiesto quali siano davvero i loro tassi di errore. Anche solo l'1%.
Quindi il confronto reale non è tra un modello e un altro. È tra un modello che interroghi tu stesso e un sistema che qualcuno ha costruito attorno a un modello: stessa tecnologia di base, risultati completamente diversi. Maven era uno dei 4 fornitori interpellati da G2.
Cosa c'è dietro il divario
Nulla di ciò che hanno descritto quei 4 fornitori aveva a che fare con il modello scelto. Hanno detto tutti più o meno la stessa cosa. I loro sistemi lavorano per passaggi, non in un colpo solo. Le risposte vengono recuperate da dati aggiornati, non da ciò che il modello ricorda dall'addestramento. Misurano quanto spesso un'attività viene effettivamente completata e riscrivono prompt e logica almeno ogni settimana. Uno di loro lo fa ogni giorno. È tutto lavoro fatto attorno al modello, non sul modello.
Il punto di accordo più utile riguarda dove si concentra l'impegno. Tutti e 4 hanno detto che la parte difficile non è la domanda di tutti i giorni, ma il caso limite e l'attività in più passaggi. Per questo costruiscono sistemi che si accorgono di essere fuori dalla propria portata e passano la conversazione a una persona invece di tirare a indovinare. Nel sondaggio Maven ha affermato che “l'autonomia senza una logica di fallback affidabile non è una funzionalità, è un rischio”.
Gran parte del divario sta tutta qui. Quando interroghi un modello da solo, sei tu a dover verificare il suo lavoro. Un sistema di produzione è costruito in modo che questo compito non ricada mai sul cliente. G2 lo ha detto chiaramente: questi fornitori non registrano meno errori, li intercettano prima che qualcuno se ne accorga.
Il dibattito agenti contro chatbot è soprattutto una questione di parole
G2 ha chiesto senza giri di parole ai 4 fornitori se gli agenti AI siano più affidabili di quelli che la categoria chiama ancora chatbot. Hanno risposto tutti più o meno allo stesso modo, e non è una buona notizia per chi vende puntando sulla parola. In produzione le due cose sono molto meno diverse di quanto suggerisca il marketing, e sostituire un'etichetta con l'altra di per sé non risolve nulla.
Questo conta più per chi compra che per chi vende. Se cerchi la parola “agente”, stai comprando un'etichetta, non una capacità. Che un fornitore chiami il suo prodotto agente e un altro lo chiami in modo diverso non ti dice nulla sul fatto che consultino la tua knowledge base aggiornata, si accorgano di quando non sono sicuri o vengano verificati su conversazioni reali dopo il lancio. Queste sono proprietà dell'AI agentica nel customer service, e nessuna arriva insieme all'etichetta.
Le domande che ti dicono davvero qualcosa riguardano come è costruito il sistema, e puoi farle tutte e 5 già alla prima call.
- Da dove arrivano le risposte? Il sistema consulta la tua knowledge base aggiornata o si basa su ciò che il modello ha assimilato durante l'addestramento?
- Cosa succede quando non è sicuro? Passa la mano o tira a indovinare con lo stesso tono sicuro che usa quando ha ragione?
- Ogni quanto qualcuno verifica le sue risposte su conversazioni reali, e cosa misura?
- Il tuo team può modificare il comportamento dell'agente o ogni ritocco deve passare dal fornitore?
- Può davvero agire nei tuoi sistemi o può solo dire al cliente cosa fare?
Se un fornitore sa rispondere a tutte e 5, qualcuno ha fatto il lavoro. Se risponde bene alla prima e poi diventa vago, ha comprato un modello e ci ha messo sopra un widget. Trovi una versione più completa di questa lista nella nostra guida alla valutazione degli agenti AI per il customer service enterprise.
Le parti che chi compra trascura
Ciò che hanno descritto quei 4 fornitori è lo stesso stack su cui si basa l'architettura a 5 livelli di Maven. Il modello è un livello. Tutto ciò che lo rende affidabile gli sta attorno: cosa sa l'agente, cosa gli è consentito fare, come verifichi il suo lavoro una volta in produzione e chi gestisce i guardrail. Chi compra di solito sceglie il modello, perché è il livello con i nomi famosi. Tutto ciò a cui puntano i dati di G2 si trova negli altri 4, ed è il motivo per cui la risoluzione autonoma è una cosa diversa da una buona risposta.
È anche il motivo per cui rapidità di implementazione e affidabilità non sono in contrapposizione, qualunque cosa pensi la categoria. Costruire questi livelli richiede vera ingegneria, ma avviene una volta sola, all'interno della piattaforma, invece di trasformarsi in un progetto di 6 mesi nello stack di ogni cliente.
Come appare quando il lavoro è stato fatto
Mastermind ha raggiunto il 93% di risoluzione autonoma in 6 settimane. K1x ha toccato l'80% nella prima settimana. Rho ha mantenuto un CSAT del 95% gestendo il 12% di contatti in più al mese senza nuove assunzioni. Quest ha costruito AskQ su Maven, collegandolo a una knowledge base e a un sistema di gestione dei casi già esistenti senza alcuna migrazione di dati, e lo valuta sulla soddisfazione dei clienti anziché sulla deflection.
Anche le recensioni di Maven vanno nella stessa direzione. 4,8 su 5 su 20 recensioni verificate, e vale la pena leggere cosa sottolineano gli utenti: un unico motore che gestisce chat, email e voce invece di bot separati da tenere sincronizzati; un recupero della conoscenza che segnala articoli obsoleti, duplicati e contraddittori invece di rispondere con il primo che trova; una configurazione che si misura in giorni su Salesforce o Zendesk. È tutto ciò che sta attorno al modello.
Nei report Fall 2026 di G2, pubblicati il 25 agosto, Maven è entrata nella Mid-Market Grid per Customer Service Automation, nel Mid-Market Results Index per AI Customer Support Agents e nell'Implementation Index per AI Customer Support Agents. Gli Index report si basano su ciò che i clienti dicono dei risultati ottenuti e di come è andata l'implementazione, non sulle dimensioni o sulla notorietà di un'azienda. Misurano esattamente ciò che, secondo i dati più ampi di G2, non funziona altrove.
Il divario è la vera notizia
Il dato a cui prestare attenzione è la distanza tra il 14% e l'1%, perché entrambi poggiano sugli stessi pochi modelli. Nulla nella tecnologia spiega un divario così ampio. Lo spiega il fatto che qualcuno si sia preso la briga di costruire le parti che intercettano una risposta sbagliata prima che il cliente la veda. Ed è per questo che un tasso di risoluzione ha senso solo quando sai come è stato misurato.
La maggior parte di chi compra sta ancora confrontando i nomi dei modelli. I 4 fornitori sentiti da G2 ci hanno rinunciato da tempo.
Se vuoi vedere i livelli invece di leggerne, prenota una demo.
Mettilo alla prova sulle tue conversazioni.
Richiedi una demo personalizzata gratuita.


