
In het ontwerp van de meeste AI-agents zit een aanname ingebakken die zelden ter discussie staat: als data relevant is om een vraag te beantwoorden, moet de agent die kunnen gebruiken.
Dat klinkt redelijk, maar het klopt niet.
Voor organisaties met platforms voor meerdere groepen deelnemers, zoals klanten en merchants, passagiers en chauffeurs of opdrachtgevers en dienstverleners, is juist die aanname wat AI-implementaties ongemerkt in vertrouwensproblemen verandert.
De relevantievalkuil
Een klant neemt contact op met support over een te late bezorging. Hij wil weten wat er is gebeurd en vraagt om een terugbetaling.
De meest relevante informatie omvat de gemiddelde bereidingstijden van het restaurant, de specifieke bereidingstijd van die bestelling, de routegeschiedenis van de bezorger en eventuele meldingen tijdens de afhandeling. Dat is allemaal direct bruikbaar en levert een beter, nauwkeuriger antwoord op.
Maar zo krijgt een klant ook operationele prestatiedata van een restaurant te zien waar hij niets mee te maken heeft. Het gedrag van een bezorger wordt ter discussie gesteld zonder zorgvuldige procedure. En er ontstaat een directe lijn tussen de uitkomst voor de ene partij en de data van de andere, zonder dat een van beide daarvan weet of ermee instemt.
De agent maakte geen fout. Hij deed precies waarvoor hij was ontworpen: vinden wat relevant is en dat gebruiken. De fout zat in de aanname dat relevantie en toestemming hetzelfde zijn.
Waarom dit onderscheid lastiger is dan het lijkt
Bij een product met één gebruikersgroep vallen relevantie en toestemming grotendeels samen. Wie de vraag stelt, is ook degene om wiens data het gaat. Het verschil tussen wat nuttig is en wat is toegestaan, is zo klein dat de meeste agents er zonder incidenten mee omgaan.
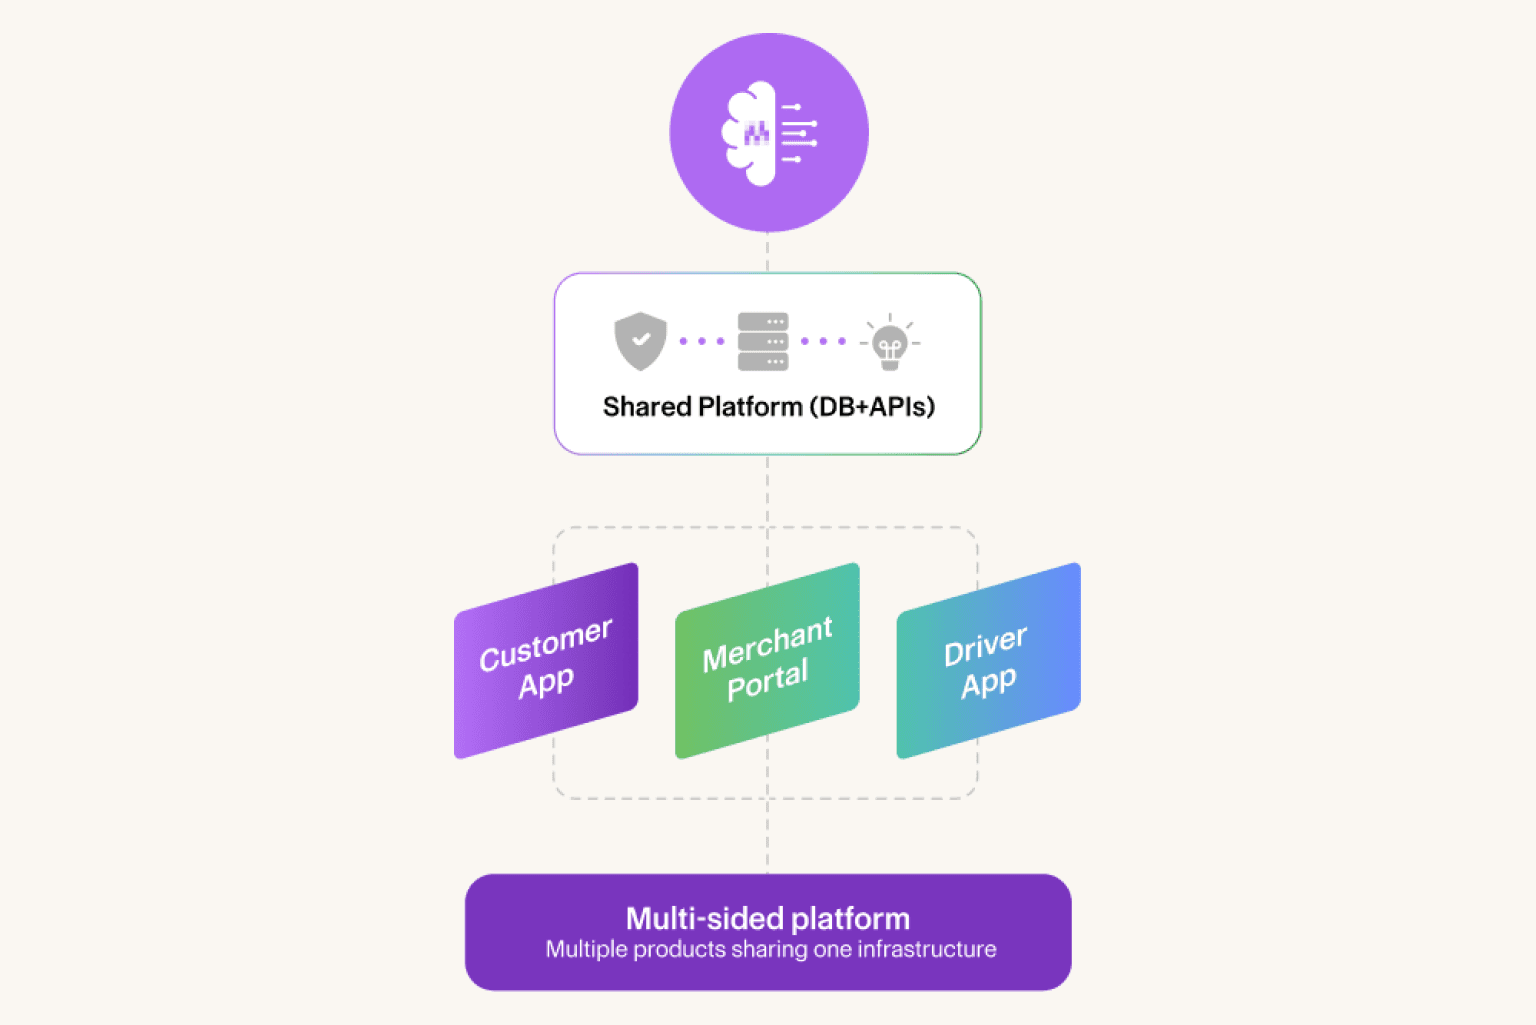
Multi-sided platforms zetten die aanname volledig op losse schroeven.
Elke groep deelnemers heeft eigen data, workflows, privacyverwachtingen en opvattingen over wat een eerlijke uitkomst is. Als een AI-agent vanuit één gedeelde kennisbank voor al die groepen werkt, beweegt hij zich niet in één data-omgeving, maar in meerdere tegelijk, zonder harde grenzen ertussen.
Daarbij duiken steeds drie faalpatronen op:
Datalekken tussen omgevingen. Informatie die in de ene omgeving relevant is, hoort bij een deelnemer in een andere. Denk aan een klantagent die de geschillengeschiedenis van merchants kan inzien, een merchantportaal dat details van klantklachten toont of een chauffeursinterface die naar handhavingsdata op platformniveau verwijst.
Acties met ongecontroleerde gevolgen elders. Een terugbetaling aan de klantkant leidt tot een inhouding op de uitbetaling aan de merchantkant. Een AI-agent die de eerste actie kan uitvoeren maar het tweede gevolg niet ziet, neemt beslissingen die redelijk lijken, maar problemen veroorzaken waar hij zelf nooit mee te maken krijgt. De feedbackloop wordt niet gesloten.
Ongelijke behandeling per groep deelnemers. Dezelfde onderliggende vraag, namelijk waarom mijn betaling is verlaagd, betekent iets fundamenteel anders als een merchant of een chauffeur hem stelt. De toegestane data, het juiste antwoord en de toegestane acties verschillen allemaal. Een agent zonder harde grenzen tussen omgevingen geeft antwoorden die technisch kloppen, maar in de context verkeerd zijn.
Geen van deze problemen is de schuld van de AI-agent. Het zijn architectuurfouten. Niemand heeft de agent ooit verteld waar de grenzen lagen.
Relevantie is een startpunt, geen autorisatie
Dit is de omslag in denken die ertoe doet: relevantie bepaalt waar de agent naar zoekt, maar geschiktheid bepaalt waartoe hij daadwerkelijk toegang heeft.
Twee afzonderlijke vragen, in deze volgorde beantwoord.
Geschiktheid komt eerst. Voordat een agent iets ophaalt, moet het platform al antwoord hebben op de volgende vragen: uit welke omgeving komt deze interactie? Welke groep deelnemers is geauthenticeerd? Welke data en acties vallen binnen de scope van deze omgeving, deze rol en deze beleidscontext? Wat is hoe dan ook verboden terrein, ongeacht hoe relevant het is?
Dat zijn geen vragen waar het model zelf over moet redeneren. Het zijn beperkingen die het platform deterministisch afdwingt, nog voordat de agent begint. Relevantie werkt vervolgens binnen die beperkingen, niet in plaats daarvan.
Het praktische effect is groot. Een agent die beperkt is tot de klantomgeving, kan niet per ongeluk merchantdata tonen. Niet omdat hij de instructie heeft gekregen dat niet te doen, maar omdat die data nooit in aanmerking kwam. Promptinstructies kunnen worden omzeild. Geschiktheidsbeperkingen niet.
Dat onderscheid is belangrijker dan het lijkt. 'Mag niet gebruiken' en 'kan niet bij' bieden niet hetzelfde beschermingsniveau. Op schaal, in complexe omgevingen en met echte uitzonderingssituaties houdt alleen het tweede stand.
Wat dit in de praktijk betekent
Platforms die dit goed aanpakken, bouwen geen restrictievere agents. Ze bouwen agents met een betere architectuur. Het redeneervermogen van de agent blijft gelijk; wat verandert, is het fundament waarop hij redeneert.
Het resultaat is geen minder capabele agent, maar een agent die door alle groepen deelnemers tegelijk kan worden vertrouwd. Op multi-sided platforms is dát het vermogen dat schaalt.
Relevantie levert een goed antwoord op. Geschiktheid levert een betrouwbaar antwoord op.
Zie het op je eigen gesprekken.
Vraag een gratis demo op maat aan.


