
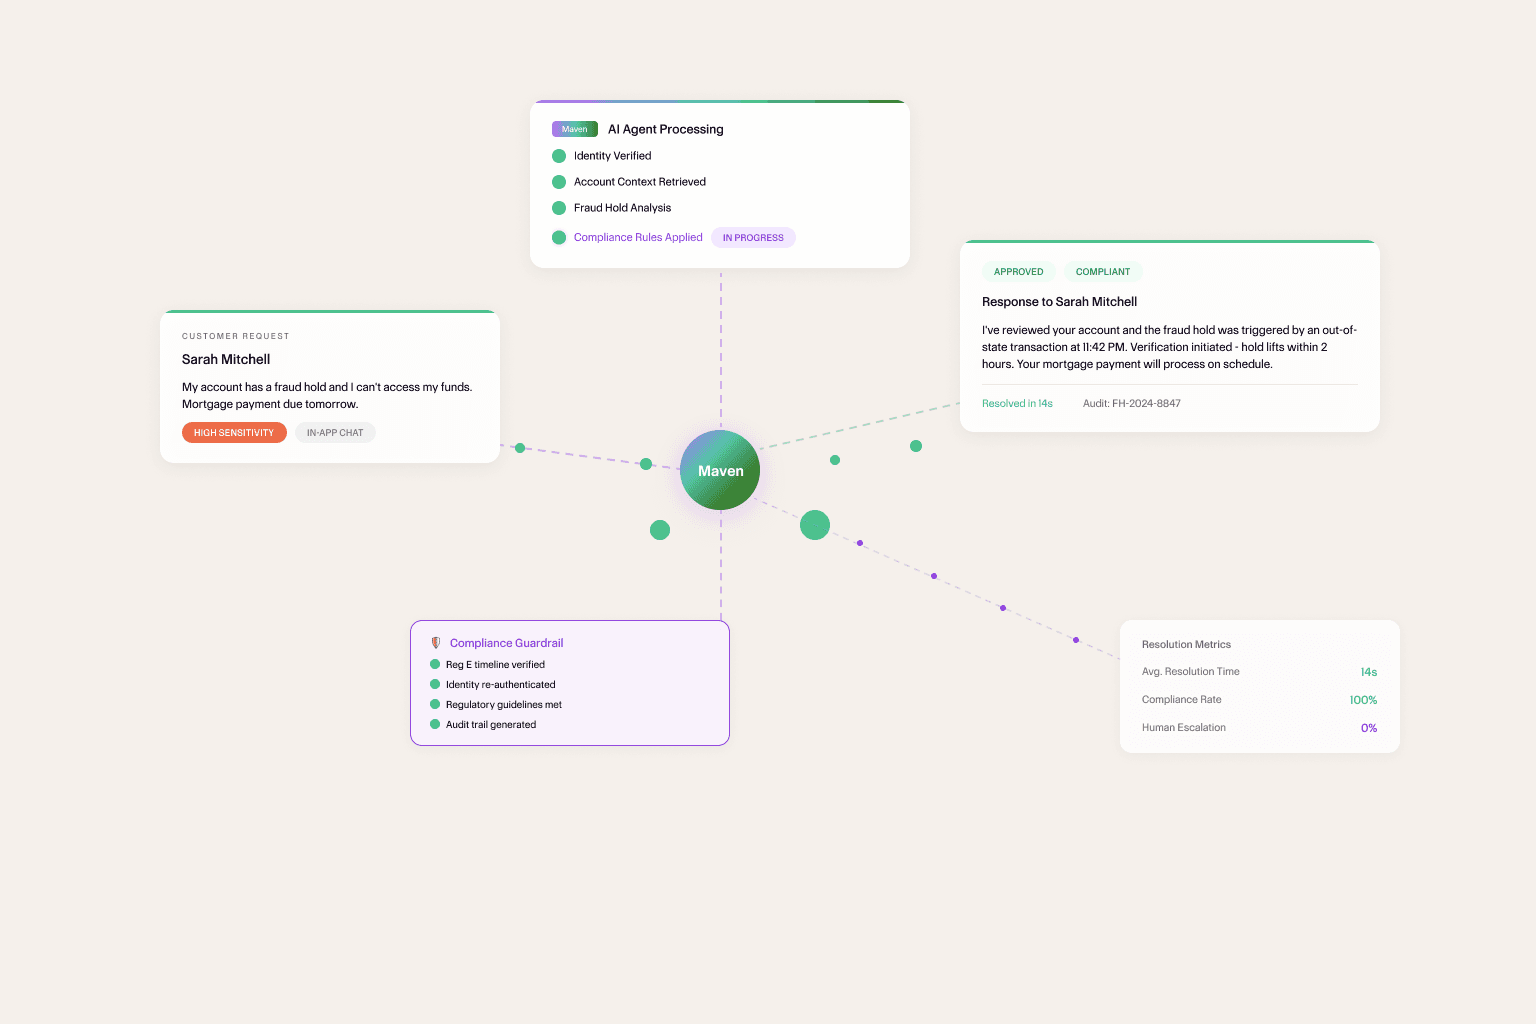
Los datos financieros están entre la información más sensible que las personas comparten con cualquier plataforma. Los errores tienen consecuencias regulatorias. Una respuesta equivocada sobre un bloqueo por fraude o una disputa de cuenta mal gestionada no solo frustra al cliente: genera exposición legal, debilita tu posición de cumplimiento y provoca el tipo de cobertura mediática que tarda años en olvidarse.
Durante buena parte de la última década, los equipos de soporte de FinTech resolvieron las incidencias de la misma manera: automatizar lo sencillo, asignar personas a todo lo sensible y aceptar la estructura de costos que eso conlleva.
Ese modelo está bajo presión. No porque haya cambiado lo que está en juego, sino porque los agentes de IA han madurado hasta el punto de que asignar una persona ya no es la única forma de gestionar con seguridad interacciones complejas y muy sensibles. La pregunta ya no es si automatizar, sino cómo diseñar la automatización para que sea realmente confiable.
El problema de los datos en FinTech es estructural
Todos los sectores tienen datos sensibles. En FinTech el problema es especialmente agudo por cómo están estructurados los datos y por la cantidad de partes que tienen derechos legítimos, pero distintos, sobre ellos.
Piensa en una plataforma que da servicio tanto a titulares de cuentas empresariales como a sus empleados. El propietario de la empresa tiene visibilidad total. Un empleado titular de una tarjeta solo ve la actividad de su propia tarjeta. Ambos son usuarios autenticados de la misma plataforma. Ambos podrían hacer preguntas parecidas —¿por qué se rechazó esta transacción?—, pero los datos que cada uno está autorizado a ver y las acciones que cada uno está autorizado a realizar son fundamentalmente distintos.
Añade una tercera capa: la propia plataforma, con equipos de operaciones internas, funciones de cumplimiento y analistas de fraude que necesitan acceder a los datos de las cuentas bajo reglas completamente diferentes.
No es un caso límite hipotético. Es el modelo operativo estándar de las plataformas de banca empresarial, las plataformas de préstamos, las herramientas de gestión de gastos y los proveedores de infraestructura de pagos. El entorno de datos es compartido. Las reglas de acceso, no.
Cuando los agentes de IA entran en este entorno con acceso amplio y sin reglas estrictas de elegibilidad por participante, el riesgo de contaminación cruzada es considerable. No porque el agente actúe con mala intención, sino porque hace exactamente aquello para lo que fue diseñado: encontrar la información más relevante y usarla para responder la pregunta.
El problema es que relevante y permitido no son lo mismo.
Qué pasa cuando la IA de FinTech se equivoca
Los modos de fallo en FinTech son versiones de mayor riesgo de los mismos patrones que aparecen en cualquier plataforma multilateral.
Exposición regulatoria. El acceso a los datos financieros está regulado por normativas que exigen minimización de datos, limitación de la finalidad, consentimiento y auditabilidad. Un agente que muestra datos de una cuenta a un usuario no autorizado no provoca solo una incidencia de soporte: provoca un posible incidente de cumplimiento. «El modelo pensó que era relevante» no es una respuesta que satisfaga a un regulador.
Confianza de los titulares de cuentas. Los servicios financieros dependen de la confianza como pocos sectores. En cuanto un usuario empieza a preguntarse qué más sabe esta plataforma de él y quién más puede verlo, tienes un problema que ningún CSAT refleja.
Infracciones del control de acceso interno. Los analistas de fraude operan con reglas de acceso distintas a las del soporte al cliente. Los equipos de cumplimiento tienen alcances distintos a los de los gestores de cuentas. Un agente de IA que opera en todas estas funciones sin controles explícitos de elegibilidad basados en roles se convierte en una vía para infracciones de acceso interno.
Errores en decisiones críticas. Las interacciones en las que los agentes de IA son más útiles —disputas por fraude, pagos fallidos, restricciones de cuenta— son también aquellas en las que un error tiene más consecuencias. Un cliente que actúa con información errónea sobre el proceso de resolución de una disputa por fraude genera una responsabilidad posterior de la que la plataforma tiene que hacerse cargo.
El replanteamiento que ya está en marcha
Las plataformas FinTech que lideran este cambio de arquitectura no están renunciando a la automatización. Están separando dos cosas que históricamente iban juntas: la capacidad de razonamiento del agente de IA y su acceso a los datos.
La idea es sencilla. La capacidad de un agente de IA para entender el contexto, manejar matices y resolver interacciones complejas no depende de tener acceso a todo. Depende de tener acceso a lo adecuado para el contexto en el que opera.
Esto lleva a un principio de arquitectura que, visto en retrospectiva, parece obvio: definir qué es elegible antes de que el agente recupere nada.
En la práctica, cada interacción empieza estableciendo el contexto: qué superficie, qué usuario autenticado, qué rol y qué entorno de políticas están activos. A partir de esos datos, la plataforma determina qué información está dentro del alcance y qué acciones están permitidas. Después, el agente opera dentro de ese alcance con toda su capacidad de razonamiento.
Un propietario de cuenta empresarial que pregunta por la actividad de la tarjeta de un miembro de su equipo ve lo que está autorizado a ver. Un empleado titular de tarjeta que hace la misma pregunta solo ve sus propios datos. Un analista de cumplimiento que realiza una revisión opera con reglas de acceso propias de cumplimiento. El mismo agente de IA. La misma capacidad de fondo. Distintos contextos de elegibilidad aplicados en la capa de arquitectura, antes de que el agente razone sobre nada.
Este enfoque aporta tres beneficios concretos que importan en FinTech.
Auditabilidad. Cuando cada interacción está delimitada por reglas de elegibilidad explícitas, tienes un registro claro de qué datos tenía disponibles el agente en cada interacción. «¿A qué datos accedió el agente?» pasa a ser una pregunta que puedes responder con precisión, no de forma aproximada, que es justo lo que exige una investigación regulatoria.
Aplicación coherente del control de acceso. La capa de elegibilidad no depende de que el agente recuerde sus instrucciones ni de que infiera correctamente el contexto. Se aplica de forma estructural, lo que significa que funciona igual en cada interacción, cada caso límite y cada entrada inusual.
Postura de cumplimiento escalable. Cuando llegan nuevas regulaciones —y en FinTech siempre llegan—, actualizar las reglas de elegibilidad en la capa de arquitectura se propaga de inmediato a todas las interacciones de IA. No tienes que volver a escribir prompts para los modelos ni reentrenar sistemas. Las reglas se aplican en todas partes, automáticamente.
El criterio humano no desaparece
Hay algo que este replanteamiento de arquitectura no cambia: existen interacciones en las que lo correcto es recurrir al criterio humano, y un sistema de IA bien diseñado facilita llegar a ese punto.
En FinTech, estos momentos son predecibles. Un cliente que impugna una determinación de fraude que la plataforma ya revisó. Un titular de cuenta empresarial que cuestiona un bloqueo por cumplimiento. Un cliente de alto valor con una pregunta compleja sobre varios productos que exige decisiones sobre políticas de excepción.
En estas interacciones, Agent Maven se encarga de recuperar la información y reunir el contexto: pone al agente humano al día rápidamente, muestra el historial relevante y señala las preguntas clave que hay que responder, mientras la decisión final y la comunicación quedan en manos humanas.
La vía de escalamiento no es un modo de fallo. Es una función diseñada de una arquitectura de soporte con IA madura. Construirla de forma deliberada, con desencadenantes claros, traspasos fluidos y todo el contexto transmitido al agente humano, es lo que distingue las implementaciones de IA que resisten el escrutinio de las que generan incidentes justo cuando más está en juego.
De la reducción de costos a la infraestructura de confianza
Al principio, la IA en el soporte de FinTech se planteaba casi exclusivamente en términos de costos: tasas de deflexión, reducción de tickets, ahorro de horas de agente. Estas métricas son reales e importan, pero solo reflejan una parte de lo que está en juego.
Las plataformas FinTech que obtienen el valor más duradero de la IA no se centran principalmente en reducir costos. Están construyendo algo más difícil de replicar: una infraestructura de soporte en la que todos los grupos de participantes —clientes, titulares de cuentas, clientes empresariales, equipos internos— pueden confiar para tratar sus datos de forma adecuada y sus interacciones de forma coherente.
Ese es un objetivo de diseño distinto a la deflexión, y requiere una arquitectura distinta para lograrlo. Una en la que el control de acceso no es un añadido de última hora sobre un modelo capaz, sino una capa fundamental sobre la que opera la capacidad del modelo.
Las plataformas que invierten hoy en esa arquitectura no solo resuelven el problema actual de gobernanza de la IA. Están construyendo una infraestructura que hace que cualquier capacidad futura de IA sea confiable por defecto, porque la capa de elegibilidad que gobierna al agente de soporte de hoy también gobernará al agente más capaz de mañana.
En FinTech, la confianza no es una función. Es el producto.
Míralo con tus propias conversaciones.
Solicita una demo personalizada gratuita.


