
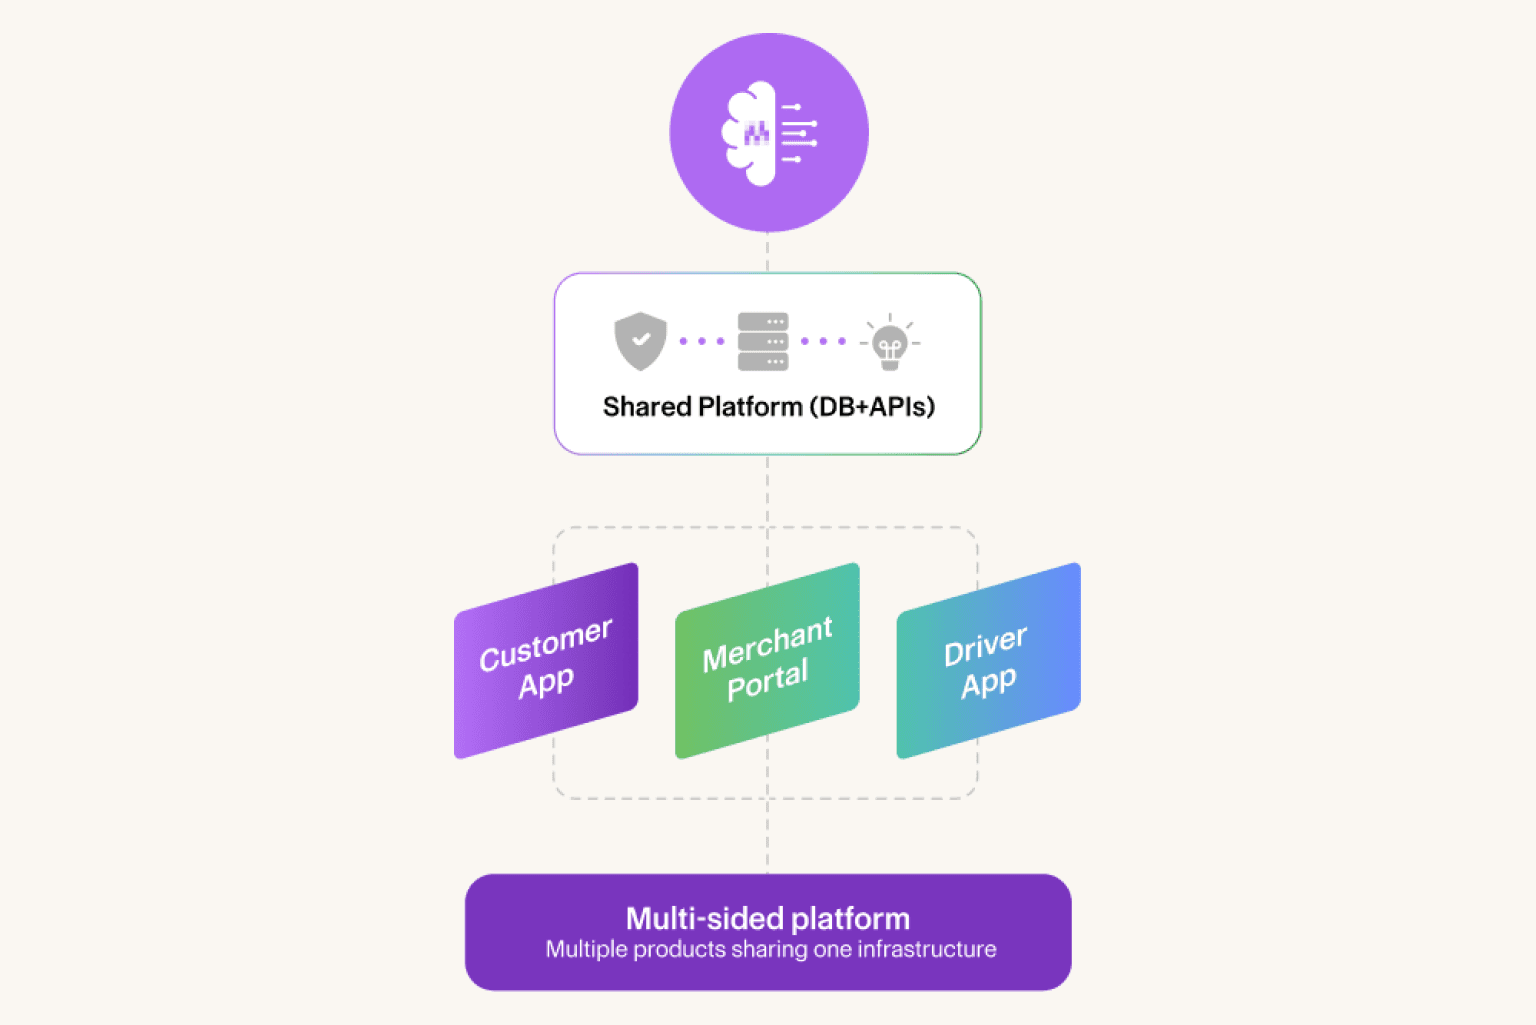
I de flesta AI-agenter finns ett inbyggt antagande som sällan ifrågasätts: om data är relevant för att besvara en fråga ska agenten få använda den.
Det låter rimligt, men det är fel.
För organisationer som driver plattformar med flera deltagargrupper – kunder och handlare, resenärer och förare, klienter och tjänsteleverantörer – är det just det antagandet som i det tysta förvandlar AI-satsningar till förtroendeproblem.
Relevansfällan
En kund kontaktar supporten om en försenad leverans. Kunden vill veta vad som hände och begär återbetalning.
Den mest relevanta informationen omfattar restaurangens genomsnittliga tillagningstider, tillagningsfönstret för just den beställningen, förarens rutthistorik och eventuella flaggor som dök upp under leveransen. Allt detta är direkt användbart och ger ett bättre och mer korrekt svar.
Samtidigt skulle det exponera restaurangens driftdata för en kund som inte har med den att göra. Det skulle peka ut förarens beteende utan någon rättvis prövning. Och det skulle dra en direkt linje mellan den ena partens utfall och den andra partens data, utan att någon av dem vet om det eller har gett sitt samtycke.
Agenten gjorde inget fel – den gjorde exakt det den var byggd för: hitta det som är relevant och använda det. Felet låg i antagandet att relevans och behörighet är samma sak.
Varför skillnaden är svårare än den ser ut
I en ensidig produkt sammanfaller relevans och behörighet för det mesta. Användaren som ställer frågan är också den vars data berörs. Glappet mellan det som är användbart och det som är tillåtet är så litet att de flesta agenter hanterar det utan problem.
Flersidiga plattformar slår helt undan det antagandet.
Varje deltagargrupp har sina egna data, arbetsflöden, förväntningar på integritet och sin egen syn på vad som är ett rättvist utfall. När en AI-agent arbetar över alla grupper från en gemensam kunskapsbas navigerar den inte i en enda datamiljö. Den navigerar i flera samtidigt, utan tydliga gränser mellan dem.
3 felmönster återkommer gång på gång:
Dataläckage mellan gränssnitt. Information som är relevant i ett gränssnitt tillhör en deltagare i ett annat. En kundagent som kan se handlares tvistehistorik, en handlarportal som visar detaljer om kundklagomål eller ett förargränssnitt som hänvisar till plattformens interna åtgärdsdata.
Åtgärder som får ogranskade konsekvenser på annat håll. En återbetalning i kundgränssnittet utlöser ett avdrag på handlarens utbetalning. En AI-agent som kan vidta den första åtgärden men inte ser den andra konsekvensen fattar beslut som låter rimliga men skapar problem den aldrig själv märker. Återkopplingen uteblir.
Olika behandling beroende på deltagargrupp. Samma grundfråga – varför sänktes min betalning? – betyder något helt olika beroende på om det är en handlare eller en förare som frågar. Tillåtna data, lämpligt svar och tillåtna åtgärder skiljer sig åt. En agent utan fasta gränser mellan gränssnitten ger svar som är tekniskt korrekta men fel i sitt sammanhang.
Inget av detta är AI-agentens fel – det är brister i arkitekturen. Agenten fick aldrig veta var gränserna gick.
Relevans är en utgångspunkt, inte en behörighet
Här är omtolkningen som spelar roll: relevans ska styra vad agenten letar efter, men behörighet ska avgöra vad den faktiskt får åtkomst till.
2 separata frågor, som besvaras i tur och ordning.
Behörigheten kommer först. Innan agenten hämtar något måste plattformen redan ha besvarat: Från vilket gränssnitt kommer interaktionen? Vilken deltagargrupp är autentiserad? Vilka data och åtgärder ingår för just det här gränssnittet, den här rollen och det här policysammanhanget? Vad är helt uteslutet, oavsett hur relevant det kan vara?
Det är inte frågor som modellen ska resonera sig fram till. Det är begränsningar som plattformen tillämpar deterministiskt, innan agenten ens börjar. Relevansen verkar sedan inom de ramarna, inte i stället för dem.
Den praktiska effekten är stor. En agent som är avgränsad till kundgränssnittet kan inte råka visa handlardata. Inte för att den har instruerats att låta bli, utan för att den datan aldrig var tillgänglig från början. Instruktioner i en prompt går att resonera sig runt. Behörighetsgränser gör det inte.
Skillnaden betyder mer än man kan tro. ”Bör inte använda” och ”kan inte komma åt” är inte samma skyddsnivå. I stor skala, i komplexa miljöer och med verkliga gränsfall är det bara det senare som håller.
Vad det betyder i praktiken
Plattformar som lyckas med detta bygger inte mer begränsade agenter – de bygger agenter med bättre arkitektur. Agentens förmåga att resonera är densamma; det som förändras är grunden den resonerar utifrån.
Resultatet är inte en mindre kapabel agent. Det är en agent som går att lita på för alla deltagargrupper samtidigt. På flersidiga plattformar är det den förmågan som skalar.
Relevans ger dig ett bra svar. Behörighet ger dig ett svar du kan lita på.
Se det på dina egna konversationer.
Begär en kostnadsfri, personlig demo.


