
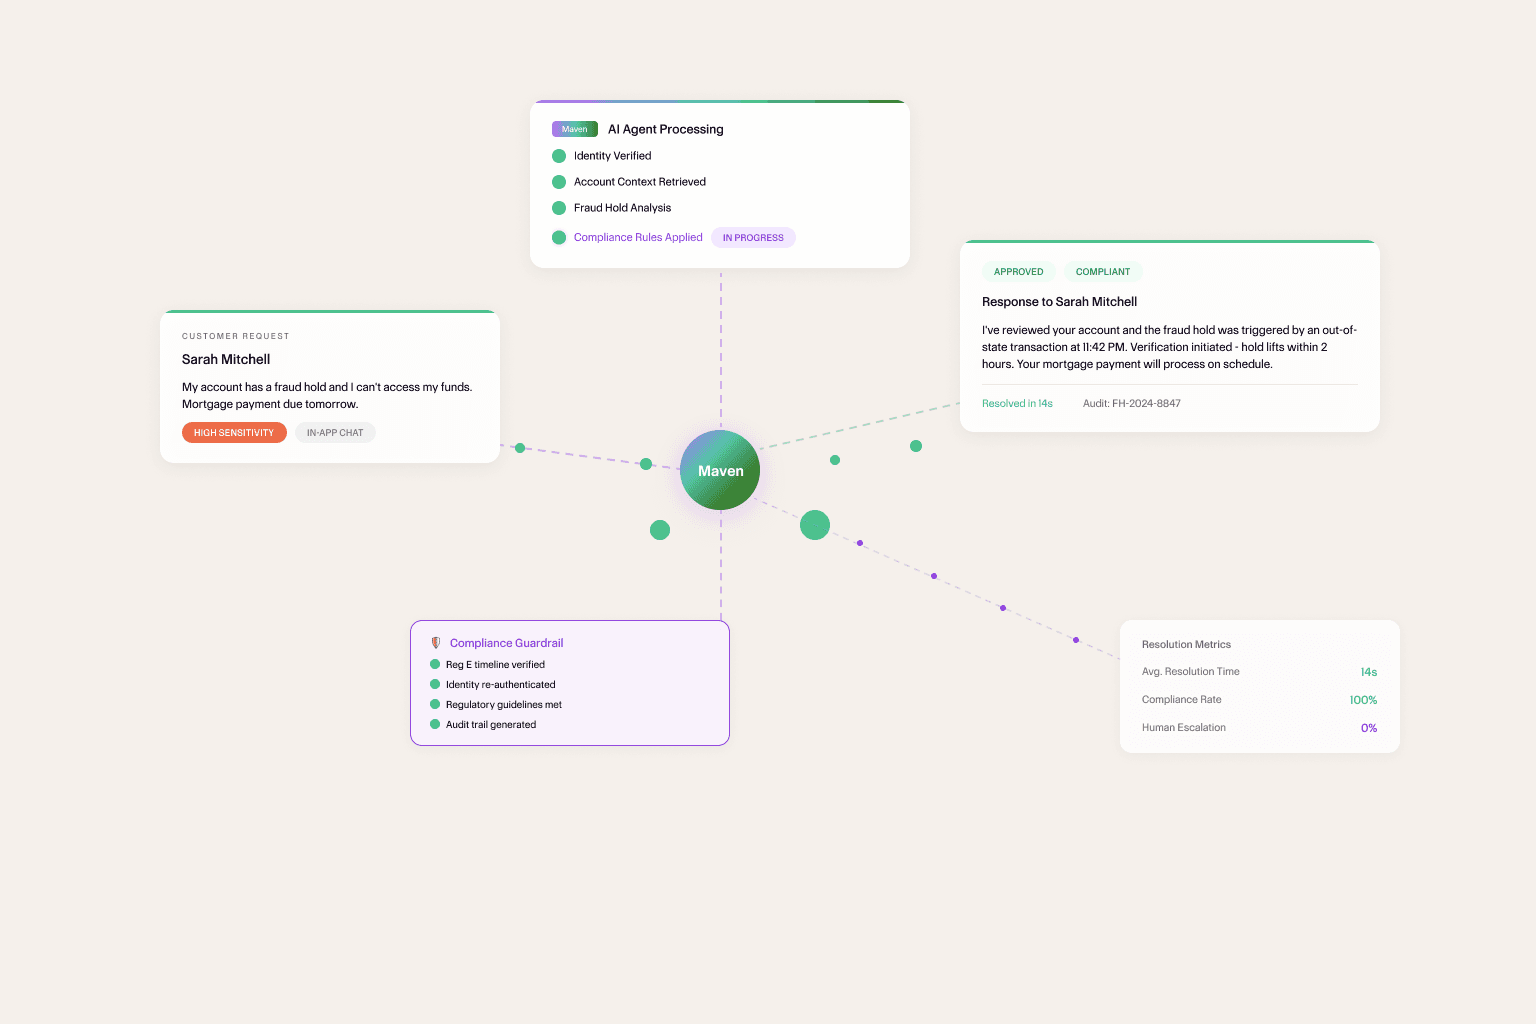
I dati finanziari sono tra le informazioni più sensibili che le persone condividono con qualsiasi piattaforma. Gli errori hanno conseguenze normative. Una risposta sbagliata su un blocco per frode o una contestazione gestita male non si limitano a frustrare un cliente: creano esposizione legale, compromettono la conformità normativa e generano quel tipo di attenzione mediatica che richiede anni per essere cancellata.
Per gran parte dell'ultimo decennio, i team di supporto FinTech hanno gestito le richieste sempre allo stesso modo: automatizzare i casi semplici, affidare agli operatori tutto ciò che è sensibile e accettare la struttura di costi che ne deriva.
Questo modello è sotto pressione. Non perché la posta in gioco sia cambiata, ma perché gli agenti AI sono maturati al punto che affidare tutto a un operatore non è più l'unico modo per gestire in sicurezza interazioni complesse e altamente sensibili. La domanda non è più se automatizzare, ma come progettare l'automazione in modo che sia davvero affidabile.
Il problema dei dati nel FinTech è strutturale
Ogni settore gestisce dati sensibili. Nel FinTech il problema è particolarmente acuto per come sono strutturati i dati e per quante parti diverse hanno diritti legittimi ma distinti su di essi.
Prendi una piattaforma che serve sia i titolari di conti business sia i loro dipendenti. Il titolare dell'azienda ha piena visibilità. Un dipendente titolare di carta vede solo le attività della propria carta. Entrambi sono utenti autenticati della stessa piattaforma. Entrambi potrebbero porre domande simili, come "perché questa transazione è stata rifiutata?", ma i dati che ciascuno è autorizzato a vedere e le azioni che ciascuno è autorizzato a compiere sono profondamente diversi.
Aggiungi un terzo livello: la piattaforma stessa, con team operativi interni, funzioni di compliance e analisti antifrode, ognuno dei quali ha bisogno di accedere ai dati dei conti secondo regole completamente diverse.
Non è un caso limite ipotetico. È il modello operativo standard di piattaforme di business banking, piattaforme di prestito, strumenti di gestione delle spese e provider di infrastrutture di pagamento. L'ambiente dei dati è condiviso. Le regole di accesso no.
Quando gli agenti AI entrano in questo ambiente con accessi ampi e senza regole rigide di idoneità per ciascun partecipante, il rischio di contaminazione incrociata è significativo. Non perché l'agente agisca in malafede, ma perché fa esattamente ciò per cui è stato progettato: trovare le informazioni più pertinenti e usarle per rispondere alla domanda.
Il problema è che pertinente e consentito non sono la stessa cosa.
Cosa succede quando l'AI nel FinTech sbaglia
Nel FinTech i modi in cui le cose possono andare storte sono versioni ad alto rischio degli stessi schemi che si ritrovano in qualsiasi piattaforma multi-sided.
Esposizione normativa. L'accesso ai dati finanziari è disciplinato da normative che impongono minimizzazione dei dati, limitazione delle finalità, consenso e verificabilità. Un agente che mostra i dati di un conto a un utente non autorizzato non genera solo un incidente di supporto, ma un potenziale evento di non conformità. "Il modello lo riteneva pertinente" non è una risposta che soddisfa un'autorità di vigilanza.
Fiducia dei titolari dei conti. I servizi finanziari si basano sulla fiducia come pochi altri settori. Nel momento in cui un utente inizia a chiedersi cos'altro sa di lui questa piattaforma e chi altro può vederlo, hai creato un problema che nessun punteggio CSAT è in grado di misurare.
Violazioni del controllo degli accessi interni. Gli analisti antifrode operano con regole di accesso diverse da quelle del customer support. I team di compliance hanno ambiti diversi da quelli degli account manager. Un agente AI che opera trasversalmente su tutte queste funzioni senza controlli espliciti di idoneità basati sui ruoli diventa un veicolo di violazioni degli accessi interni.
Errori decisionali ad alto impatto. Le interazioni in cui gli agenti AI sono più utili, come contestazioni per frode, pagamenti non riusciti e restrizioni sui conti, sono anche quelle in cui un errore ha le conseguenze più gravi. Un cliente che agisce sulla base di informazioni errate sulla procedura di risoluzione di una contestazione per frode genera responsabilità a valle di cui la piattaforma deve poi rispondere.
Il ripensamento in corso
Le piattaforme FinTech che guidano questo cambiamento architetturale non stanno rinunciando all'automazione. Stanno separando due elementi storicamente legati: la capacità di ragionamento dell'agente AI e il suo accesso ai dati.
L'intuizione è semplice. La capacità di un agente AI di comprendere il contesto, cogliere le sfumature e gestire interazioni complesse non dipende dall'avere accesso a tutto. Dipende dall'avere accesso alle cose giuste per il contesto in cui opera.
Da qui nasce un principio architetturale che, a posteriori, sembra ovvio: definire cosa è idoneo prima che l'agente recuperi qualsiasi informazione.
In pratica, ogni interazione inizia stabilendo il contesto: quale canale, quale utente autenticato, quale ruolo e quale insieme di policy sono attivi. Sulla base di questi input, la piattaforma determina quali dati rientrano nel perimetro e quali azioni sono consentite. L'agente opera quindi all'interno di quel perimetro con piena capacità di ragionamento.
Il titolare di un conto business che chiede informazioni sulle attività della carta di un collaboratore vede ciò che è autorizzato a vedere. Un dipendente titolare di carta che pone la stessa domanda vede solo i propri dati. Un analista di compliance che conduce una verifica opera con regole di accesso adeguate alla compliance. Stesso agente AI. Stesse capacità di base. Contesti di idoneità diversi, applicati a livello architetturale, prima che l'agente elabori qualsiasi informazione.
Questo approccio offre tre vantaggi specifici, fondamentali nel FinTech.
Verificabilità. Quando ogni interazione è delimitata da regole di idoneità esplicite, hai un registro chiaro dei dati a disposizione dell'agente per ogni singola interazione. "A quali dati ha avuto accesso l'agente?" diventa una domanda a cui puoi rispondere con precisione, non per approssimazione: esattamente ciò che richiede un'indagine delle autorità.
Applicazione coerente del controllo degli accessi. Il livello di idoneità non dipende dal fatto che l'agente ricordi le istruzioni o interpreti correttamente il contesto. È applicato a livello strutturale, quindi vale in modo coerente per ogni interazione, ogni caso limite, ogni input insolito.
Compliance scalabile. Quando arrivano nuove normative, e nel FinTech arrivano sempre, l'aggiornamento delle regole di idoneità a livello architetturale si propaga immediatamente a tutte le interazioni AI. Non devi riscrivere i prompt dei modelli né riaddestrare i sistemi. Le regole si applicano ovunque, automaticamente.
Il giudizio umano non scompare
C'è una cosa che il ripensamento architetturale non cambia: esistono interazioni in cui il giudizio umano è la scelta giusta, e un sistema AI ben progettato rende facile arrivarci.
Nel FinTech questi momenti sono prevedibili. Un cliente che contesta una valutazione di frode già esaminata dalla piattaforma. Il titolare di un conto business che mette in discussione un blocco per motivi di compliance. Un cliente di alto valore con una domanda complessa su più prodotti, che richiede valutazioni sulle policy di eccezione.
In queste interazioni, Agent Maven si occupa del recupero delle informazioni e della ricostruzione del contesto: aggiorna rapidamente l'operatore, mette in evidenza lo storico pertinente e segnala le domande chiave a cui rispondere, lasciando il giudizio finale e la comunicazione nelle mani delle persone.
L'escalation non è un malfunzionamento. È una funzionalità progettata di un'architettura di supporto AI matura. Costruirla in modo deliberato, con trigger chiari, passaggi fluidi e il contesto completo trasferito all'operatore, è ciò che distingue le implementazioni AI che reggono a un esame approfondito da quelle che generano incidenti proprio quando la posta in gioco è più alta.
Dalla riduzione dei costi all'infrastruttura di fiducia
Inizialmente l'AI nel supporto FinTech veniva vista quasi solo in termini di costi: tassi di deflection, riduzione dei ticket, ore di lavoro risparmiate. Sono metriche reali e importanti, ma colgono solo una parte di ciò che è in gioco.
Le piattaforme FinTech che ottengono il valore più duraturo dall'AI non puntano principalmente a ridurre i costi. Stanno costruendo qualcosa di più difficile da replicare: un'infrastruttura di supporto di cui ogni gruppo di partecipanti, che siano clienti, titolari di conti, clienti business o team interni, può fidarsi per una gestione appropriata dei propri dati e coerente delle proprie interazioni.
È un obiettivo di progettazione diverso dalla deflection, e per raggiungerlo serve un'architettura diversa. Un'architettura in cui il controllo degli accessi non è un'aggiunta posticcia a un modello capace, ma un livello fondamentale su cui poggiano le capacità del modello.
Le piattaforme che investono oggi in questa architettura non stanno solo risolvendo il problema attuale della governance dell'AI. Stanno costruendo un'infrastruttura che rende affidabile per impostazione predefinita ogni futura capacità AI, perché il livello di idoneità che governa l'agente di supporto di oggi governerà anche quello, più evoluto, di domani.
Nel FinTech la fiducia non è una funzionalità. È il prodotto.
Mettilo alla prova sulle tue conversazioni.
Richiedi una demo personalizzata gratuita.


