
Nella progettazione della maggior parte degli agenti AI c'è un presupposto che quasi nessuno mette in discussione: se un dato è pertinente per rispondere a una domanda, l'agente deve poterlo usare.
Sembra ragionevole, ma è sbagliato.
Per le organizzazioni che gestiscono piattaforme con più gruppi di partecipanti, come clienti e merchant, passeggeri e autisti, clienti e fornitori di servizi, è proprio questo presupposto a trasformare silenziosamente i progetti di AI in problemi di fiducia.
La trappola della pertinenza
Un cliente contatta l'assistenza per una consegna in ritardo. Vuole sapere cosa è successo e chiede un rimborso.
Le informazioni più pertinenti includono i tempi medi di preparazione del ristorante, la finestra di preparazione specifica di quell'ordine, lo storico dei percorsi dell'autista ed eventuali segnalazioni emerse durante l'evasione. Sono tutte direttamente utili e portano a una risposta migliore e più precisa.
Ma così si esporrebbero i dati sulle performance operative di un ristorante a un cliente che non ha alcun titolo per vederli. Si chiamerebbe in causa il comportamento di un autista senza alcuna verifica. Si creerebbe un collegamento diretto tra l'esito di una parte e i dati di un'altra, senza che nessuna delle due ne sia a conoscenza o abbia dato il consenso.
L'agente non ha sbagliato: ha fatto esattamente ciò per cui era stato progettato, cioè trovare ciò che è pertinente e usarlo. L'errore è stato presumere che pertinenza e autorizzazione siano la stessa cosa.
Perché questa distinzione è più complessa di quanto sembri
In un prodotto single-sided, pertinenza e autorizzazione coincidono quasi sempre. Chi pone la domanda è anche la persona i cui dati sono in gioco. Lo scarto tra ciò che è utile e ciò che è consentito è così ridotto che la maggior parte degli agenti lo gestisce senza problemi.
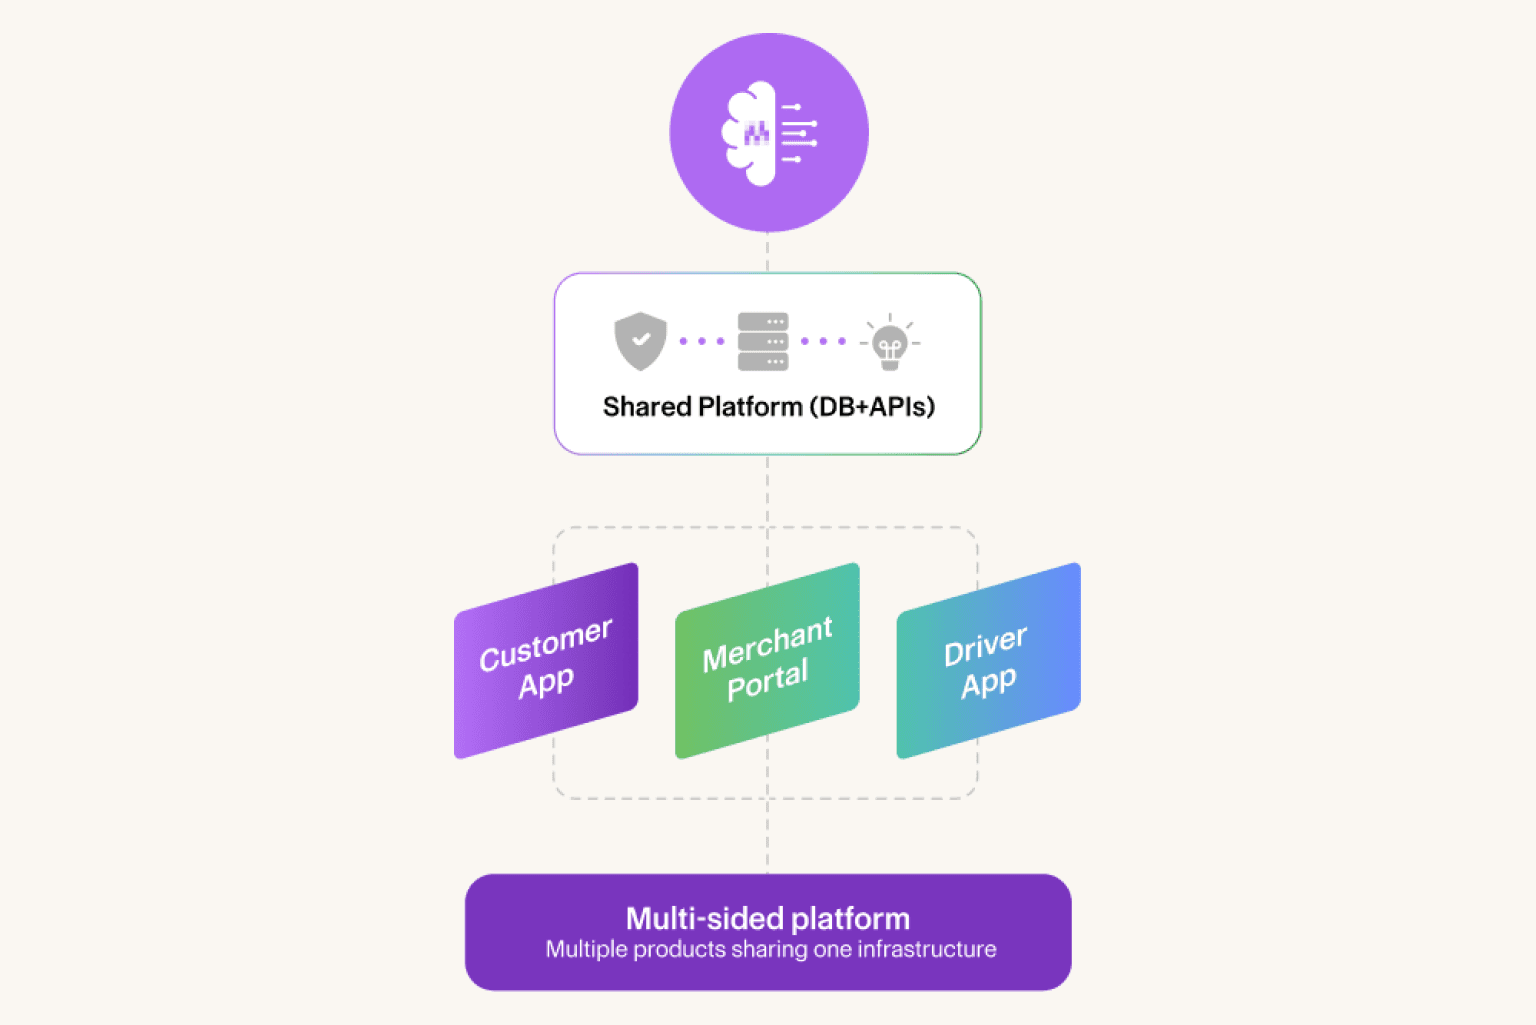
Le piattaforme multi-sided fanno saltare del tutto questo presupposto.
Ogni gruppo di partecipanti ha i propri dati, flussi di lavoro, aspettative di privacy e una propria idea di esito equo. Quando un agente AI opera su tutti questi gruppi a partire da una knowledge base condivisa, non si muove in un unico ambiente di dati, ma in diversi contemporaneamente, senza confini netti tra l'uno e l'altro.
Emergono sistematicamente tre modalità di errore:
Fuga di dati tra le interfacce. Informazioni pertinenti su un'interfaccia appartengono a un partecipante di un'altra. Un agente per i clienti che vede lo storico delle contestazioni dei merchant, un portale merchant che mostra i dettagli dei reclami dei clienti o un'interfaccia per gli autisti che fa riferimento a dati sulle sanzioni a livello di piattaforma.
Azioni con conseguenze non verificate altrove. Un rimborso emesso sull'interfaccia cliente genera una trattenuta sul pagamento al merchant. Un agente AI che può compiere la prima azione ma non vede la seconda conseguenza prenderà decisioni apparentemente sensate che creano problemi di cui non verrà mai a conoscenza. Il ciclo di feedback non si chiude.
Trattamento incoerente tra gruppi di partecipanti. La stessa domanda di fondo, "perché il mio pagamento è stato ridotto?", ha un significato completamente diverso a seconda che a porla sia un merchant o un autista. I dati ammissibili, la risposta appropriata e le azioni consentite sono tutti diversi. Un agente senza confini netti tra le interfacce produce risposte tecnicamente corrette ma sbagliate nel contesto.
Nessuno di questi errori è colpa dell'agente AI: sono errori di architettura. Nessuno ha mai detto all'agente dove fossero i limiti.
La pertinenza è un punto di partenza, non un'autorizzazione
Ecco il cambio di prospettiva che conta: la pertinenza deve orientare ciò che l'agente cerca, ma è l'ammissibilità a stabilire ciò a cui può effettivamente accedere.
Due domande distinte, a cui rispondere in sequenza.
L'ammissibilità viene prima. Prima che un agente recuperi qualsiasi cosa, la piattaforma deve aver già risposto a queste domande: da quale interfaccia arriva l'interazione? Quale gruppo di partecipanti è autenticato? Quali dati e azioni rientrano nel perimetro di questa interfaccia, di questo ruolo, di questo contesto di policy? Cosa è escluso a priori, per quanto possa essere pertinente?
Non sono domande su cui deve ragionare il modello. Sono vincoli che la piattaforma applica in modo deterministico, prima che l'agente entri in azione. La pertinenza opera poi all'interno di questi vincoli, non al loro posto.
L'effetto pratico è notevole. Un agente limitato all'interfaccia cliente non può esporre per errore i dati dei merchant. Non perché gli sia stato detto di non farlo, ma perché quei dati non sono mai stati ammissibili. Le istruzioni nel prompt si possono aggirare. I vincoli di ammissibilità no.
Questa distinzione conta più di quanto sembri. "Non dovrebbe usarli" e "non può accedervi" non offrono lo stesso livello di protezione. Su larga scala, in ambienti complessi e con casi limite reali, regge solo il secondo.
Cosa significa in pratica
Le piattaforme che affrontano bene il problema non creano agenti più restrittivi, ma agenti con un'architettura migliore. La capacità di ragionamento dell'agente resta invariata; a cambiare è l'interfaccia su cui ragiona.
Il risultato non è un agente meno capace, ma un agente di cui ci si può fidare in tutti i gruppi di partecipanti contemporaneamente. Sulle piattaforme multi-sided, è questa la capacità che scala.
La pertinenza ti porta a una buona risposta. L'ammissibilità ti porta a una risposta affidabile.
Mettilo alla prova sulle tue conversazioni.
Richiedi una demo personalizzata gratuita.


