
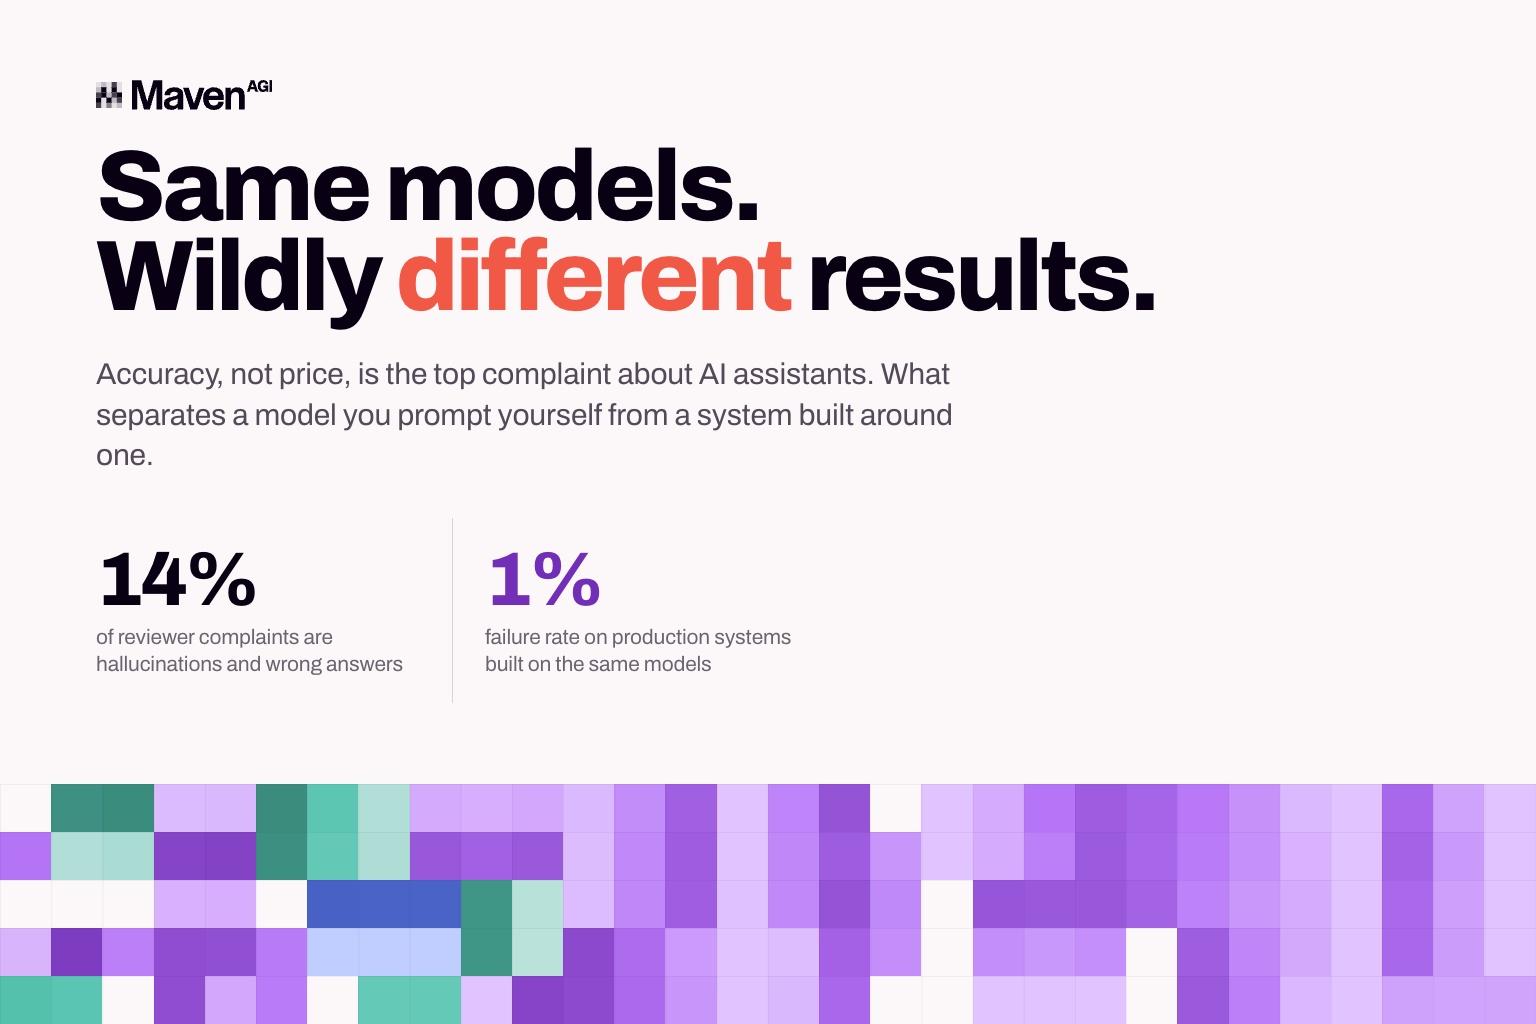
راجعت G2 أكثر من 2,950 مراجعة موثّقة نُشرت بين يناير ومنتصف يوليو، وبحثت فيما يشتكي منه المستخدمون أكثر من غيره. ولم تكن الشكوى الأكبر من السعر، بل من الدقة. فقد شكّلت الهلوسات والإجابات الخاطئة 14% من كل ما قال المراجعون إنه لم يعجبهم، لتتقدّم على التكلفة في عام لا يكاد يدور فيه نقاش إلا حول التكلفة.
من المفيد معرفة هوية هؤلاء المراجعين، لأن ذلك يغيّر دلالة الرقم. فمعظمهم يتحدثون عن المساعدات العامة التي يفتحها الجميع في علامة تبويب بالمتصفح. وهم ليسوا فرق تجربة العملاء التي تصف وكيل دعم يعمل فعليًا في بيئة الإنتاج، بل أشخاص يطرحون سؤالًا على نموذج، فيتلقّون إجابة واثقة، ثم يتعيّن عليهم أن يتحقّقوا بأنفسهم من صحتها.
ثم توجّهت G2 إلى 4 مورّدين يبنون أنظمة إنتاج على النماذج نفسها، وسألتهم عن معدلات الإخفاق الفعلية لديهم. فكانت منخفضة إلى حدّ 1%.
إذن، ما تجري مقارنته فعلًا ليس نموذجًا بنموذج آخر، بل نموذج يُوجَّه مباشرة مقابل نظام بناه أحدهم حول نموذج: التقنية نفسها في الأساس، والنتائج مختلفة جذريًا. وكانت Maven أحد المورّدين الأربعة الذين سألتهم G2.
ما الذي يقف وراء هذه الفجوة
لم يكن لأيّ مما وصفه هؤلاء المورّدون علاقة بالنموذج الذي اختاروه. فقد قالوا جميعًا الشيء نفسه تقريبًا: تعمل أنظمتهم على مراحل بدلًا من محاولة واحدة، وتُستمدّ الإجابات من بيانات حية لا مما يتذكّره النموذج من تدريبه. كما يقيسون عدد المرات التي تُنجَز فيها المهمة فعلًا، ويعيدون كتابة التعليمات والمنطق مرة واحدة أسبوعيًا على الأقل، بل إن أحدهم يفعل ذلك يوميًا. وكل هذا عمل يجري حول النموذج، لا عليه.
والأهم مما اتفقوا عليه هو موضع الجهد. فقد أكدوا جميعًا أن الصعوبة لا تكمن في الأسئلة اليومية، بل في الحالات الاستثنائية والمهام متعددة الخطوات؛ لذا يبنون أنظمة تدرك متى تتجاوز المسألة قدراتها، فتحيل المحادثة إلى شخص بدلًا من التخمين. وجاء في ردّ Maven على الاستطلاع أن «الاستقلالية من دون منطق احتياطي موثوق ليست ميزة، بل عبء».
هنا يكمن معظم الفجوة. فعندما توجّهون النموذج بأنفسكم، تكونون أنتم من يتحقق من عمله. أما نظام الإنتاج فمبنيّ بحيث لا تقع هذه المهمة على عاتق العميل أبدًا. وقد عبّرت G2 عن ذلك بوضوح: هؤلاء المورّدون لا يواجهون إخفاقات أقل، بل يلتقطونها قبل أن يلاحظها أحد.
الجدل بين الوكيل وروبوت المحادثة مسألة تسميات في الغالب
سألت G2 المورّدين الأربعة مباشرة عمّا إذا كان وكلاء الذكاء الاصطناعي أكثر موثوقية مما لا تزال هذه الفئة تسمّيه روبوتات المحادثة. فجاءت إجاباتهم متقاربة، وهي ليست خبرًا سارًّا لمن يبيع اعتمادًا على المصطلح. ففي بيئة الإنتاج، لا يختلف الاثنان بالقدر الذي يوحي به التسويق، واستبدال تسمية بأخرى لا يحلّ شيئًا في حدّ ذاته.
وهذا يهمّ المشترين أكثر مما يهمّ المورّدين. فإذا كنتم تبحثون عن كلمة «وكيل»، فأنتم تشترون تسمية لا قدرة. وأن يسمّي مورّد منتجه وكيلًا ويسمّيه آخر شيئًا مختلفًا لا يخبركم بشيء عمّا إذا كان أيّ منهما يبحث في معارفكم الحالية، أو يدرك متى لا يكون متأكدًا، أو يخضع للتحقق مقابل محادثات حقيقية بعد الإطلاق. تلك خصائص الذكاء الاصطناعي الوكيلي في خدمة العملاء، ولا تأتي أيّ منها مع التسمية.
أما الأسئلة التي تكشف لكم شيئًا فعلًا فتتعلق بطريقة بناء النظام، ويمكنكم طرحها جميعًا في الاتصال الأول.
- من أين تأتي الإجابات؟ هل يبحث في معارفكم الحية، أم يعتمد على ما استوعبه النموذج أثناء التدريب؟
- ماذا يحدث عندما لا يكون متأكدًا؟ هل يحيل المحادثة، أم يخمّن بالنبرة الواثقة نفسها التي يستخدمها حين يكون محقًا؟
- كم مرة يراجع أحدٌ إجاباته مقابل محادثات حقيقية، وما الذي يُقاس؟
- هل يستطيع فريقكم تغيير سلوك الوكيل، أم يتطلب كل تعديل الرجوع إلى المورّد؟
- هل يستطيع تنفيذ إجراء فعلي في أنظمتكم، أم يكتفي بإخبار العميل بما عليه فعله؟
إذا استطاع المورّد الإجابة عن هذه الأسئلة كلها، فهناك من أنجز العمل. وإذا أجاب عن الأول بإتقان ثم بدأ الغموض بعده، فقد اشترى نموذجًا ووضع حوله واجهة. وتجدون نسخة أطول من هذه القائمة في دليلنا حول تقييم وكلاء الذكاء الاصطناعي لخدمة العملاء في المؤسسات.
الأجزاء التي يتجاهلها المشترون
ما وصفه المورّدون الأربعة هو الأساس نفسه الذي بُنيت عليه بنية Maven المكوّنة من 5 طبقات. فالنموذج طبقة واحدة، وكل ما يجعله موثوقًا يحيط به: ما يعرفه الوكيل، وما يُسمح له بفعله، وكيف تتحققون من عمله بعد إطلاقه، ومن يتحكم في الضوابط. وعادةً ما يركّز المشترون على النموذج، لأنه الطبقة المرتبطة بالأسماء الشهيرة. لكن كل ما تشير إليه بيانات G2 يقع في الطبقات الأخرى، وهو السبب في أن الحلّ المستقل أمر مختلف عن مجرد إجابة جيدة.
ولهذا أيضًا لا تتعارض سرعة النشر مع الموثوقية، مهما افترضت هذه الفئة خلاف ذلك. فبناء هذه الطبقات عمل هندسي حقيقي، لكنه يُنجز مرة واحدة داخل المنصة، بدلًا من أن يتحول إلى مشروع يستغرق 6 أشهر داخل البنية التقنية لكل عميل.
كيف يبدو الأمر حين يكون العمل قد أُنجز
وصلت Mastermind إلى نسبة حلّ مستقل بلغت 93% خلال 6 أسابيع. وحققت K1x نسبة 80% في أسبوعها الأول. وحافظت Rho على نسبة CSAT بلغت 95% مع استيعاب زيادة شهرية بنسبة 12% في حجم التواصل دون توظيف أي شخص. أما Quest فبنت AskQ على Maven، وربطته بقاعدة معارف ونظام حالات قائمين بالفعل دون أي ترحيل للبيانات، وتقيّمه بناءً على رضا العملاء لا على معدل تفادي التواصل.
وتشير مراجعات Maven نفسها إلى الاتجاه ذاته: 4.8 من 5 عبر 20 مراجعة موثّقة، ومن المفيد قراءة ما يذكره المستخدمون فعلًا: محرك واحد يتولى الدردشة والبريد الإلكتروني والصوت بدلًا من روبوتات منفصلة يجب إبقاؤها متزامنة؛ واسترجاع للمعارف يرصد المقالات القديمة والمكررة والمتعارضة بدلًا من الإجابة من أول مقال يعثر عليه؛ وإعداد يُقاس بالأيام فوق Salesforce أو Zendesk. وكل ذلك من الأجزاء المحيطة بالنموذج.
وفي تقارير G2 لخريف 2026 الصادرة في 25 أغسطس، حلّت Maven ضمن Mid-Market Grid for Customer Service Automation، وMid-Market Results Index for AI Customer Support Agents، وImplementation Index for AI Customer Support Agents. وتستند تقارير المؤشرات إلى ما يقوله العملاء عن النتائج التي حققوها وسير عملية الإطلاق، لا إلى حجم الشركة أو شهرتها. فهي تقيس تحديدًا ما تقول بيانات G2 الأوسع إنه يتعثّر في كل مكان آخر.
الفجوة هي القصة
الرقم الجدير بالاهتمام هو المسافة بين 14% و1%، لأن كليهما يعتمد على العدد القليل نفسه من النماذج. ولا شيء في التقنية يفسّر فجوة بهذا الحجم. ما يفسّرها هو ما إذا كان أحدٌ قد اهتم ببناء الأجزاء التي تلتقط الإجابة الخاطئة قبل أن يراها العميل، ولهذا لا يكون لـمعدل الحل معنى إلا حين تعرفون كيف قيس.
لا يزال معظم المشترين يقارنون أسماء النماذج. أما المورّدون الأربعة الذين تحدثت إليهم G2 فقد تجاوزوا ذلك منذ مدة.
وإن أردتم رؤية هذه الطبقات بدلًا من القراءة عنها، احجز عرضًا توضيحيًا.
شاهدوه على محادثاتكم الفعلية.
اطلبوا عرضًا توضيحيًا مخصصًا ومجانيًا.


