
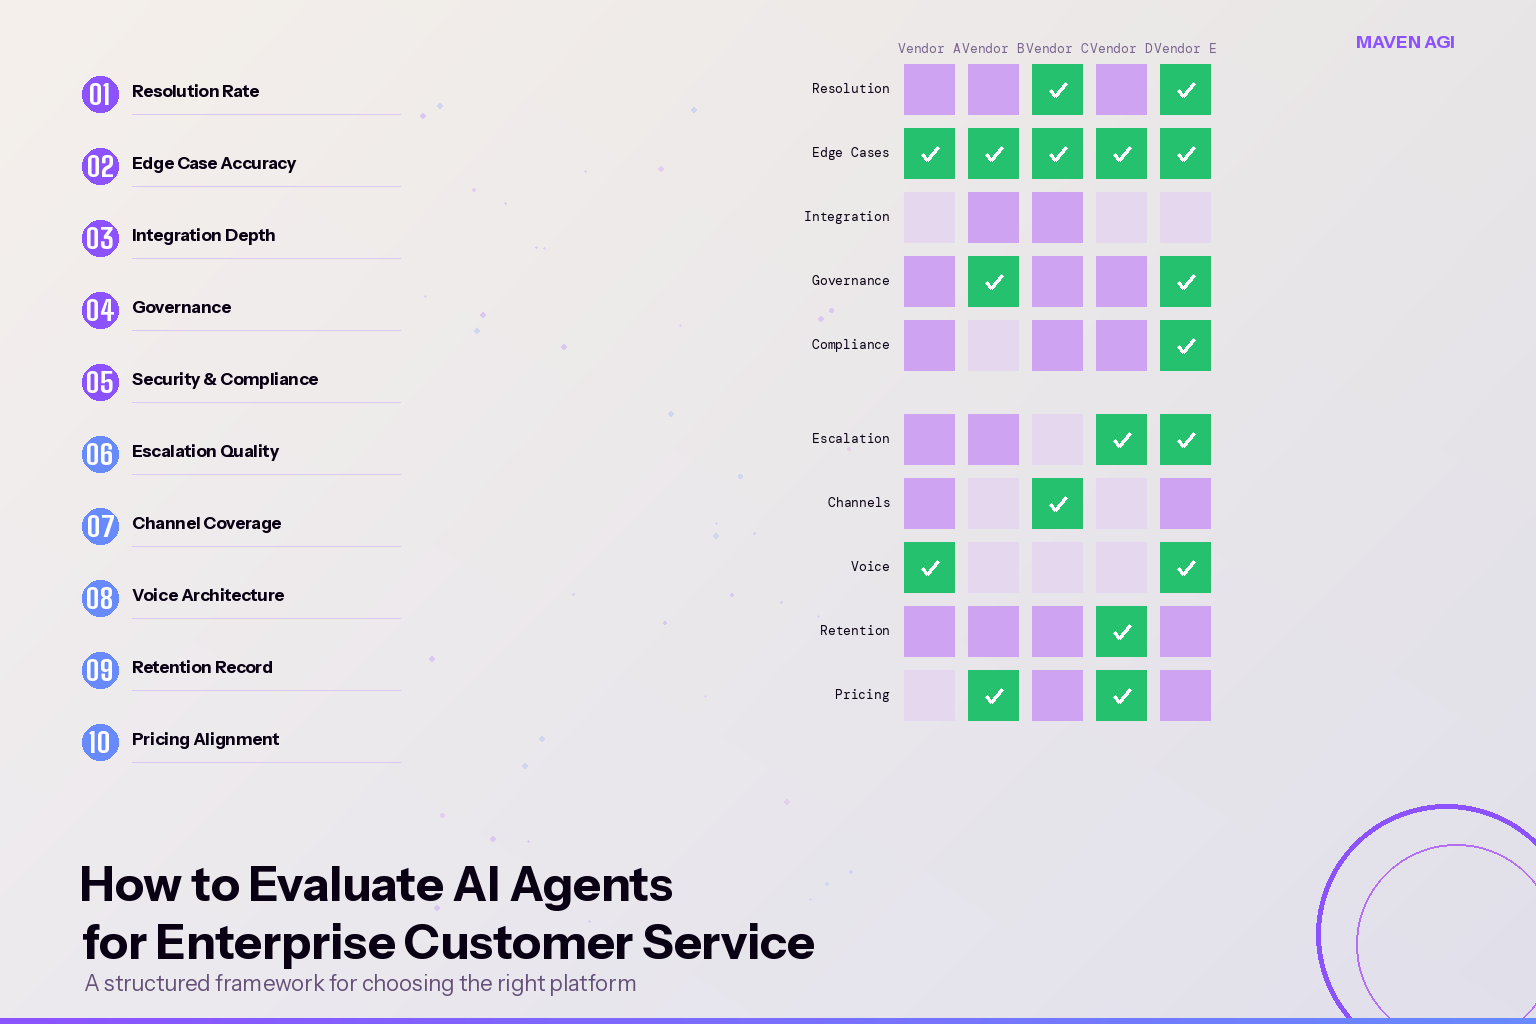
وصل سوق وكلاء الذكاء الاصطناعي للمؤسسات إلى مرحلة من النضج لا يُعوزه فيها موردون يدّعون تحقيق نتائج قوية. فبيئات إثبات المفهوم تُنتج بانتظام أرقامًا لافتة، بمعدلات أتمتة تبلغ 80% أو 90%، ومع ذلك فإن عمليات النشر التي تحافظ على هذه النتائج في بيئة الإنتاج أندر بكثير. هذه الفجوة متوقعة إن كنتم تعرفون ما الذي تبحثون عنه، لكنها تكاد تكون غير مرئية إن أجريتم تقييمًا تقليديًا.
الفرق بين الفرق التي تُحسن هذا الأمر وغيرها لا يكمن في العرض التوضيحي، بل في مدى اختبارها للمنصة تحت الضغط على المتغيرات التي تحدد الأداء في الإنتاج. يقدّم هذا الدليل إجابة عملية عن كيفية تقييم منصات خدمة العملاء بالذكاء الاصطناعي دون الانخداع بانطباع أول مصقول، وكيفية اختيار أفضل منصة لخدمة العملاء بالذكاء الاصطناعي لنشر مؤسسي يجب أن يصمد أمام أحجام العمل الحقيقية. وهو مبني حول الأسئلة التي تميّز المنصات المصممة للإنتاج عن تلك المصممة لتبدو جيدة في العروض التوضيحية. وإن كان من المفيد الانطلاق من حالات استخدام خدمة العملاء التي تديرونها فعليًا، فابدأوا من هناك ثم استخلصوا المعايير.
ابدأوا بفهم ما تقيّمونه فعلًا
تبدأ معظم تقييمات الموردين بطلب عرض توضيحي وتنتهي بمكالمة مرجعية. وقد صُممت هذه العملية لبرمجيات تؤدي ما تُهيّأ لأدائه. أما وكلاء الذكاء الاصطناعي فمختلفون: فأداؤهم في عرض خاضع للتحكم غالبًا ما تكون قيمته محدودة في التنبؤ بأدائهم في الإنتاج. والمتغيرات الأهم في الإنتاج، أي توزيع الاستفسارات، وتكرار الحالات الاستثنائية، وموثوقية التكامل، والسلوك تحت الضغط، هي تحديدًا المتغيرات التي تُصمَّم العروض التوضيحية لتجنّبها.
قبل إجراء أي تقييم، من المفيد أن تتضح لديكم 3 أمور.
ماذا يعني الحل بالنسبة إلى حالة استخدامكم؟ ليس تحويل الاستفسارات ولا احتواءها. فـالحل الذاتي يعني أن مشكلة العميل قد حُلّت، وأنه لم يعد للتواصل بشأن المسألة نفسها، وأن الذكاء الاصطناعي نفّذ الإجراء دون الحاجة إلى موظف بشري لإكماله. وإن لم تتمكنوا من تعريف ذلك بدقة لمنتجكم قبل بدء التقييم، فسيصعب تفسير أي معيار مرجعي يقدمه المورد.
كيف يبدو الإخفاق؟ وكيل الذكاء الاصطناعي الذي يتعامل جيدًا مع 80% من التفاعلات لكنه يسيء التعامل مع الـ20% الأخرى بطرق تُضعف الثقة لا يُعدّ نجاحًا في النشر. ومعرفة أنماط الإخفاق لديكم، كالمبالغ المستردة الخاطئة، والتغييرات غير الصحيحة في الحسابات، والتصعيدات التي يضيع فيها السياق، تتيح لكم إدراجها في التقييم بدلًا من اكتشافها بعد الإطلاق.
ما واقع التكامل لديكم؟ تعود فجوة الأداء بين بيئة الاختبار المعزولة والإنتاج دائمًا تقريبًا إلى التكامل. فالوكيل الذي يُقيَّم على عينة من قاعدة معارفكم سيتصرف بشكل مختلف عن وكيل متصل بنظام CRM الفعلي ونظام التذاكر ومنصة الفوترة لديكم. وكلما تمكنتم من الاختبار مبكرًا مع وصول فعلي إلى الأنظمة، زادت قدرة النتائج على التنبؤ.
الأسئلة التي تكشف الجاهزية الحقيقية للإنتاج
تميل تقييمات الموردين التقليدية إلى التمحور حول الميزات والأسعار. أما هذه الأسئلة فمصممة لكشف أمر أكثر تحديدًا: هل المنصة مصممة وفق الطريقة التي يعمل بها الدعم المؤسسي فعلًا؟
كيف تعرّفون الحل الذاتي، وكيف تقيسونه؟ تكشف الإجابة أكثر مما يكشفه أي معيار مرجعي. فالموردون ذوو الخبرة الحقيقية في الإنتاج لديهم تعريفات محددة ومنهجيات قياس محددة، ويميّزون بين التذاكر التي أغلقها الذكاء الاصطناعي، والتذاكر المحوّلة إلى الخدمة الذاتية، والتذاكر التي وصلت إلى موظف بشري. أما الموردون الذين يركزون على الأداء في العروض التوضيحية فيميلون إلى الخلط بينها. اطلبوا منهم شرح كيفية تصنيف التذكرة المحلولة مقارنةً بالتذكرة المحوّلة في نظامهم.
ما معدل إعادة التواصل خلال 72 ساعة؟ هذا هو المقياس الذي يكشف الحل الزائف. فإذا أدّت نسبة كبيرة من التفاعلات المصنّفة محلولة إلى عودة العميل نفسه للتواصل مع الدعم خلال 3 أيام، فإن معدل الحل الفعلي أقل من الرقم المعلن. وهو التمييز ذاته الذي يفصل التحويل عن الحل. يتتبّع الموردون المركّزون على الإنتاج هذا المقياس، ومن لا يتتبعه يقيس الشيء الخطأ.
هل يستطيع الوكيل تنفيذ إجراءات في أنظمتي الخلفية، أم يقتصر على عرض المعلومات؟ التكامل للقراءة فقط مقابل القراءة والكتابة هو الخط الفاصل في البنية. فالوكيل الذي يستطيع إخبار العميل بأن طلبه متأخر لكنه لا يستطيع إعادة جدولة الشحنة لا يحلّ المشكلة، بل يجيب عن سؤال. وفي معظم حالات استخدام الدعم المؤسسي، يتطلب الحل الحقيقي صلاحية الكتابة في 2 أو 3 أنظمة خلفية على الأقل. اسألوا عن عمليات التكامل المتاحة عبر موصلات جاهزة وتلك التي تتطلب تطويرًا مخصصًا.
كيف يعمل التصعيد، وماذا يحدث للسياق؟ لحظة التصعيد هي الموضع الذي تُحدث فيه معظم عمليات نشر الذكاء الاصطناعي احتكاكًا بدلًا من إزالته. فعندما يسلّم الوكيل المحادثة إلى موظف بشري، هل يتلقى الموظف ملخصًا للمحادثة وسجل حساب العميل، أم يضطر العميل إلى البدء من جديد؟ اختبروا ذلك تحديدًا أثناء التقييم، فهو التفاعل الأكثر توليدًا للشكاوى، والأكثر تجاهلًا في العروض التوضيحية.
ماذا يفعل الوكيل حين لا يعرف الإجابة؟ الإخفاق بسلاسة لا يقل أهمية عن الأداء القوي. راقبوا كيف يتعامل النظام مع الاستفسارات الخارجة عن نطاق تدريبه، والطلبات الغامضة، والمحاولات المتعمدة لدفعه إلى مخرجات سيئة. الموردون الواثقون من تعاملهم مع هذه الحالات سيسمحون لكم باختبارها أثناء التقييم، أما من يتجنبون هذه الاختبارات فعادةً ما يكون لديهم سبب.
كم يستغرق التكامل؟ إذا كانت الإجابة الصادقة أشهرًا، فهذه معلومة مفيدة. فعمليات النشر المؤسسية التي تتطلب ارتباطات مطوّلة بالخدمات المهنية قبل التشغيل الفعلي تنطوي على تكلفة ومخاطر كبيرة. أما البنية التراكبية التي تتصل بأنظمة مكتب المساعدة القائمة دون الحاجة إلى ترحيل البيانات فيمكنها غالبًا بدء التشغيل خلال أسابيع. اطلبوا جداول زمنية محددة من توقيع العقد حتى أول تفاعلات فعلية.
فخ إثبات المفهوم
تكاد مشاريع إثبات المفهوم (POC) تكون حاضرة في جميع تقييمات الذكاء الاصطناعي المؤسسية، وهي تُنتج دائمًا تقريبًا نتائج أفضل من عمليات النشر في الإنتاج. وليس ذلك من قبيل المصادفة. فهي تعمل على بيانات نظيفة ونطاق محدود من الاستفسارات ودعم من جانب المورد، وتُضبط خصيصًا للتقييم. أما عمليات النشر في الإنتاج فتعمل على التوزيع الكامل لاستفسارات العملاء، وتتصل بأنظمة لم تُصمَّم قط للعمل مع الذكاء الاصطناعي، وتديرها فرق لديها مهام أخرى.
لسدّ هذه الفجوة، اطلبوا شروطًا لإثبات المفهوم تشبه الإنتاج فعلًا. شغّلوه على استفسارات حية من قاعدة عملائكم الفعلية، لا على عينة. واربطوه بأنظمة مكافئة لأنظمة الإنتاج، لا ببيئة اختبار معزولة. وشغّلوه مدة كافية لرؤية استقرار الأداء، لا فترة الضبط الأولية فحسب. واسألوا عن نسبة الاستفسارات خلال إثبات المفهوم التي كانت ضمن النطاق المهيّأ مسبقًا مقارنةً بتلك الخارجة عنه. فمعظم المشاريع التجريبية التي تبدو جيدة في العرض التوضيحي لا تصل أبدًا إلى الإنتاج، وأسباب ذلك متسقة بما يكفي للتخطيط لها؛ ويتناول تحليل الفجوة بين المشروع التجريبي والإنتاج ما يفصل بينهما.
الموردون المستعدون لإجراء إثبات المفهوم وفق هذه الشروط هم من يبنون للإنتاج. أما من يصرّون على التحكم الدقيق في الشروط فهم يحسّنون أداءهم لإثبات المفهوم ذاته.
كيف يبدو التقييم الصارم عمليًا
تأتي أقوى التقييمات من الفرق التي تتعامل مع اختيار المورد بوصفه قرارًا هندسيًا لا إجراءً شكليًا للمشتريات. فعندما سعت Clio، منصة التكنولوجيا القانونية، إلى استبدال روبوت قديم قائم على سيناريوهات مبرمجة، قيّم الفريق 32 موردًا، ثم أجرى مقارنة مباشرة بين أكثر من 10 منهم قبل اختيار Maven. واختبر الفريق الموردين وفق متطلباته الحقيقية: إجابات دقيقة عن استفسارات الدردشة داخل التطبيق، وتكامل عميق مع منظومته الحالية بما فيها Salesforce، والأداء في الحالات الاستثنائية التي تُعطّل الأنظمة المبرمجة مسبقًا.
وصمدت النتيجة في الإنتاج، لا في العرض التوضيحي فحسب: 80% حل ذاتي، ودعم مباشر أسرع بـ4 أضعاف للأسئلة التقنية التي لا تزال تصل إلى موظف بشري. هذا المزيج، أي معدل حل ذاتي مرتفع مقرون بمعالجة أسرع للاستثناءات، هو السمة المميزة لتقييم اختُبر للإنتاج لا لانطباع أول مصقول. وهو أيضًا القاسم المشترك بين أقوى فرق تجربة العملاء، إذ تصمم التقييم لاكتشاف نقاط الإخفاق قبل التوقيع، لا بعده.
الامتثال ليس إضافة ثانوية
في معظم عمليات النشر المؤسسية، يمر الطريق من إثبات المفهوم إلى الإنتاج عبر المراجعة الأمنية. وهنا تتعثر كثير من تقييمات وكلاء الذكاء الاصطناعي أو تفشل تمامًا. فمتطلبات الامتثال لوكيل ذكاء اصطناعي يتعامل ذاتيًا مع بيانات العملاء، ويعالج المعاملات، وينفذ إجراءات في أنظمة الإنتاج متطلبات كبيرة، ومعظم المؤسسات ليست جاهزة بالقدر الذي تظنه. ففي استطلاع أجرته Grant Thornton عام 2026، قال 78% من القادة إنهم يفتقرون إلى الثقة في قدرتهم على اجتياز تدقيق للذكاء الاصطناعي خلال 90 يومًا.
قيّموا وضع الامتثال مبكرًا، لا كنقطة تحقق نهائية. وتحديدًا: هل يحمل المورد شهادة SOC 2 Type II، وهل تتوفر اتفاقية HIPAA BAA، واتفاقيات معالجة البيانات وفق GDPR، والامتثال لـPCI-DSS في أي سير عمل مرتبط بالمدفوعات. وهل تتوفر سجلات تدقيق قابلة للاستعلام لكل إجراء ينفذه الوكيل. وهل جرى تقييم المعالجين الفرعيين لدى المورد والإفصاح عنهم. وهل يمكن للمنصة العمل ضمن متطلبات إقامة البيانات لديكم.
سيجيب الموردون الذين يمتلكون بنية امتثال مؤسسية حقيقية عن هذه الأسئلة بالوثائق، لا بالتطمينات. أما من يتعاملون مع الامتثال كبند يُستوفى في مرحلة متأخرة، فهم الأكثر عرضة للإخفاق في المراجعة الأمنية بعد أن تكونوا قد استثمرتم بالفعل في التقييم.
المكالمة المرجعية التي ينبغي أن تطلبوها
تُنظَّم معظم المكالمات المرجعية مع الموردين لتأكيد التجارب الإيجابية. بدلًا من ذلك، اطلبوا مكالمة مرجعية مع عميل مرّ بعملية نشر صعبة تطلّبت قدرًا كبيرًا من استكشاف الأخطاء وإصلاحها قبل أن تحقق أداءً جيدًا. فطريقة تعامل المورد مع تلك العملية تكشف لكم أكثر مما تكشفه 3 عمليات سلسة.
واسألوا العميل المرجعي تحديدًا عمّا حدث من أخطاء، وكم استغرق حلّها، وهل حصل على الدعم الذي احتاجه. فالإجابات تحدد ما إذا كنتم سترغبون في العمل مع هذا المورد بعد 18 شهرًا من النشر في الإنتاج.
أجروا التقييم الذي يتنبأ بأداء الإنتاج
يستطيع كل مورد اجتياز عرض توضيحي، لكن قلة قليلة تستطيع اجتياز تقييم مصمم لكشف ما يحدث مع أحجام عمل حقيقية، وعلى أنظمة حقيقية، وفي ظل مراجعة أمنية حقيقية. استخدموا هذه الأسئلة بطاقةً للتقييم، وشغّلوا إثبات المفهوم على أصعب استفساراتكم، وامنحوا المراجع من بيئات الإنتاج وزنًا أكبر من شارات المحللين. فالفرق التي تلتزم بذلك باستمرار هي التي تظل عمليات نشرها تحقق أداءً جيدًا بعد عام.
اكتشفوا كيف يصمد هذا الإطار أمام حجم التذاكر لديكم. احجز عرضًا توضيحيًا وأحضروا الاستفسارات التي تتوقعون أن تُربكه.
شاهدوه على محادثاتكم الفعلية.
اطلبوا عرضًا توضيحيًا مخصصًا ومجانيًا.


