
لا تفشل معظم مشاريع دعم العملاء بالذكاء الاصطناعي في المؤسسات في مرحلة الفكرة، بل في مكان ما بين إثبات مفهوم ناجح واللحظة التي يتعين فيها على النظام التعامل مع أحجام حقيقية وبيانات حقيقية وعواقب حقيقية.
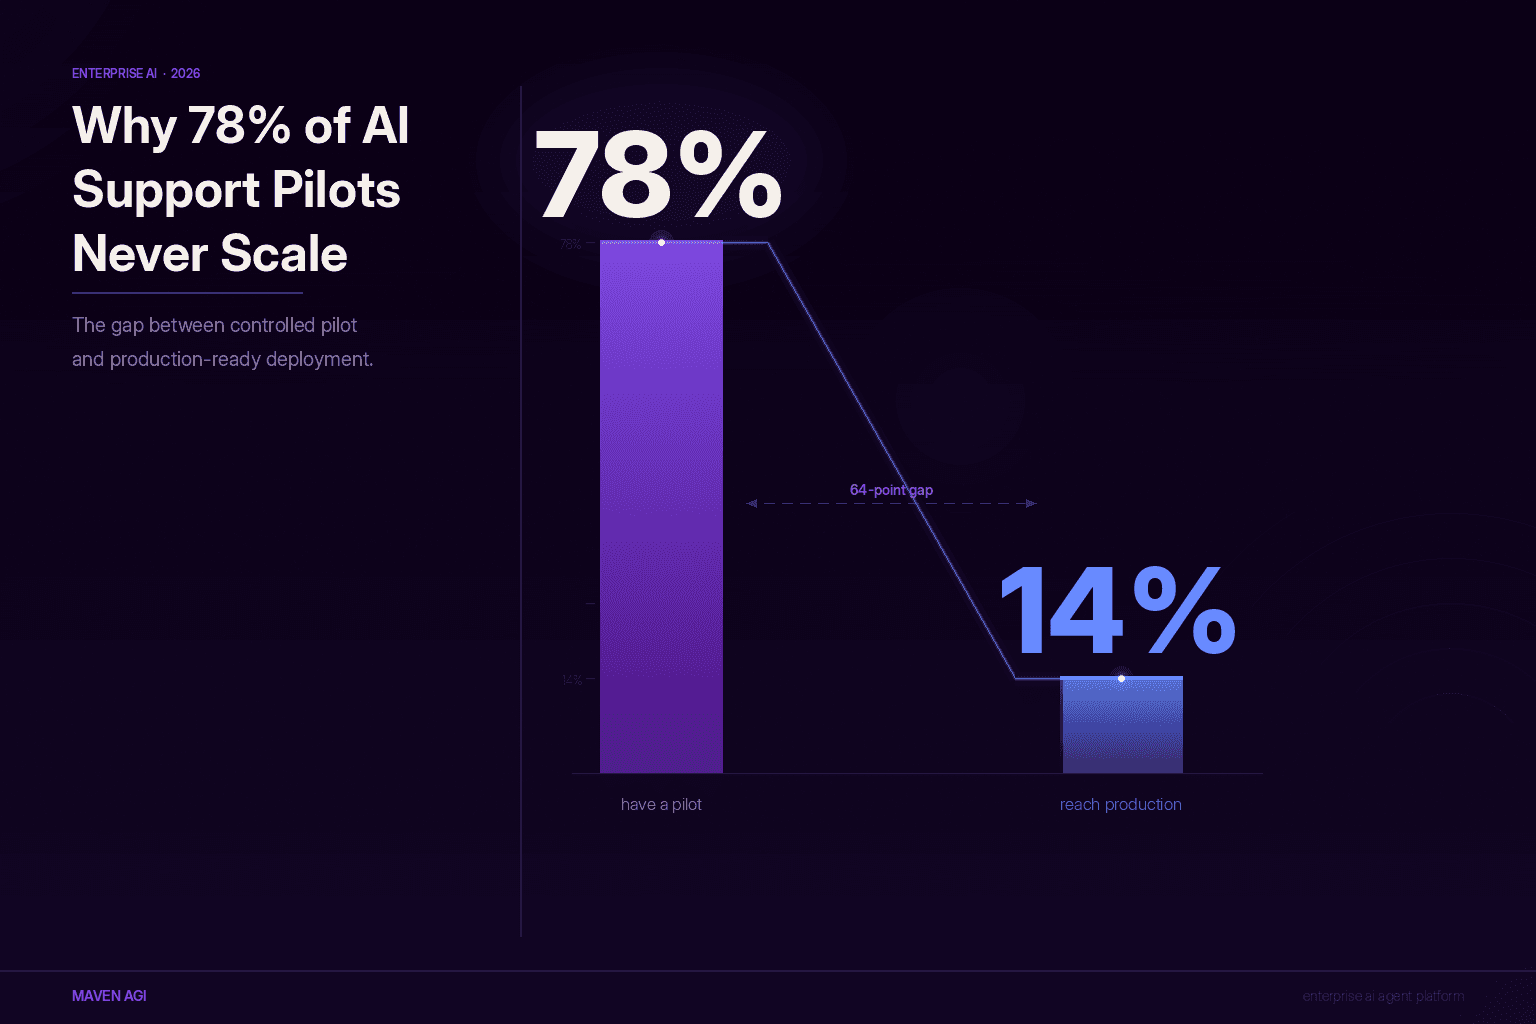
وقد حدّد استطلاع أُجري في مارس 2026 وشمل 650 من قادة التكنولوجيا في المؤسسات حجم هذه الفجوة: 78% من المؤسسات لديها مشروع تجريبي واحد على الأقل لوكيل ذكاء اصطناعي يعمل في بيئة مضبوطة، و14% فقط نجحت في توسيع نطاق وكيل ليُستخدم تشغيليًا على مستوى المؤسسة بأكملها. هذه الفجوة، البالغة 64 نقطة مئوية بين «لدينا مشروع تجريبي» و«لدينا نشر فعلي»، هي المكان الذي تتلاشى فيه معظم ميزانيات الذكاء الاصطناعي بصمت.
والسبب في الغالب ليس الذكاء الاصطناعي نفسه. فالنماذج نضجت، والأدوات تحسّنت. الفجوة تنظيمية وتشغيلية: معظم المؤسسات لا تبني مشاريعها التجريبية بهدف الإنتاج، بل تبنيها من أجل العرض التوضيحي.
ما يختبره العرض التوضيحي مقابل ما يتطلبه الإنتاج
يعمل المشروع التجريبي في ظروف مضبوطة: البيانات نظيفة، والأحجام قابلة للإدارة، والحالات الاستثنائية لم تظهر بعد. وهناك من يراقب كل تفاعل في الفريق، وعندما يتعطل شيء يُصلَح قبل أن يتحول إلى نمط متكرر.
أما الإنتاج فمختلف. فهو يعمل بأحجام كبيرة، وعلى بيانات غالبًا ما تكون فوضوية وناقصة، دون شبكة أمان للتفاعلات الفردية. والحالات الاستثنائية التي لم تظهر قط في المرحلة التجريبية تبدأ بالظهور باستمرار. ووفقًا لـتحليل أجرته Gartner ونشرته CTO Magazine، يُتوقع إلغاء أكثر من 40% من مشاريع الذكاء الاصطناعي الوكيلي بحلول نهاية 2027، لا لأن التقنية لا تعمل، بل بسبب «عدم وضوح القيمة التجارية، وتصاعد التكاليف، وقصور ضوابط المخاطر». وهذه ليست إخفاقات تقنية، بل إخفاقات في بنية النشر.
والمؤسسات التي تنجح في التوسع تشترك في بنية تنفيذ متسقة حتى لو اختلفت حالات استخدامها. وهي لا تكتشف هذه البنية خلال المرحلة التجريبية، بل تبنيها قبل بدء النشر.
الفجوات الخمس وراء معظم إخفاقات التوسع
حدّد استطلاع مارس 2026 خمسة أسباب جذرية تفسّر مجتمعةً 89% من إخفاقات التوسع في عمليات نشر وكلاء الذكاء الاصطناعي في المؤسسات:
- تعقيد التكامل مع الأنظمة القديمة. يؤدي وكيل الذكاء الاصطناعي الذي يستعلم من قاعدة معرفة ثابتة أداءً مقبولًا في العرض التوضيحي. أما الوكيل الذي يتعين عليه الاستدلال عبر نظام CRM ومكتب المساعدة ونظام إدارة الطلبات ومنصة الفوترة في الوقت الفعلي، والكتابة في تلك الأنظمة عند حل مسألة ما، فهو مهمة مختلفة تمامًا. معظم المشاريع التجريبية تختبر الحالة الأولى، ومعظم متطلبات الإنتاج تستلزم الثانية.
- تذبذب جودة المخرجات عند الأحجام الكبيرة. غالبًا ما تُحافَظ على الجودة في المرحلة التجريبية عبر الإشراف. فعندما يراجع شخص كل تفاعل، تُكتشف المشكلات مبكرًا. لكن هذا الإشراف يختفي عند التوسع. وإذا لم يُقيَّم الوكيل بشكل منهجي على كامل نطاق المدخلات التي سيواجهها في الإنتاج، بما فيها غير المألوفة، تتراجع الجودة بطرق لا تظهر إلا عندما يبدأ العملاء بالشكوى.
- غياب أدوات المراقبة. لا يمكنكم تحسين ما لا ترونه. فعمليات النشر التي لا تقيس أداء الوكيل منذ اليوم الأول تميل إلى الركود. وحلقة التغذية الراجعة بين مخرجات الوكيل وتصميم سير العمل هي ما يميّز عمليات النشر التي تتضاعف قيمتها عن تلك التي تتوقف عن التطور.
- غموض المسؤولية التنظيمية. لا بد أن يتولى شخص ما مسؤولية أداء كل سير عمل وكيلي، لا تشغيله التقني فحسب، بل نتائجه التجارية أيضًا. ومن دون مسؤولية واضحة، تتشتت المساءلة، فتستغرق المشكلات التي ينبغي حلها في أيام أسابيعَ، ولا تُنفَّذ التحسينات التي ينبغي أن تكون بديهية.
- نقص بيانات التدريب الخاصة بالمجال. بيانات المؤسسات لا تكون أبدًا مصدرًا واحدًا نظيفًا، فهي موزعة عبر الأنظمة، وغير متسقة في بنيتها، ومتغيرة باستمرار. وفي اللحظة التي تنتقلون فيها من مشروع تجريبي مضبوط إلى الإنتاج، يتفاقم هذا التشتت. فالوكلاء الذين كانوا يستدلون بدقة على مجموعة بيانات منتقاة يبدؤون بمواجهة مستندات متناقضة وسجلات مكررة وسياسات قديمة.
ما تعنيه الجاهزية للإنتاج فعليًا في تجربة العملاء
في مجال دعم العملاء تحديدًا، وجد مؤشر Infor لأثر تبنّي الذكاء الاصطناعي في المؤسسات، الذي استطلع آراء 1,000 من صنّاع القرار في الأعمال في الولايات المتحدة والمملكة المتحدة وألمانيا وفرنسا مطلع 2026، أن أكثر من نصف الشركات تواجه صعوبة في توسيع الذكاء الاصطناعي إلى ما بعد عمليات النشر الأولية. والعوائق التي ذكروها ليست فجوات في القدرات، بل فجوات في التنفيذ.
الجاهزية للإنتاج تعني أن المنصة قادرة على التعامل مع الحجم الفعلي للتذاكر دون تراجع في الجودة. وتعني أن عمليات التصعيد تنقل السياق الكامل إلى الموظفين البشريين بدلًا من فقدان سجل المحادثة عند التسليم. وتعني أن بنية الحوكمة، من سجلات التدقيق ومستويات الصلاحيات وتوجيه الاستثناءات، صُمّمت منذ البداية بدلًا من إضافتها تحت ضغط مراجعة أمنية مؤسسية. كما تعني أن طبقة التكامل تتصل في الاتجاهين بالأنظمة التي يجري فيها عمل الدعم فعليًا: مكتب المساعدة، ونظام CRM، ونظام الفوترة، وقاعدة المعرفة.
وهذا أمر يستحق الفهم إذا كنتم في المراحل الأولى من تقييم حلول دعم العملاء بالذكاء الاصطناعي. فالسؤال ليس فقط ما إذا كانت المنصة تتعامل مع حجم الدعم، بل ما إذا كانت مصممة للعمل في الإنتاج أم مصممة للفوز بعملية شراء. فهاتان فلسفتان مختلفتان في التصميم، وتنتجان أنظمة مختلفة.
المقاييس التي تخبركم ما إذا كنتم على المسار الصحيح
قبل انتقال أي مشروع تجريبي إلى نشر أوسع، هناك ثلاثة مقاييس تميّز الفرق التي تسير نحو الإنتاج عن الفرق التي تبني إثبات مفهوم دائمًا.
الأول هو معدل الحل الذاتي، لا معدل التحويل. فالتحويل يحصي الاتصالات التي أعاد الذكاء الاصطناعي توجيهها إلى موظف بشري، بينما يحصي الحل الاتصالات التي أغلقها الذكاء الاصطناعي. وقد تُظهر المنصة أرقام تحويل قوية في حين يكون معدل الحل الفعلي منخفضًا إلى حد لا يبرر الاستثمار اقتصاديًا.
الثاني هو معدل إعادة الفتح. فالاتصال الذي «يحله» الذكاء الاصطناعي ثم يُعاد فتحه كتذكرة بشرية خلال 24 ساعة لم يُحل، بل أُجّل. ومعظم المنصات لا تعرض هذا المقياس افتراضيًا، ما يعني أن الفرق غالبًا لا تكتشف المشكلة حتى تظهر في مؤشرات رضا العملاء.
الثالث هو الأداء عند الشريحة المئوية الـ90 من تعقيد الاستفسارات، لا عند الوسيط. فالمشاريع التجريبية تُقيَّم عادةً على متوسط الأداء، أما عمليات النشر الفعلية فيتحدد مصيرها بالحالات الاستثنائية. وتقييم المنصة فقط على الاستفسارات التي تتقنها هو ما يقود المؤسسات إلى نشر يعمل مع 60% من الاتصالات ويفشل باستمرار مع الـ40% الأخرى، وهي غالبًا الأكثر أهمية.
وللاطلاع على إطار تقييم أشمل، يتناول مقال كيفية تقييم وكلاء الذكاء الاصطناعي لخدمة العملاء في المؤسسات المعايير المحددة التي تميّز المنصات القادرة على الإنتاج عن تلك المُحسّنة للعروض التوضيحية.
ما الذي يميّز نسبة الـ14% التي تنجح في التوسع
تشترك المؤسسات التي تنجح في الانتقال من المرحلة التجريبية إلى الإنتاج في ممارسات ثابتة قليلة. فهي تبدأ بجاهزية البيانات قبل نشر الوكيل: تدقّق المصادر التي سيعتمد عليها، وتؤسس طبقات تكامل نظيفة، وتتأكد من أن المعلومات التي يصل إليها الوكيل حديثة ومكتملة بما يكفي لدعم استدلال موثوق.
وهي تبني سجلات التدقيق وبنية الصلاحيات قبل توسيع استقلالية الوكيل، لا بعده. فلجان المشتريات والفرق القانونية في المؤسسات تشترط سجلات قابلة للاستعلام لكل إجراء يتخذه الوكيل، وعمليات النشر التي لا تستطيع توفير هذا التوثيق تتعثر عند التعميم الأوسع. وبناؤه منذ البداية أسهل بكثير من إضافته لاحقًا.
كما تختار سير العمل الأول بناءً على الحجم وقابلية القياس، لا على ما يبدو أفضل في العرض التوضيحي. فسير عمل دعم كبير الحجم ومحدد بوضوح، مثل إعادة تعيين كلمات المرور وحالة الطلبات وتعديلات الحسابات، يمنح الوكيل مدخلات كافية لكشف مشكلات الجودة بسرعة وبيانات كافية للتحسين المنهجي. أما البدء بسير عمل معقد وقليل الحجم فينتج نشرًا متذبذب الأداء وصعب التقييم.
فالسؤال حول منصة وكلاء الذكاء الاصطناعي للمؤسسات ليس ما إذا كان وكلاء الذكاء الاصطناعي جاهزين لدعم المؤسسات؛ ففي 2026 أصبحت القدرة متوفرة. السؤال هو ما إذا كانت بنية النشر، من عمق التكامل وبنية الحوكمة وأدوات المراقبة والمسؤولية التنظيمية، قد بُنيت بالمستوى نفسه الذي بُني به النموذج.
معظم المشاريع التجريبية لا تصل إلى هذا الحد. أما تلك التي تصل، فغالبًا ما تصبح عمليات النشر الفعلية التي تستحق التجديد.
شاهدوه على محادثاتكم الفعلية.
اطلبوا عرضًا توضيحيًا مخصصًا ومجانيًا.


